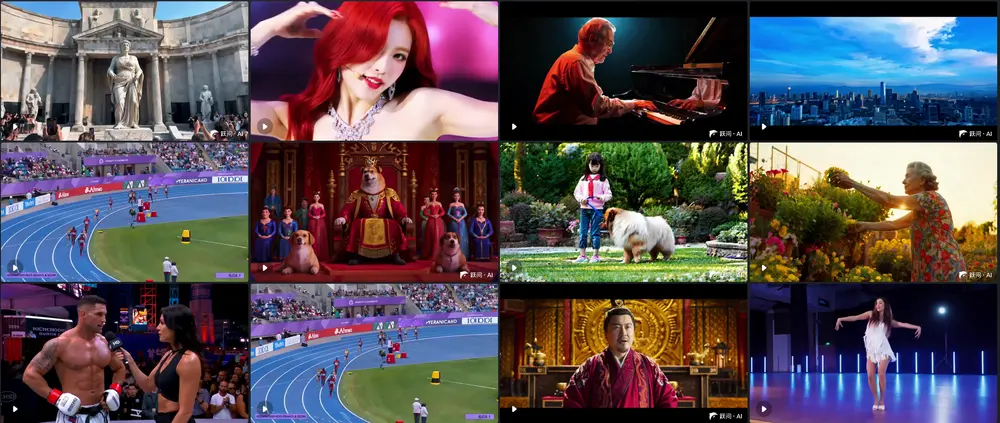
OmniShow 是由 香港中文大学、字节跳动、莫纳什大学 和 香港大学 联合研发的创新性视频生成模型。它专为 人-物交互视频生成 (HOIVG, Human-Object Interaction Video Generation) 设计,通过一个统一的框架,灵活支持文本、参考图像、音频和姿态等多种条件输入,实现了高保真、高同步率的视频生成。
- 项目主页:https://correr-zhou.github.io/OmniShow
- GitHub:https://github.com/Correr-Zhou/OmniShow
OmniShow 不仅是目前唯一支持完整 RAP2V (Reference + Audio + Pose to Video) 设置的模型,还在多项基准测试中取得了 SOTA (State-of-the-Art) 性能。
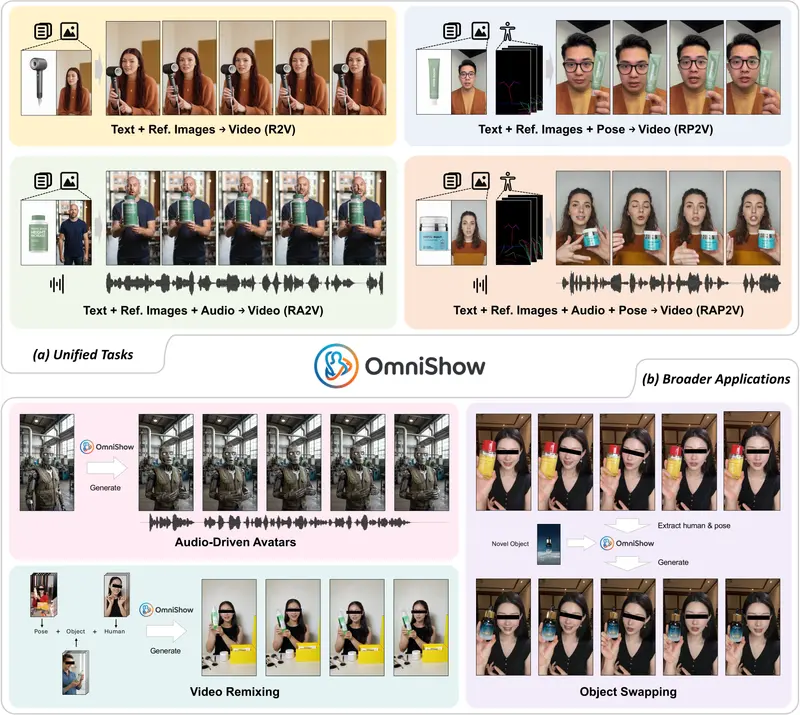
核心亮点
1. 一体化多模态生成
OmniShow 将多种生成任务统一在一个连贯的模型架构中:
- R2V: Reference to Video (参考图生视频)
- RA2V: Reference + Audio to Video (参考图+音频生视频)
- RP2V: Reference + Pose to Video (参考图+姿态生视频)
- RAP2V: Reference + Audio + Pose to Video (全条件生视频)
这种灵活性使其适用于广泛场景,如音频驱动的数字人、物体交换动画、视频混编等。
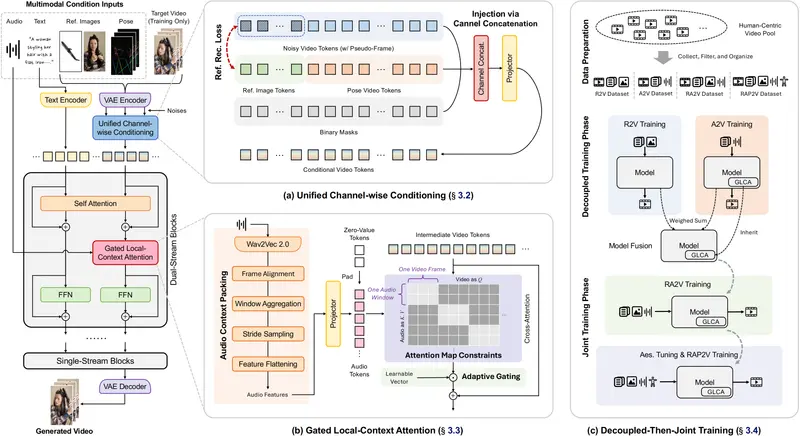
2. 三大技术创新
A. 统一通道式条件注入 (Unified Channel-wise Conditional Injection)
- 机制:通过统一的通道拼接,将参考图像和姿态线索有效注入模型。
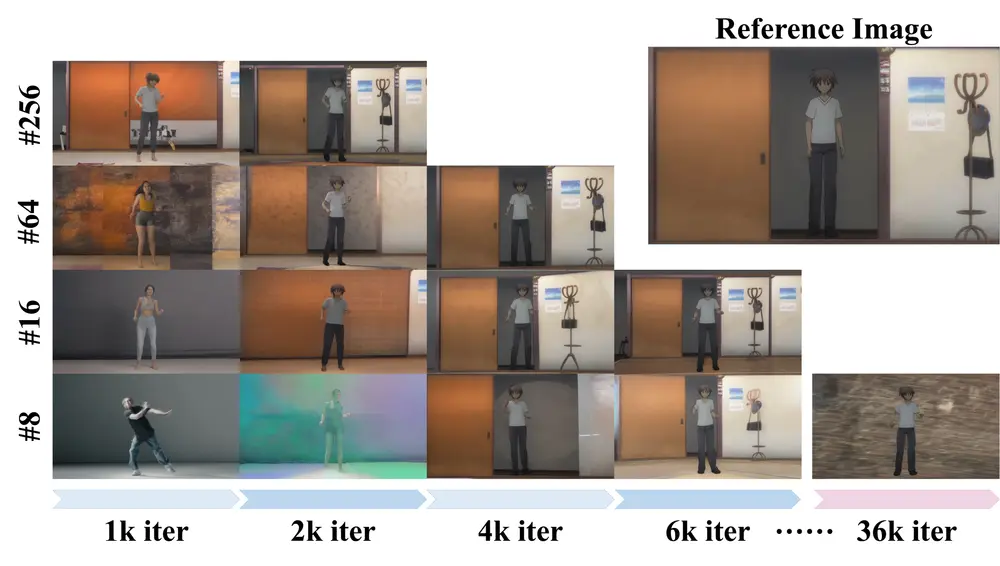
- 增强:使用伪帧增强噪声视频标记,并通过参考重建损失进行监督,确保生成的视频在语义细节上高度保留参考图像的特征(如人物身份、物体外观)。
B. 门控局部上下文注意力 (Gated Local Context Attention)
- 精准同步:专门解决视听同步难题。它将音频特征与充足的局部上下文信息打包,通过掩码注意力注入,使视频帧与对应的音频片段精确对齐。
- 训练稳定:引入自适应门控机制,在训练早期稳定梯度,防止模型发散。
C. 解耦后联合训练 (Decoupled-then-Joint Training)
- 高效利用数据:针对异构数据集(有的只有音频,有的只有姿态),先在独立的子任务数据集上分别训练专门的 R2V 和 A2V 模型。
- 能力融合:通过权重插值将 specialized 模型融合,再进行联合微调,从而统一多模态生成能力,最大化数据利用率。
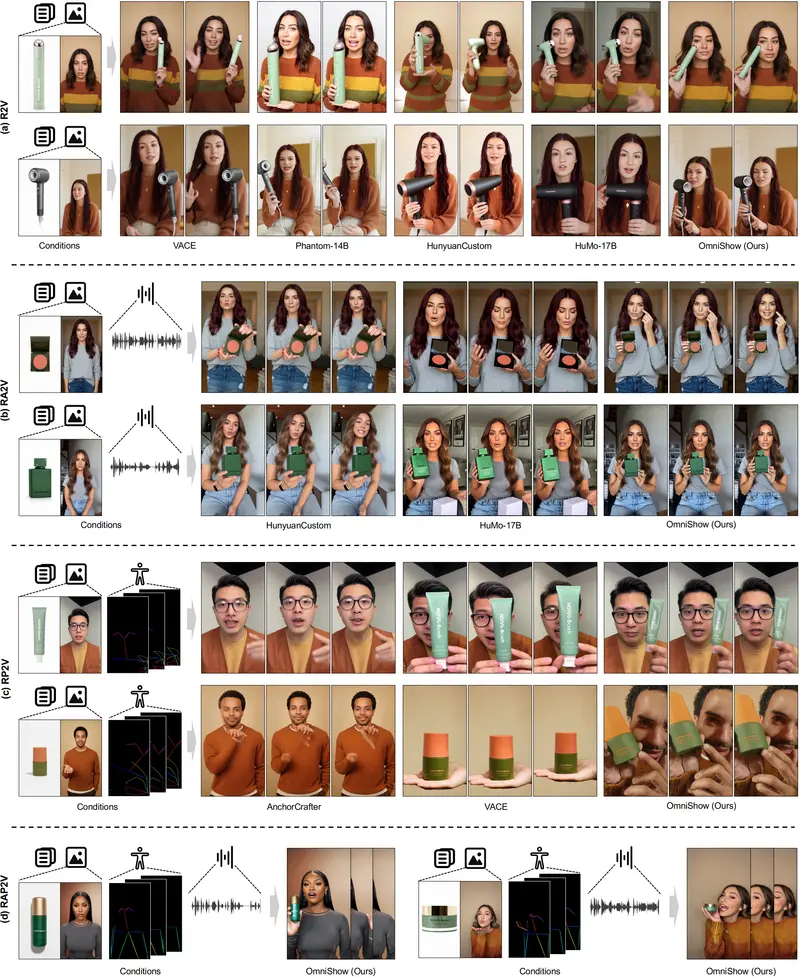
基准评估:HOIVG-Bench
为了系统评估多模态条件下的 HOIVG 性能,研究团队构建了 HOIVBench,包含 135 个精心挑选的样本,涵盖详细的文本描述、人物/物体参考图、语义对齐音频及连贯姿态序列。
1. 参考到视频生成 (R2V)
OmniShow 在保持高面部相似度 (FaceSim) 的同时,取得了最高的视频质量 (VQ) 和运动质量 (MQ)。
| 方法 | FaceSim↑ | VQ↑ | MQ↑ | NexusScore↑ |
|---|---|---|---|---|
| HuMo-17B | 0.843 | 9.97 | 3.685 | 0.346 |
| Phantom-14B | 0.876 | 10.93 | 5.517 | 0.366 |
| OmniShow | 0.874 | 11.12 | 5.885 | 0.389 |
2. 参考+音频到视频生成 (RA2V)
在视听同步指标 (Sync-C, Sync-D) 上,OmniShow 显著优于竞品,同时保持了极高的图像质量。
| 方法 | Sync-C↑ | Sync-D↓ | FaceSim↑ | VQ↑ |
|---|---|---|---|---|
| HuMo-17B | 8.013 | 8.316 | 0.805 | 10.27 |
| OmniShow | 8.612 | 7.608 | 0.810 | 10.86 |
3. 参考+姿态到视频生成 (RP2V)
OmniShow 在姿态跟随精度 (PCK) 和关键点距离 (AKD) 上表现最佳,证明其对复杂动作的控制能力。
| 方法 | PCK↑ | AKD↓ | NexusScore↑ |
|---|---|---|---|
| VACE | 0.336 | 0.206 | 0.352 |
| OmniShow | 0.460 | 0.174 | 0.418 |
注:↑ 表示越高越好,↓ 表示越低越好。
应用前景
凭借强大的多模态控制能力,OmniShow 可广泛应用于:
- 虚拟主播/数字人:通过音频和参考图生成逼真的说话视频。
- 影视后期与特效:基于姿态序列生成特定动作的视频片段。
- 电商展示:生成模特穿戴不同服装或手持商品的动态展示视频。
- 游戏动画:将游戏角色的动作捕捉数据转化为高质量渲染视频。
© 版权声明
文章版权归作者所有,未经允许请勿转载。