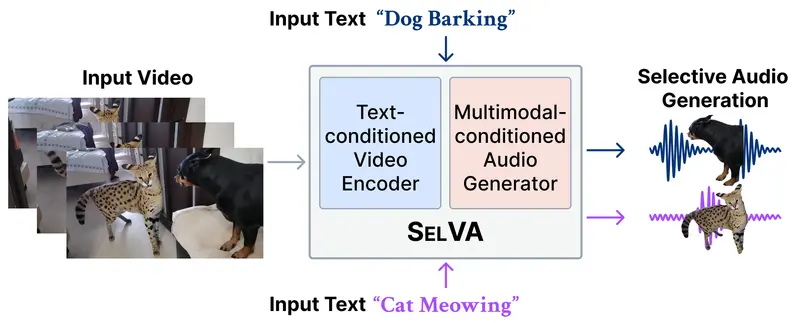
SelVA:基于文本指令的视频选择性配音技术韩国科学技术院(KAIST)MAC 实验室与梨花女子大学 MMAI 实验室的研究人员共同提出了一项新任务:基于文本条件的选择性视频到音频生成(Text-Conditioned Selective Vi...视频模型# SelVA# 配音7个月前1590
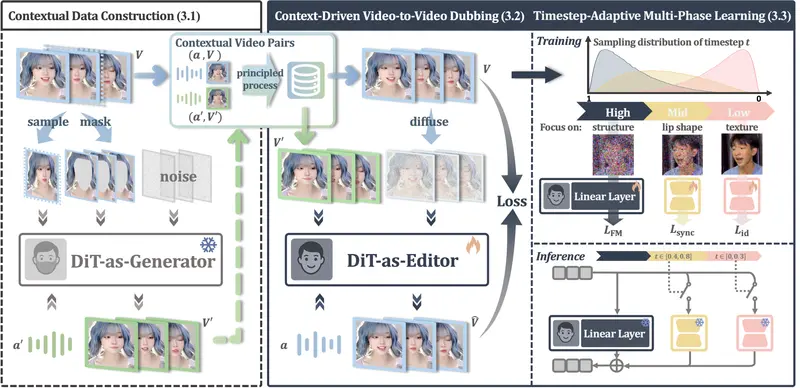
X-Dub:告别“面具式”配音,AI 让视频唇同步更自然逼真在影视翻译、虚拟人互动和短视频创作中,音频驱动的视觉配音(Visual Dubbing)技术至关重要。然而,传统方法长期受困于一个核心难题:缺乏完美的成对训练数据(即除了嘴型不同,其他完全一致的视频...视频模型# X-Dub# 数字人# 配音7个月前2640