ComfyUI-LongCat-Avatar-PixelAILabs 是首个将美团龙猫最新开源模型 LongCat-Video-Avatar 1.6 引入 ComfyUI 生态的自定义节点。它实现了“一张照片 + 一段语音 = 唇形同步说话视频”的极简工作流,支持官方 INT8 量化模型、8 步快速推理以及 DMD/OPSD LoRA 开关,并具备通过逐窗口续接生成任意长度视频的能力。该节点专为高性能显卡(如 RTX 5090)优化,旨在提供高质量、高保真的数字人驱动体验。
- GitHub:https://github.com/Pixelailabs/ComfyUI-LongCat-Avatar-PixelAILabs
美团龙猫发布 LongCat-Video-Avatar 1.6:开源音频驱动视频生成框架,支持超 10 分钟长视频与高保真唇音同步
核心功能与亮点
- LongCat 1.6 原生支持:集成美团最新发布的 1.6 版本模型,相比 1.5 版本在唇部运动自然度、面部表情丰富度及长视频稳定性上均有显著提升。
- 高效推理:支持 INT8 量化模型,配合 8 步采样即可生成高质量视频。提供 DMD/OPSD LoRA 开关,用户可根据需求平衡速度与质量。
- 无限时长生成:采用逐窗口(Window-based)生成机制,每个窗口约 3.7 秒(93 帧),可自动续接生成任意时长的视频,突破显存限制。
- 自动化模型管理:内置模型加载器,首次运行时自动下载缺失的核心组件(包括 INT8 基础模型、LoRA、Whisper 编码器及 VAE),简化部署流程。
- 音频驱动精准同步:集成 Whisper large-v3 进行音频特征提取,确保唇形与语音的高度同步;可选的人声提取功能可处理带背景音乐的音频素材。
硬件要求与性能表现
该节点对硬件配置有一定要求,建议在 RTX 5090 (32GB VRAM) 或同等高端显卡上运行以获得最佳体验。
- 显存占用:在 480p 分辨率下,INT8 模型本身约占 13GB VRAM。若开启
block_num=0(全加载模式)速度更快但需更多显存;推荐保持block_num=1以适配 32GB 显存。 - 系统内存:由于采用流式传输,模型权重需在系统 RAM 中等待加载。建议配备 64GB RAM,32GB 较为紧张。
- 生成速度参考 (RTX 5090, 480p):
- SageAttention + mix_steps 4 (默认): 约 6.6 分钟 / 3.8 秒片段
- SageAttention + mix_steps 0 (极速): 约 5.6 分钟 / 3.8 秒片段 (快 15%,但显存增加)
- 每增加一个窗口(约 3.2 秒音频),耗时增加 1.5 – 2.5 分钟。
安装与部署
1. 安装节点
- ComfyUI Manager: 搜索 Git URL
https://github.com/Pixelailabs/ComfyUI-LongCat-Avatar-PixelAILabs进行安装。 - 手动安装:
cd ComfyUI/custom_nodes
git clone https://github.com/Pixelailabs/ComfyUI-LongCat-Avatar-PixelAILabs
cd ComfyUI-LongCat-Avatar-PixelAILabs
pip install -r requirements.txt
# 推荐安装加速库
pip install sageattention
2. 模型准备
节点会自动下载大部分模型至 models/longcat 目录,但需手动准备文本编码器:
- UMT5 文本编码器: 下载
umt5_xxl_fp8_e4m3fn_scaled.safetensors(推荐 FP8 以节省内存) 或 FP16 版本,放入models/text_encoders。 - 其他模型: 基础模型 (INT8), LoRA, Whisper, VAE 均可由加载器自动下载,或从 Hugging Face (
meituan-longcat) 手动下载对应文件。
3. 加载工作流
拖动 example_workflows/LongCat_Avatar_1.6_PixelAILabs.json 到 ComfyUI 界面即可开始使用。
快速上手指南
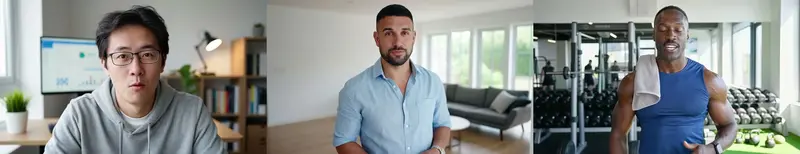
- Load Image: 上传一张清晰的半身或头部照片(胸部以上效果最佳)。
- Load Audio: 上传干净的语音文件(推荐使用 ElevenLabs 等 TTS 生成的单句语音,无背景音乐)。
- Text Encode: 输入简短提示词,描述人物身份、场景及镜头状态(例如:“A professional news anchor, static camera on a tripod”)。
- 运行: 点击生成,视频将保存至
ComfyUI/output/。
关键参数调优
| 参数 | 所在节点 | 推荐设置 | 说明 |
|---|---|---|---|
| attention_mode | 模型加载器 | auto / SageAttention | 优先使用 SageAttention 以获得最佳速度。 |
| mix_steps | 模型加载器 | 4 | 官方 1.6 LoRA 混合步数。设为 0 可提速 15% 但增加显存负担。 |
| resolution | 采样器 | 480p | 720p 速度会慢 3 倍,建议先以 480p 测试。 |
| block_num | 采样器 | 1 | 1 为流式加载,省显存;0 为全加载,速度快但需大显存。 |
使用技巧
- 短测试先行:先用 4 秒音频(一个窗口)测试效果,满意后再生成长视频。
- 保持手部静止:在提示词中加入 “hands relaxed” 或 “hands out of frame”,避免手部动作干扰面部驱动。
- 唇形同步优化:确保音频干净、无混响,且从第一帧开始就有语音输入。
- 种子调整:如果某个镜头效果不佳,尝试更换种子(Seed)而非修改提示词。
ComfyUI-LongCat-Avatar-PixelAILabs 为 ComfyUI 用户提供了一个强大且高效的数字人生成工具,尤其适合需要制作长篇口播视频、虚拟主播内容或交互式对话场景的创作者。
© 版权声明
文章版权归作者所有,未经允许请勿转载。