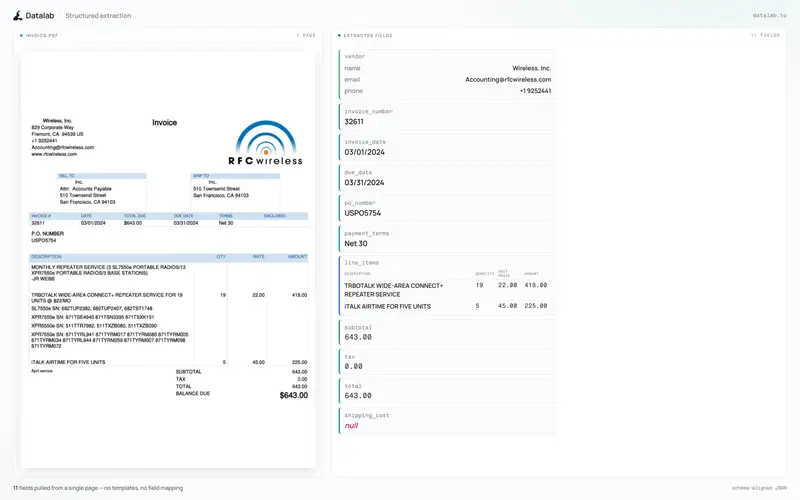
在文档自动化领域,从非结构化的 PDF 和图像中提取精准数据一直是个难题。通用大模型往往会产生“幻觉”或输出格式错误的 JSON,而传统的 OCR 工具又缺乏语义理解能力。Datalab 最新发布的 lift 模型试图在这两者之间找到最佳平衡点:它是一个拥有 90 亿参数的开放权重视觉语言模型,专门用于根据用户定义的 JSON Schema 从文档中提取结构化数据。
- GitHub:https://github.com/datalab-to/lift
- 模型:https://huggingface.co/datalab-to/lift
核心机制:Schema 约束解码与训练性弃权
lift 的最大创新在于其**Schema 约束解码(Schema-Constrained Decoding)**技术。
- 结构强制保证:
lift 不会先生成文本再尝试解析为 JSON,而是将用户的 JSON Schema 编译为严格的语法约束。在生成每一个 token 时,模型只能从符合 Schema 结构的合法 token 中进行采样。这意味着输出的 JSON 永远是语法正确且形状匹配的,彻底消除了因格式错误导致的下游解析失败。 - 训练性弃权(Trainable Abstention):
提取任务中最大的陷阱不是“漏掉”,而是“编造”。lift 被专门训练为:当文档中不存在某个字段时,直接返回null而不是猜测一个值。这种“知之为知之,不知为不知”的能力,对于发票处理、合同审查等对准确性要求极高的场景至关重要。 - 全文档一次性处理:
不同于逐页处理的传统方式,lift 能够一次性读取多页 PDF,并跨页面拼接值(如跨页的表格或条款),确保了上下文的完整性。
性能表现:速度与精度的最佳平衡
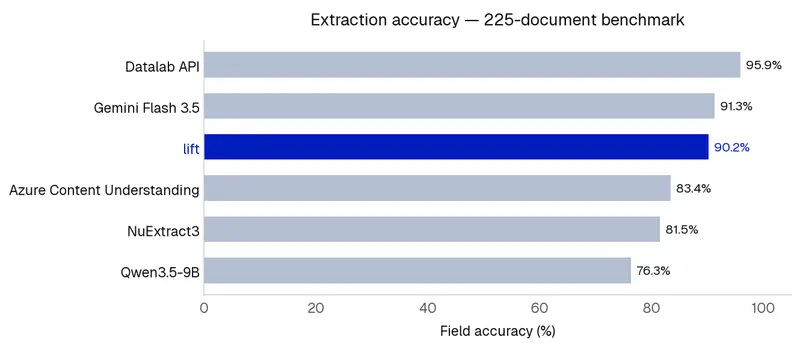
在 Datalab 包含 225 份复杂文档(每份 6-64 页)的基准测试中,lift 展现了惊人的竞争力:
| 模型 | 参数量 | 字段准确率 | 完整文档准确率 | 中位延迟 (秒/文档) |
|---|---|---|---|---|
| Datalab lift | 9B | 90.2% | 20.9% | 9.5 |
| Gemini Flash 3.5 | – | 91.3% | 40.0% | 28.1 |
| Qwen3.5-9B | 9B | 76.3% | 24.0% | 16.8 |
| NuExtract3 | 4B | 81.5% | 8.4% | 8.3 |
- 精度领先:在可自托管的开源模型中,lift 的字段准确率最高,甚至逼近 Gemini Flash 3.5 的水平(差距仅 1.1%)。
- 速度极快:处理一份文档仅需 9.5 秒,比 Gemini Flash 3.5 快约 3 倍,非常适合高吞吐量的生产环境。
- 局限提示:完整文档准确率(所有字段均正确)为 20.9%,这反映了长文档单次提取的高难度。因此,lift 最适合用于辅助人工审核或聚合分析,而非完全无人值守的零接触自动化。
开发者工作流建议
为了最大化 lift 的效果,Datalab 推荐以下最佳实践:
- 精简 Schema:保持 Schema 扁平化,避免深层嵌套。仅将真正必须的字段标记为
required,其余允许返回null。 - 丰富描述:为名称不明确的字段添加详细的
description,这是引导模型准确识别的关键。 - 验证与分支:虽然结构有保证,但含义仍需验证。建议在下游代码中根据 Schema 再次校验返回的 JSON,并将
null值或低置信度结果路由至人工审核流程。 - 注意限制:目前不支持
enum、anyOf/oneOf等复杂构造。如果 Schema 无法编译,模型会回退到无约束生成,此时需格外小心。
许可与部署
- 开源权重:lift 的权重采用修改后的 OpenRAIL-M 许可。免费用于研究、个人使用及年收入低于 500 万美元的初创公司,但禁止用于与 Datalab API 直接竞争的商业服务。
- 代码开源:推理代码采用 Apache 2.0 许可。
- 部署方式:支持通过 HuggingFace 本地运行,或通过 vLLM 服务器进行高性能远程推理。
© 版权声明
文章版权归作者所有,未经允许请勿转载。