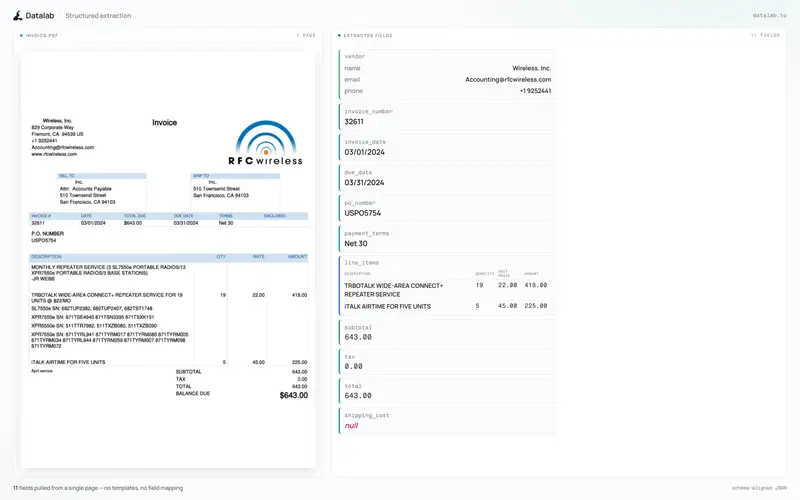
Datalab 发布 lift:9B 开源视觉模型,以 Schema 约束解码重塑 PDF 结构化提取在文档自动化领域,从非结构化的 PDF 和图像中提取精准数据一直是个难题。通用大模型往往会产生“幻觉”或输出格式错误的 JSON,而传统的 OCR 工具又缺乏语义理解能力。Datalab 最新发布的 ...多模态模型# Datalab# LIFT4个月前1550
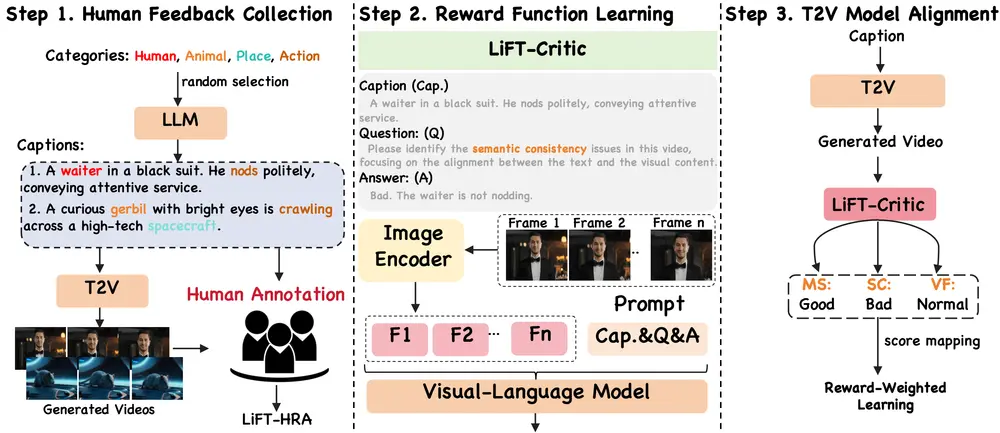
LIFT:利用人类反馈进行文生视频模型对齐的新型微调方法文本到视频(T2V)生成模型近年来取得了显著进展,能够生成高质量的合成视频。然而,这些模型在将合成视频与人类偏好(例如,准确反映文本描述)对齐方面仍然存在不足。复旦大学、上海人工智能科学院和阿德莱德大...视频模型# LIFT# 微调# 文生视频模型2年前4800