在 AI 文档处理领域,一个长期存在的痛点是“上下文断裂”与“性能衰减”。当我们将一本几十页的 PDF 交给 AI 时,它往往只能逐页处理,每翻一页就“失忆”一次;或者随着输出长度增加,速度越来越慢、内存占用飙升。百度研究团队受人类抄书时“工作记忆”机制的启发,推出了 Unlimited OCR(无限 OCR)。这项技术让 AI 能够一次性连续处理数十页甚至整本书的文档,且保持恒定的输出速度与内存占用,同时识别精度不降反升。
- GitHub:https://github.com/baidu/Unlimited-OCR
- ModelScope:https://modelscope.cn/models/PaddlePaddle/Unlimited-OCR
- Hugging Face:https://huggingface.co/baidu/Unlimited-OCR
- Demo:https://huggingface.co/spaces/baidu/Unlimited-OCR
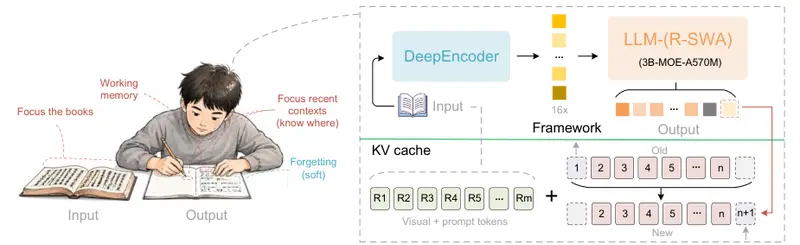
核心突破:从“片段识别”到“长程理解”
Unlimited OCR 并非简单的文字提取工具,而是一个具备长程阅读能力的智能文档解析系统。其核心优势体现在以下四个维度:
- 多页文档一次性处理:打破传统模型逐页割裂处理的限制,可将 20 页、40 页以上的文档一次性输入模型,从头到尾连续识别,中间无断点。
- 长文档恒速输出:无论处理第 1 页还是第 40 页,输出速度始终保持稳定。实验显示,当输出达到 6000 token 时,传统模型速度下降 35%,而 Unlimited OCR 依然恒定。
- 超低且恒定的内存占用:通过创新的注意力机制,内存占用被锁定在一个固定窗口内,不会随文档变长而线性增长,彻底解决“爆显存”问题。
- 精度逆势提升:在大幅降低计算成本的同时,综合识别准确率比基线模型提升 6% 以上,在 OmniDocBench v1.5/v1.6 等权威基准中位列第一。
技术原理:模仿人类的“工作记忆”
Unlimited OCR 的实现依赖于两项关键设计,使其在标准 32K 上下文限制内实现“类无限”处理能力:
1. DeepEncoder:16 倍视觉压缩
文档图片信息量巨大,直接输入会导致算力浪费。Unlimited OCR 使用 DeepEncoder 将 1024×1024 分辨率的图片压缩为仅 256 个 token 的极简描述,压缩比达 16 倍。这些压缩后的视觉信息只生成一次,在整个处理过程中作为全局参考始终保留,避免了重复计算。
2. R-SWA:参考滑动窗口注意力
这是模拟人类“抄书”状态的核心创新。传统模型每生成一个字都要回顾之前所有内容,效率极低。R-SWA 将注意力分为两部分:
- 全局参考区:始终完整保留压缩后的文档图片和提示词,相当于“盯着原书”。
- 局部工作记忆窗口:仅保留最近生成的 128 个 token,用于确认位置和上下文。每生成一个新 token,最老的 token 即被移出窗口。
这种设计使 AI 的记忆负担始终固定,如同一个容量恒定的传送带,新内容进、旧内容出,队列永远满员但不溢出。
性能实测:全面领先的基准表现
在多项权威测试中,Unlimited OCR 展现了压倒性优势:
| 指标 | Unlimited OCR | Baseline (DeepSeek OCR) | 提升幅度 |
|---|---|---|---|
| 综合准确率 (OmniDocBench v1.5) | 93.23% | 87.01% | +6.22% |
| 公式识别准确率 | 92.61% | 83.37% | +9.24% |
| 表格识别准确率 | 90.93% | 84.97% | +5.96% |
| 文字识别错误率 | 0.038 | 0.073 | -47.9% |
| 6000 token 输出速度 | 恒定 | 下降 35% | 快 35% |
即使在处理 40 页以上的超长文档时,错误率仍控制在 0.11 以内,且内容重复度极低,证明模型并未因长文本而“迷失方向”。
应用前景与未来展望
Unlimited OCR 的开源(代码与权重公开)及其轻量级特性(总参数 30 亿,实际激活仅 5 亿),使其在多个领域具有广阔应用空间:
- 学术研究与档案数字化:一次性处理整篇论文或整本书籍,完整保留公式、表格及阅读顺序。
- 法律金融与教育出版:精准解析长合同、财报及含跨页图表的教材,避免上下文断裂。
- 语音识别与长文本翻译:R-SWA 机制可迁移至 ASR 和翻译任务,实现数小时音频转写或整书翻译时的术语一致性。
尽管目前仍受限于 32K 上下文,但研究团队已规划支持 128K 上下文的版本,并探索让模型学会“自动翻页”的机制,以期最终实现物理意义上的“无限 OCR”。这项技术标志着 AI 文档处理从“盲人摸象”迈向“整体理解”的关键一步,让机器阅读真正接近人类的自然体验。
© 版权声明
文章版权归作者所有,未经允许请勿转载。