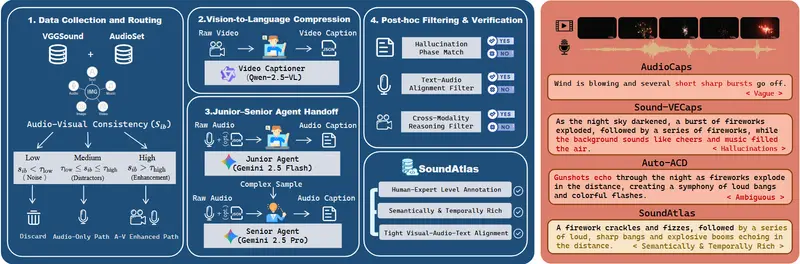
清华 x 生数科技重磅发布 Omni2Sound:一个模型搞定文字、视频音频生成,SoundAtlas 数据集质量超越人工在 AI 视频创作中,配音和音效往往是最后一步,也是最耗时的一步。传统的解决方案通常需要在“文字生成音频”、“视频生成音频”和“图文联合生成”之间切换不同的模型,不仅流程繁琐,还常面临声音不同步、语义...视频模型# Omni2Sound6个月前1980