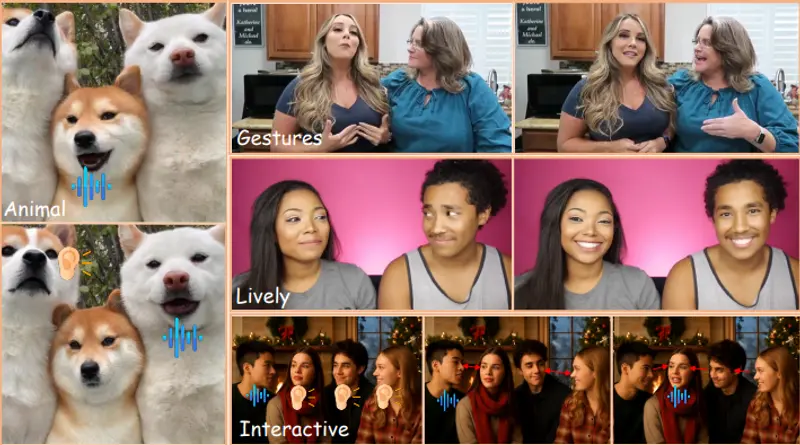
来自俄罗斯Kandinsky Lab正式推出Kandinsky 6.0 Video,这是一套可以文本/图片直接生成同步音视频的扩散模型家族,分为3B参数的Lite轻量版,以及29B参数的Pro高性能版。两个版本原生输出5秒视频片段,附带44kHz同步音频,自带唇形同步能力;搭配独立超分辨率插件,可把画面升级至1080P全高清。
- GitHub:https://github.com/kandinskylab/kandinsky-6
- 模型:https://huggingface.co/collections/kandinskylab/kandinsky-60-diffusers
当前不少AI视频方案存在割裂问题:要么只出无声画面,音频需要后期额外拼接;要么音视频一体模型多为闭源,难以二次研究。而过往开源音视频模型普遍有唇音对不上、音画脱节、分辨率低、显存门槛极高的痛点。
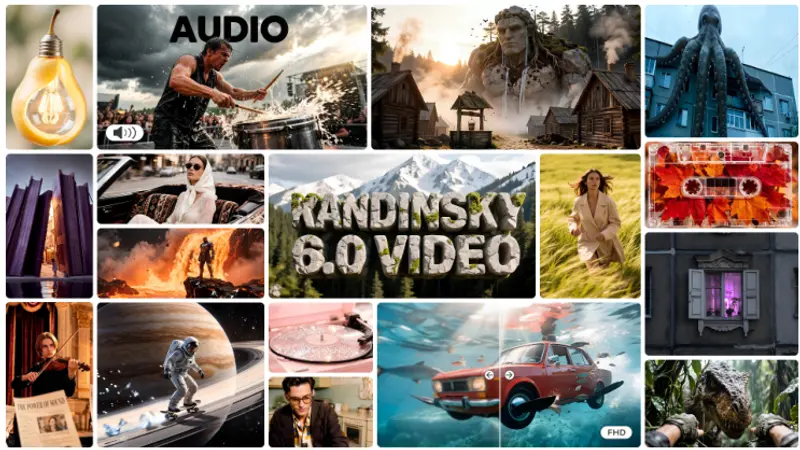
Kandinsky 6.0 Video的核心亮点,就是音视频双主干联合生成,不是视频生成后外挂音频模型,并且做了显存优化,消费级显卡能够本地运行,全部权重与训练代码开源开放。
核心功能
- 文生音视频:输入文本提示词,一次性生成5秒视频+配套语音、背景音乐、环境音效,人物对话场景实现唇形同步。
- 图生音视频:上传图片作为首帧,AI延续画面动态,同步生成匹配音频,让静态图片动态化。
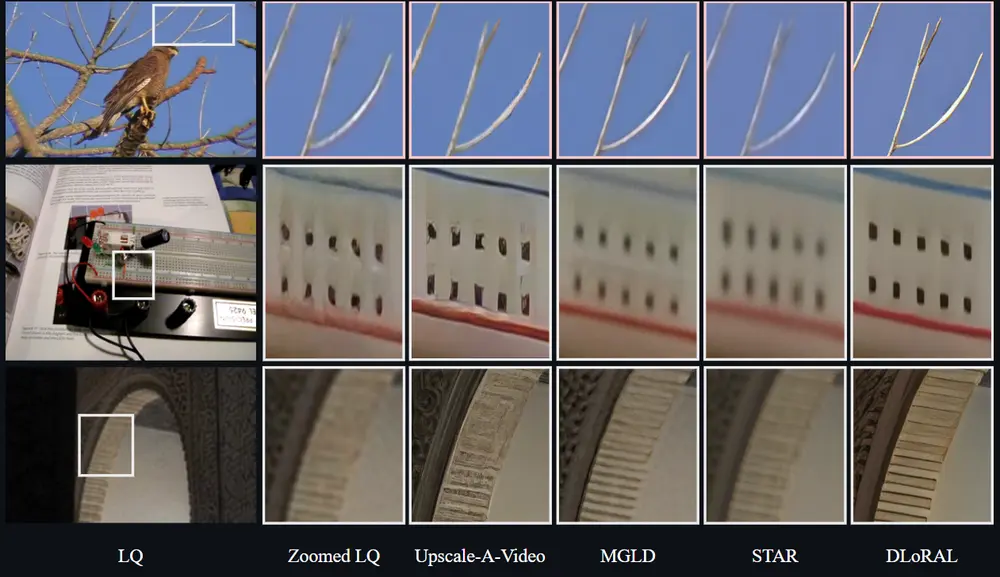
- 多级分辨率输出,配套潜空间超分模块,原生画面可上采样到1080P全高清,减少放大带来的模糊与网格伪影。
- 双模型版本适配算力:Lite(3B)显存门槛更低;Pro(29B)画质、音质、唇同步综合表现更强。依托内存卸载技术,16G/24G/32G消费显卡可本地部署。
- 完整开源:训练代码、模型权重、超分模块全部公开,支持研究者二次微调与深度改造。
局限:单次原生生成仅支持5秒,长视频需要分段拼接;剧烈高速运动画面容易出现物体形变;属于科研原型,距离成熟商用产品仍有差距,复杂多人对话场景偶尔存在音画错位。
架构与训练特点
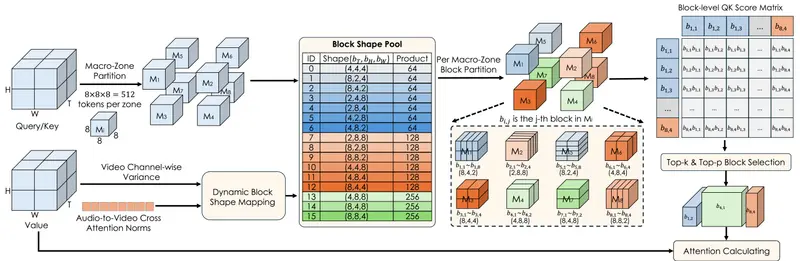
模型采用视频、音频双主干Transformer架构,依靠双向跨模态交互,两条主干可以互相读取对方信息,在生成画面的同时感知音频时序,以此对齐嘴唇动作、画面事件与音效。
训练分为多阶段流水线:视频主干继承Kandinsky5基础能力,音频主干单独预训练;之后进行音视频联合预训练,学习声音和画面时序对应关系;再经过监督微调、多维度打分强化学习、模型蒸馏。强化学习阶段专门针对唇形同步、语音清晰度做重点优化。
超分模块不走普通像素放大,在潜特征空间完成上采样,再送入修复主干降噪,分块重叠处理画面,减少拼接接缝。推理时使用动态显存卸载,仅将当前运算模块载入显存,其余存放于系统内存,降低硬件门槛。
评测与横向对比
评测同时使用VABench自动化指标+真人盲测,从画面真实度、唇形匹配、语音清晰度、音画契合度多维度评估。
Pro版本在唇形同步、语音质量、镜头运动控制上优势明显。和LTX‑2.5相比,唇同步与人声表现更强;对比Kling、Veo、MiniMax H3,开源本地部署是其核心优势,但闭源商业模型在画面细节、音频质感上仍有长处。Lite版本硬件门槛更低,综合效果略弱于Pro,在开源模型中依然具备竞争力。
强化学习环节对唇同步提升显著,去掉该环节后,人物说话嘴部和语音错位问题会明显增多。
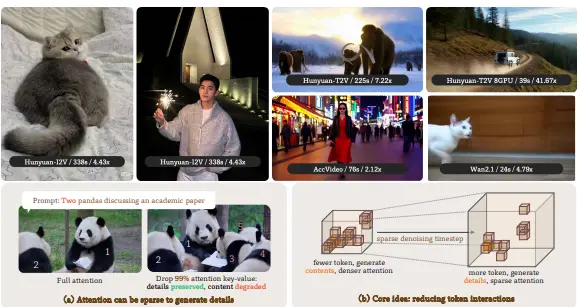
硬件测试:16G显存显卡可运行,但生成速度较慢;专业高算力显卡推理效率更高。蒸馏方案在尽量保留画质音质的前提下,减少采样步数,加速生成。
要点小结
- 产品定位:Kandinsky 6.0 Video,开源音视频一体化扩散模型,3B Lite /29B Pro两个版本,支持文生、图生同步音视频,自带唇形对齐。
- 架构亮点:双主干跨模态联合生成,搭配潜空间超分,不是视频音频分开生成再合并。
- 部署优势:内存卸载,16G消费显卡可本地跑,权重与代码全部开源。
- 短板:固定5秒原生片段,高速运动易崩坏,复杂多人物对话仍存在同步错误。
- 横向差异:强项是唇同步+本地开源部署;商业闭源模型在画面、音频整体质感上各有优势。
© 版权声明
文章版权归作者所有,未经允许请勿转载。