复旦大学、腾讯混元团队与浙江大学联合推出 Prism,一款面向原生2K音视频联合生成的动态稀疏注意力科研框架,解决直接训练2K音视频大模型算力昂贵、音画同步易受损的难题。
- 项目主页:https://francis-rings.github.io/Prism/
- GitHub:https://github.com/Tencent-Hunyuan/Prism
- 模型:https://huggingface.co/FrancisRing/Prism
想要产出2K AI音视频,行业现有两条路线。第一种是先生成低分辨率画面,再通过上采样放大到2K,缺点是细节由算法脑补,复杂动作、纹理极易出现伪影失真;第二种是原生2K训练,模型直接学习高清素材的纹理、动作与嘴声匹配,但传统完整注意力会对画面所有区域均等计算,大量算力浪费在静止背景,训练成本极高,还会稀释运动、发声区域的关键学习信号。
过往稀疏加速方案存在明显短板:部分仅支持推理阶段,无法用于训练;训练可用的稀疏方案大多采用固定尺寸分块。而音视频联合生成有特殊痛点,声音与画面的耦合仅集中在嘴巴、乐器等局部区域,固定切块常会把发声关键点和无关背景划在同一区块,破坏音画之间的对应关系。
Prism 的核心思路是内容自适应动态分块稀疏注意力,不再使用统一固定大小的区块。框架同时参考两项指标:画面局部运动变化剧烈程度,以及音频与画面区域的关联强弱,动态调整时空分块尺寸。运动物体、人物嘴部这类音画强耦合区域使用细小分块精细计算,长时间静止的背景采用大块合并计算,把算力倾斜到信息价值更高的位置。
简单类比:传统完整注意力如同观看画面时,墙壁背景和人物动作投入同等计算资源;Prism更接近人眼观察逻辑,重点区域仔细分析,静态背景快速扫描。
核心功能
- 原生2K音视频联合模型训练:直接基于2K高清音视频素材训练一体模型,画面与音频同步生成,规避上采样带来的虚假纹理、动作失真。
- 音画双信号驱动动态分块稀疏注意力,结合画面运动强度+音视频耦合强度自适应调整块大小,保护发声区域的音画同步学习信号。
- 混合策略区域筛选,保底选取核心区块,同时对信息分散区域自动扩展上下文,平衡速度,避免画面崩坏。
- 模块化接入现有主干,仅替换视频自注意力模块,音频、跨模态模块保持不变,可直接嫁接在LTX‑2.3、Ovi等DiT音视频底座。
- 配套2K‑Bench评测数据集,原生2K实拍素材,覆盖复杂交互、演奏对话场景,用于统一评估2K音视频生成质量。
局限:仅对视频自注意力做稀疏加速,音频分支、跨模态交互保留完整计算;属于科研框架,并非面向普通用户的成品AI生成软件。
主要特点
- 专为音视频联合生成设计,区别于只看画面的普通视频稀疏方案,将音频-画面耦合强度纳入分块决策,保护嘴型、乐器这类声源区域。
- 拒绝一刀切固定切块,在宏观时空区域内部,依据信息丰富度动态选择分块规格。
- 混合查询筛选策略,保底选取+自适应扩展,规避单一策略带来的画质崩溃。
- 原生2K训练路线优于低清生成再放大,复杂动作、手部细节、嘴型对齐质量更强,不会产生上采样幻觉纹理。
- 训练速度对比完整注意力基线提升2.5倍,并且画面清晰度、运动流畅度、音画同步指标同步提升,不是以画质换取加速;模块化改造,接入现有模型成本低。
工作原理
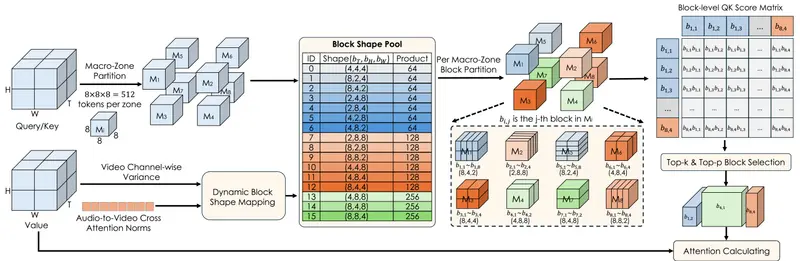
Prism 基于双分支音视频DiT模型改造,只修改视频自注意力,音频与跨模态模块保持完整计算。整套流程分为四步:
- 宏观时空区域划分:将视频的时间、宽高切分为互不重叠的宏观时空区块,分块决策在区域内完成,适配硬件内存读写特性。
- 动态分配分块规格:对每个宏观区域,同时计算画面运动变化程度、音画关联强度,合并得到综合指标。信息丰富区域选用更小分块,静态背景使用大块。
- 混合策略筛选关键块:保底选取高相关性区块,信息分散区域额外扩展参考范围,在控制计算量的同时保留足够上下文。
- 稀疏内核运算,仅对筛选后的区块执行注意力计算,计算完成后还原回原始视频时空排布;推理阶段复用这套动态稀疏逻辑,降低显存开销。
测试结果
团队在自建2K‑Bench与多项通用音视频基准上完成对比实验,同时开展消融研究:
- 相比完整注意力原生2K训练,Prism训练提速2.5倍,画面美学、清晰度、运动流畅度、音画同步全部指标更优;对比低清后上采样方案,人物复杂动作、手部、嘴型对齐优势明显,无虚假纹理。
- 横向对比其他训练型稀疏注意力:固定切块方案容易割裂音画对应关系,消融实验证明,画面运动信号、音频耦合信号二者缺一不可。
- 混合筛选策略优于单纯保底选取或者单纯自适应阈值,取得算力与画质平衡点。
- 在LTX‑2.3、Ovi等多个音视频主干上验证,具备良好通用性。
- 盲测主观评测:在人物交互、乐器演奏等高难度场景,Prism生成的2K视频在动作连贯性、纹理细节、音画匹配上获得更高偏好。
现存局限:仅加速视频自注意力;推理显存压力依然偏高;属于科研原型,不能彻底解决AI视频常见的肢体畸形、细节幻觉等固有缺陷。
硬件显存需求
原生高清训练:720p至少需要32张80GB NVIDIA GPU(A100/H100);1080p与2K训练,至少64张80GB NVIDIA GPU。
推理阶段:720p可在单张80GB NVIDIA GPU运行;1080p、2K推理,需要4张及以上80GB NVIDIA GPU。
© 版权声明
文章版权归作者所有,未经允许请勿转载。