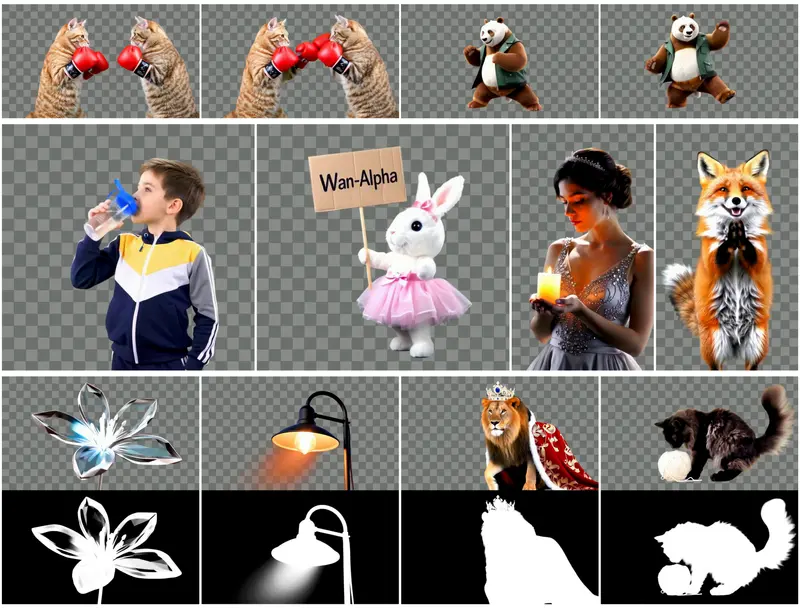
高分辨率视频抠像面临的核心矛盾在于:既要保留发丝、柔和透明度等细微视觉特征,又要维持严格的帧间时序一致性。传统的基于记忆(Memory-based)的方法通过将当前帧特征与早期帧存储的信息进行全局匹配来实现高质量抠像,但随着视频分辨率的提升,这种全量匹配过程的计算成本与显存占用呈指数级增长。
由昆士兰大学、南洋理工大学 S-Lab 与阿德莱德大学联合提出的 MatAnyone-E,作为 MatAnyone 2 的高效扩展版本,通过重构计算资源的分配逻辑解决了这一瓶颈。该方案将计算力集中于最需要精细处理的区域,在保持与原版相当抠像质量的前提下,实现了约 7.4 倍的推理加速,并将 4K 分辨率下的峰值 GPU 内存占用降至原版的 7.6%。
- 项目主页:https://shuyun-wang.github.io/projects/MatAnyone-E/
- GitHub:https://github.com/Shuyun-Wang/MatAnyone-E
核心方法:计算资源的稀疏化分配
MatAnyone-E 保留了 MatAnyone 2 的基础架构,但替换了其中两个计算成本随分辨率增长最快的模块,通过“先粗后细”的策略实现效率跃升。
1. 稀疏记忆传播 (Sparse Memory Propagation)
该机制将匹配过程分为两个阶段,大幅减少了需要详细计算的位置数量和搜索的记忆库规模:
- 低分辨率传递与剪枝:首先执行一次计算成本极低的低分辨率传递。此阶段负责评估全局不确定性,精准挑选出需要详细匹配的查询位置(即查询剪枝),并筛选出与这些位置最相关的记忆候选(即记忆剪枝)。
- 高分辨率局部匹配:高分辨率的精细匹配仅针对上述筛选出的“查询-记忆”对运行。对于其他确定性较高的区域,系统直接重用并上采样低分辨率的匹配读出结果。这种策略在保留生成完整蒙版所需关键信息的同时,避免了冗余的全局高分辨率计算。
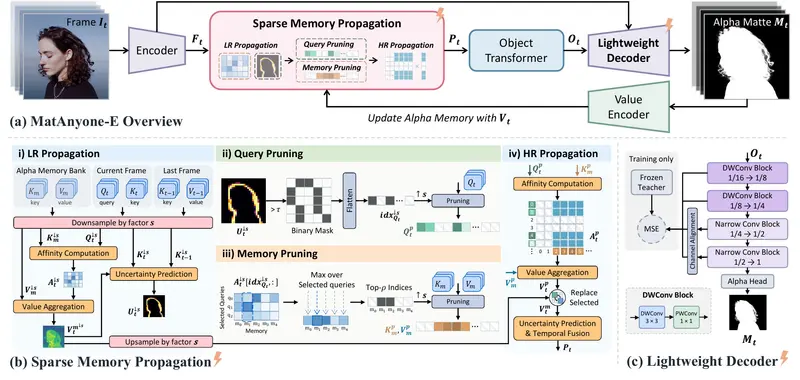
2. 轻量级解码器 (Lightweight Decoder)
为降低生成高分辨率蒙版的最终解码成本,研究团队设计了一个全新的轻量级解码器。该解码器的结构是基于阶段级延迟分析(Stage-level Latency Analysis)专门定制的,并通过知识蒸馏技术,使用原始重型解码器的特征进行训练,从而在大幅降低计算开销的同时,精确重现原始解码器的表示能力。
性能基准与资源消耗分析
在 NVIDIA A800-SXM4-80GB (fp16) 环境下的测试表明,MatAnyone-E 在不同分辨率下均展现出显著的效率优势。随着分辨率的提升,其显存控制与速度优势愈发明显。
| 分辨率 | MatAnyone 2 (FPS) | MatAnyone-E (FPS) | MatAnyone-E + Compile (FPS) | MatAnyone 2 显存 | MatAnyone-E 显存 | MatAnyone-E + Compile 显存 |
|---|---|---|---|---|---|---|
| 1024×1024 | 29.5 | 41.3 | 47.3 | 1.60 GB | 0.92 GB | 0.61 GB |
| 1920×1080 | 13.6 | 26.6 | 37.6 | 5.47 GB | 1.66 GB | 1.07 GB |
| 2560×1440 | 5.6 | 16.5 | 25.1 | 16.20 GB | 3.04 GB | 2.02 GB |
| 3840×2160 (4K) | ~1.1 | 8.1 | 13.6 | ~79.69 GB | 6.08 GB | 3.89 GB |
注:3840×2160 分辨率下 MatAnyone 2 的数据为外推值,因为其完整的记忆库已无法装入 80 GB 显存中,而 MatAnyone-E 仍可稳定运行。
极端硬件下的性能表现:
在配备 torch.compile 的单块 NVIDIA H200 GPU 上,该模型的推理性能进一步释放:
- 1080p (1920×1080):达到 73.07 FPS,满足实时视频流处理需求。
- 4K (3840×2160):达到 28.62 FPS,实现了高分辨率视频抠像的准实时处理。
工程总结
MatAnyone-E 的成功在于其务实的工程取舍:不盲目追求全局的高分辨率计算,而是通过“低分辨率探路 + 高分辨率定点打击”的稀疏记忆传播机制,配合蒸馏优化的轻量级解码器,精准击中了高分辨率视频处理中的显存与算力瓶颈。对于需要在消费级或单卡服务器环境下处理 1080p 乃至 4K 视频抠像任务的开发者而言,该方案提供了目前最具可行性的开源技术路径。
© 版权声明
文章版权归作者所有,未经允许请勿转载。