VDN‑Minimax‑H3:VideoDeltaNet 适配 MiniMax‑H3,伯克利团队推出混合注意力加速方案,8卡B200仅11.23秒产出14.4秒768p视频,实现超实时生成
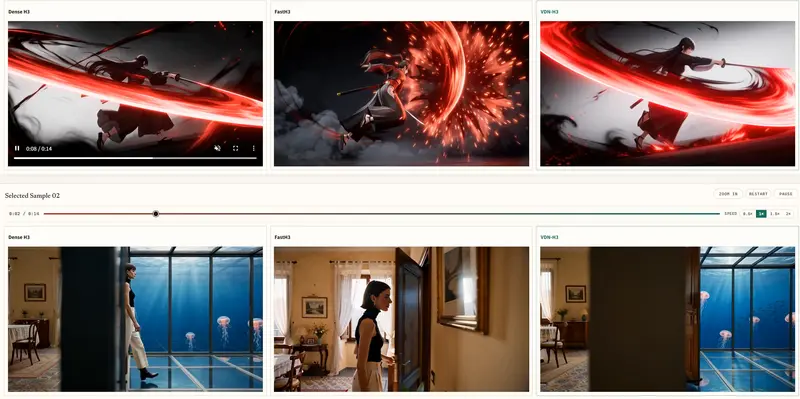
由加州大学伯克利分校、Impossible, Inc、德克萨斯大学奥斯汀分校三方组成的研究团队正式发布 VDN‑Minimax‑H3(VDN‑H3),一套基于MiniMax H3基座打造的混合注意力加速模型。在8张英伟达 B200显卡的硬件条件之下,该方案仅耗时11.23秒即可完成一段14.4秒时长768p视频的生成,生成速度快过视频本身的播放时长,达成超实时文本转视频能力,并且能够做到加速之后视觉质量近乎无损。
- 项目主页:https://openvdn.github.io/
- GitHub:https://github.com/OpenVDN/vdn-minimax-h3
- 模型:https://huggingface.co/OpenVDN/vdn-minimax-h3
VDN‑H3四大核心特性
- 超快速推理性能
依托8步去噪流程,在8张B200 GPU集群上生成一段14.4秒的视频片段仅需要 11.23秒,生成耗时短于视频播放时长,支持持续流式输出高质量视频内容。
- 创新混合注意力架构
模型内部包含两条并行分支:一条高效的逐帧线性注意力分支负责提速;另一条Softmax分支专门用来守住主干模型原本的画面品质、保证跨帧之间画面主体一致性,兼顾速度与画质。
- 即插即用无需改动主干权重
提供的权重文件只新增一条独立的线性注意力分支,外加两个小型LoRA适配器。推理阶段直接将新增模块合并进原有MiniMax‑H3主干网络即可运行,不需要修改、覆盖原始主干模型权重,对原有工作流侵入性极低。
- 完整开源交付
项目不仅仅开放加速之后的模型权重,推理优化代码栈以及整套对应的训练代码也全部对外开源,开发者可以复现加速效果或是基于这套混合注意力方案继续二次迭代优化。
Video DeltaNet技术背景:解决长视频注意力开销痛点
在MiniMax‑H3这类全能视频生成大模型当中,Softmax注意力运算占据了模型整体运行耗时的85%以上,长视频生成时超长token序列带来的二次方算力开销,是限制生成速度最主要的瓶颈。
过去大型语言模型常用的提速思路,是将标准Softmax注意力替换成线性注意力,以此规避二次复杂度开销换取推理速度。但是单纯的线性注意力方案存在明显短板,在长序列生成任务中很难稳固地保留全局特征,很容易出现物体身份漂移、场景布局错乱、跨帧时间连贯性断裂等一系列画质问题。
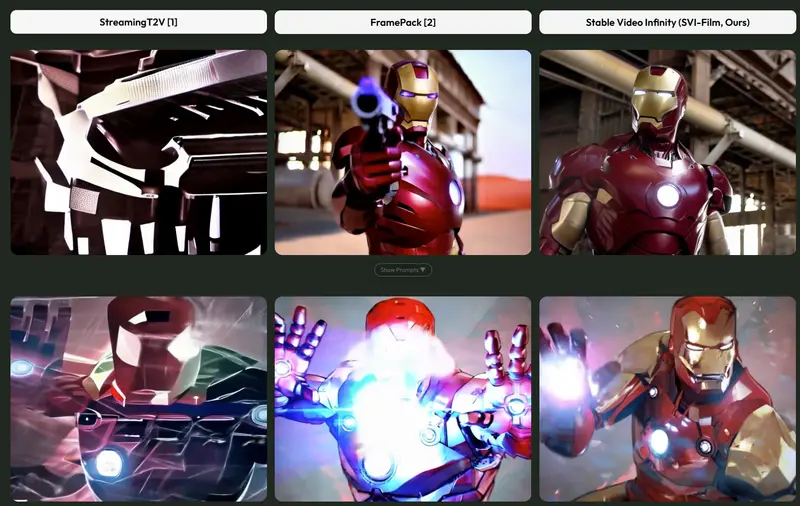
本次研究团队提出的 Video DeltaNet(VDN)混合注意力架构,目标就是做到速度接近纯线性注意力,同时生成画质做到近乎无损。研究人员将这套架构直接迁移适配至MiniMax H3基座,训练出VDN‑H3。实测结果显示,加速后产出的视频在视觉层面几乎无法和原版MiniMax‑H3做出区分;相较于另一套知名加速方案MiniMax FastH3,VDN‑H3在画面质量、提示词指令遵循能力两个维度上都有着更好表现。在8卡B200环境下,这套方案已经可以实现不间断流式生成H3品质的视频内容。
双分支工作原理:局部Softmax + 长程线性记忆
Video DeltaNet将视频注意力计算拆分为两条互补、互不重叠的运算分支,各司其职完成不同距离区间帧之间的关联计算。
双向滑动窗口Softmax分支
专门处理相邻帧之间的局部注意力,保留画面精细细节,保障短时间范围内物体运动的稳定性。实现方案延续H3原本的架构习惯,将连续5个潜变量帧打包成为一个块;每一个帧块的注意力范围覆盖自身、前一个块以及后一个块。
团队额外为Softmax分支加入了4路边界锚点增强机制,以此改善长距离视频生成当中的全局一致性。每一帧都会和首帧、尾帧当中全部token建立注意力连接;同时首帧与尾帧反过来也会关注视频当中其余所有帧。该增强设计仅仅带来 3.57% 的注意力密度增量,就大幅降低了长视频生成过程当中人物、物体漂移崩坏的风险。
双向线性注意力分支
远距离、超出滑动窗口覆盖范围的上下文内容,全部交由双向线性注意力进行处理。
对于任意一帧i,前向状态负责汇总滑动窗口之前所有历史帧的信息;反向状态汇总窗口之后后续帧的信息。两条线性分支负责的时间区间互不重叠,也不会重复计算滑动窗口Softmax、边界锚点已经覆盖过的视频帧。查询向量能够同时读取双向线性状态输出,最后将结果相加,全程不存在重复运算。
通过这种任务划分,把高成本Softmax运算限制在小范围局部窗口之内,超长距离的时序关联交给低成本的线性注意力完成,从而实现整体推理速度大幅跃升。
© 版权声明
文章版权归作者所有,未经允许请勿转载。