在流式视频编辑领域,长期以来存在两个难以调和的矛盾:一是编辑后的背景随时间推移容易出现闪烁或漂移;二是为了实现高质量编辑,模型往往需要双向注意力机制,导致延迟过高,无法满足实时交互需求。
- 项目主页:https://live-edit.github.io/
- GitHub:https://github.com/cp-cp/LiveEdit
- 模型:https://huggingface.co/cp-cp/LiveEdit
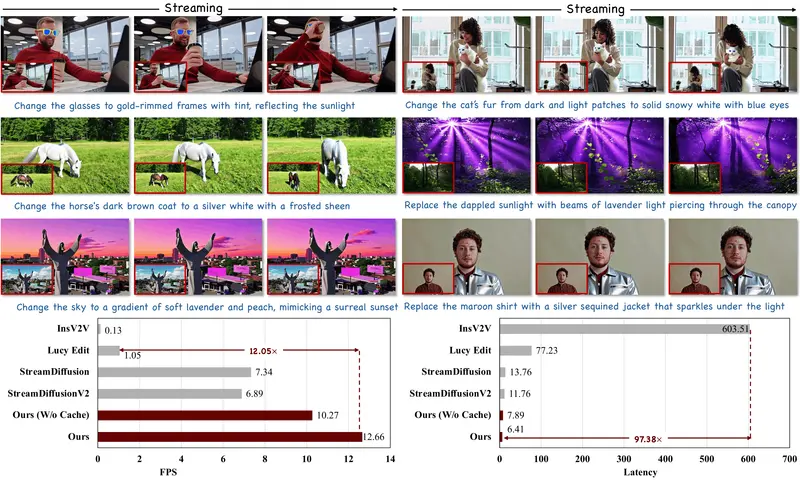
清华大学和香港科技大学的研究团队提出的 LiveEdit,这一个基于扩散模型的流式视频编辑框架,它通过三阶段蒸馏流水线,将强大的双向编辑能力迁移到高效的单向流式编辑器中,并结合 AR 掩码缓存技术,实现了 12.66 FPS 的实时推理速度,同时在背景和未编辑区域保持了极强的源内容保留能力。
核心突破:从“合成”到“编辑”的范式转变
现有的流式视频生成方法大多是为“无中生有”的合成任务设计的,当应用于需要严格保留原始内容的编辑场景时,往往会出现背景崩坏或区域失控的问题。LiveEdit 专门针对编辑任务进行了优化:
- 因果逐块推理:采用单向因果注意力机制,支持逐帧、逐块的流式处理,无需等待未来帧即可输出当前编辑结果。
- 强源保留能力:通过专门的训练策略,确保未编辑区域和背景在长时间序列中保持高度稳定,避免了传统流式方法常见的时序不一致问题。
- 实时低延迟:通过 DMD 蒸馏将生成步骤压缩至 4 步,配合掩码缓存机制,大幅降低了计算冗余。
三阶段蒸馏流水线:把“重”模型变“轻”
LiveEdit 的核心创新在于其独特的知识迁移路径,将双向教师模型的能力高效传递给流式学生模型:
| 阶段 | 目标 | 关键技术 |
|---|---|---|
| 阶段 1:基础调优 | 赋予双向 Transformer 强大的编辑先验 | 使用全时域注意力学习高保真编辑能力,建立高质量的编辑基准。 |
| 阶段 2:因果适应 | 从双向过渡到单向流式处理 | 引入教师强制(Teacher Forcing),在流式约束下保持编辑质量不退化。 |
| 阶段 3:DMD 蒸馏 + 缓存 | 实现实时推理速度 | 将扩散步骤压缩至 4 步;重用掩码背景 token,避免对未变化区域的重复计算。 |
AR 掩码缓存:让计算只花在“刀刃”上
为了进一步支撑实时部署,LiveEdit 引入了面向 AR(Auto-Regressive)的掩码缓存机制。该机制能够智能识别哪些区域是未编辑的背景,哪些是需要重新生成的编辑区域:
- 跨帧重用:对于连续帧中未发生变化的背景 token,直接复用上一帧的计算结果,跳过冗余的去噪过程。
- 区域感知:仅对文本指令指定的编辑区域进行完整的扩散生成,大幅减少了每帧的实际计算量。
- 质量无损:缓存机制仅作用于确定不变的背景区域,编辑区域的生成质量不受影响,实现了速度与视觉质量的平衡。
性能表现:SOTA 质量与实时速度的统一
广泛的评估表明,LiveEdit 在流式视频编辑基线中达到了最先进的质量水平,同时推理速度达到 12.66 FPS,满足了实时交互场景的基本门槛。相较于依赖双向注意力的传统编辑模型,LiveEdit 在保持编辑效果的同时,延迟降低了数个数量级;相较于其他流式生成方法,其在背景稳定性和编辑精确度上具有显著优势。
技术基础与开源
LiveEdit 基于 Wan2.1 和 Self-Forcing 代码库构建,继承了两者在视频生成和自回归推理方面的优秀特性。研究团队已开源相关代码与模型权重,为社区提供了首个真正面向实时编辑场景的流式视频编辑基座。
© 版权声明
文章版权归作者所有,未经允许请勿转载。