阿里巴巴通义千问团队正式发布了 Qwen3.8-Omni-Flash,号称业界首个围绕 Agent(智能体)能力 构建的全模态模型。该模型能够同时理解文本、图像、音频和视频,并通过内置的推理与工具使用能力,执行复杂的跨模态任务。
- 项目主页:https://qwen.ai/blog?id=qwen3.8-omni-flash
- Qwen-MM-Plugins:https://github.com/QwenLM/Qwen-MM-Plugins
- API:https://help.aliyun.com/zh/model-studio/qwen-omni
尽管底层架构基于开源的 Qwen3.8-Flash-Next,但 Qwen3.8-Omni-Flash 目前仅以 托管 API 形式提供,暂未开放权重下载。
核心特性:代理驱动的全模态理解
1. 代理型感知 (Agentic Perception)
与传统视频模型“从头到尾”读取所有帧不同,Qwen3.8-Omni-Flash 采用**“从粗到细”**的主动探索策略:
- 规划与聚焦:模型根据用户问题,自主决定需要观看或聆听哪些片段。
- 证据收集:通过多轮迭代,将计算资源和 Token 集中在关键信息上。
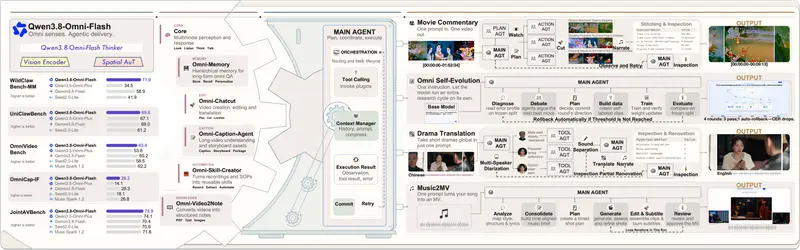
- 效果显著:在 OmniVideoBench 测试中,准确率从 63.4 提升至 67.8,同时 Token 消耗减少约 45.7%(从 14.5 万降至 7.9 万)。
2. 百万级上下文窗口
- 输入上限:支持高达 991K 的输入 Token。
- 输出上限:支持高达 131K 的输出 Token。
- 最大推理长度:262K Token。
- 这使得模型能够处理长达 2 小时 的视频或 3 小时 的音频文件,并从中提取深层逻辑。
3. 原生工具使用与思考
- 默认开启思考:
reasoning_effort默认为xhigh,确保复杂任务的逻辑严密性。 - 功能调用:支持函数调用、网页搜索、结构化输出及上下文缓存。
- 输出格式:目前仅输出文本。若需生成语音,官方建议搭配 Qwen3.5-Omni 使用。
性能基准:对标 Gemini 3.8 Flash
根据阿里官方数据,Qwen3.8-Omni-Flash 在多项权威评测中表现优异:
| 评测基准 | 提升幅度/得分 | 备注 |
|---|---|---|
| 综合平均分 | +25% | 相比 Qwen3.5-Omni-Plus |
| WildClawBench-MM | +36.5 分 | 多模态指令遵循 |
| AgenticVBench | +22.3 分 | 代理视频理解 |
| UniClawBench | 69.6 分 | 统一多模态理解 |
| OmniVideoBench | +9.6 分 | 长视频理解 |
| LongAudioSpan | +8.3 分 | 长音频跨度理解 |
注:官方称其音视频性能接近 Gemini 3.8 Flash,且在整体音频性能上略胜一筹。
极致性价比:成本降低超 90%
Qwen3.8-Omni-Flash 在保持高性能的同时,大幅降低了多媒体处理的成本:
- API 定价:
- 输入:$0.15 / 百万 Token
- 输出:$0.47 / 百万 Token
- 缓存命中:$0.016 / 百万 Token
- 成本对比:
- 音频输入每小时成本降低 98% 以上。
- 音视频输入每小时成本降低 93% 以上。
部署与生态支持
1. 访问方式
- 平台:QwenCloud、阿里云 Model Studio、Qwen Studio。
- 协议:兼容 DashScope 和 OpenAI API 协议(Chat Completions & Responses API)。
- 区域:北京、新加坡、香港、东京、法兰克福、弗吉尼亚。
2. 开源插件:Qwen-MM-Plugins
为了弥补主模型仅输出文本的限制,阿里开源了 Qwen-MM-Plugins (Apache-2.0),帮助代理框架原生支持多模态输入:
- omni-memory:构建长视频的音视频记忆库。
- omni-video2note:将教程视频自动转化为带插图的 PDF 笔记。
- omni-chatcut:支持音乐 MV 生成、电影评论分析及保留说话人身份的视频翻译。
- 兼容性:支持 Claude Code, Codex, Qoder, OpenClaw 等主流 Agent 框架。
3. 技术限制
- 视频:最大 2 小时 / 2GB,建议采样率 15 fps。
- 音频:最大 3 小时,支持 113 种语言/方言,支持双声道及四声道空间音频。
- 音频输入路径:目前大多数框架无法将音频直接馈送给主模型,需通过 API 路由处理。
© 版权声明
文章版权归作者所有,未经允许请勿转载。