在多模态大语言模型(MLLM)领域,如何平衡模型规模、推理成本与复杂任务处理能力一直是行业痛点。近日,阿里国际正式推出 Ovis2.6-80B-A3B,这是 Ovis 系列的最新重磅升级。
- 模型:https://huggingface.co/AIDC-AI/Ovis2.6-80B-A3B
基于 Ovis2.5 的坚实基础,Ovis2.6 首次将大语言模型主干升级为混合专家(MoE)架构,在保持 800 亿总参数庞大知识库的同时,仅激活约 30 亿参数进行推理。这不仅大幅降低了服务成本,更引入了革命性的**“图像协同思考”**能力,让 AI 从被动接收视觉信息转向主动分析与推理,在长文档理解、高分辨率图像处理及复杂视觉推理任务中表现卓越。
核心亮点:MoE 高效、主动思考、极致细节
1. 混合专家架构:800亿参数知识,30亿参数推理
- 超大容量:总参数量达 800 亿,能够捕获海量的世界知识与细微差别,确保在复杂任务中的泛化能力。
- 极致高效:推理期间仅激活约 30 亿 参数(Active Parameters)。
- 低成本:显著降低算力消耗与服务成本。
- 高吞吐:提升并发处理能力,适合大规模商业部署。
- 性能不打折:在保持高效的同时,实现了与全量激活模型相当的卓越多模态性能。
2. 图像协同思考 (Image Collaborative Thinking)
- 从被动到主动:打破传统 MLLM “看图说话”的被动模式,将视觉转化为主动认知工作空间。
- 工具调用与自我反思:在推理过程中,模型可主动调用视觉工具(如裁剪、旋转、放大),对图像特定区域进行重新检查与分析。
- 多轮思维链:支持在思维链(CoT)中进行多轮、自我反思式的视觉输入推理,显著提升复杂视觉任务(如几何题、复杂图表分析)的准确性。
3. 长上下文与高分辨率突破
- 64K 超长上下文:支持长达 64K token 的上下文窗口,轻松处理长篇文档、多页报告或长视频帧序列。
- 2880×2880 超高分辨率:原生支持高达 2880×2880 的图像分辨率,保留微小文字与细节特征。
- 信息密集型任务专家:特别优化了长文档问答能力,模型能跨页面收集并整合分散线索,得出精准结论。
4. 增强的 OCR 与图表理解
- 结构化信息提取:在光学字符识别(OCR)、文档布局分析及图表/图示理解方面大幅增强。
- 推理而非仅识别:不仅能准确提取文字与数据,更能对提取内容进行逻辑推理(如趋势分析、数据对比),适用于金融报表、科学图表等复杂场景。
性能表现
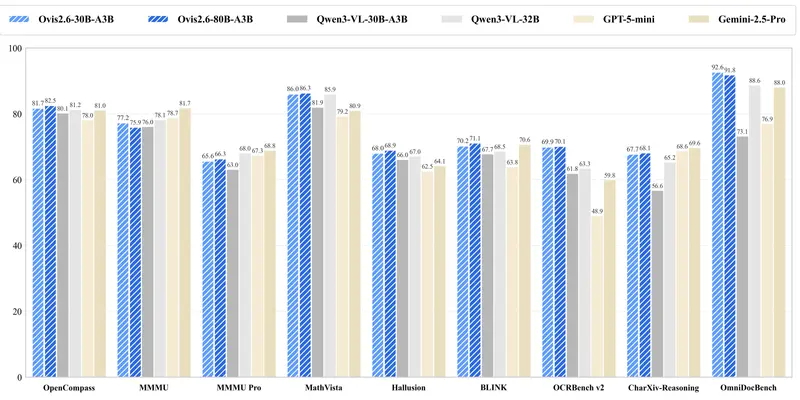
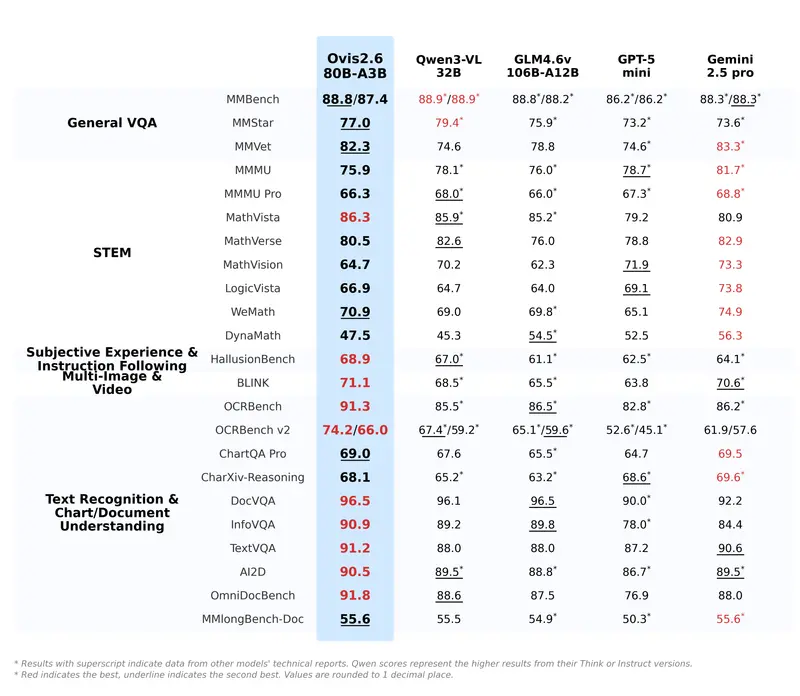
Ovis2.6-80B-A3B 在多个权威基准测试中取得了领先成绩,尤其在需要高分辨率、长上下文及复杂推理的任务中表现突出:
| 能力维度 | 关键指标/表现 | 说明 |
|---|---|---|
| 综合多模态 | SOTA 级别 | 在 MMBench, MMStar 等基准中表现优异 |
| 文档理解 | 显著提升 | 长文档问答准确率大幅超越前代及竞品 |
| OCR/图表 | 高精度 | 复杂表格、数学公式、科学图表解析能力增强 |
| 推理效率 | 极高性价比 | 激活参数仅 3B,推理速度与传统 7B-14B 模型相当 |
| 视觉推理 | 主动式增强 | 通过工具调用解决传统模型无法处理的细节问题 |
技术架构简析
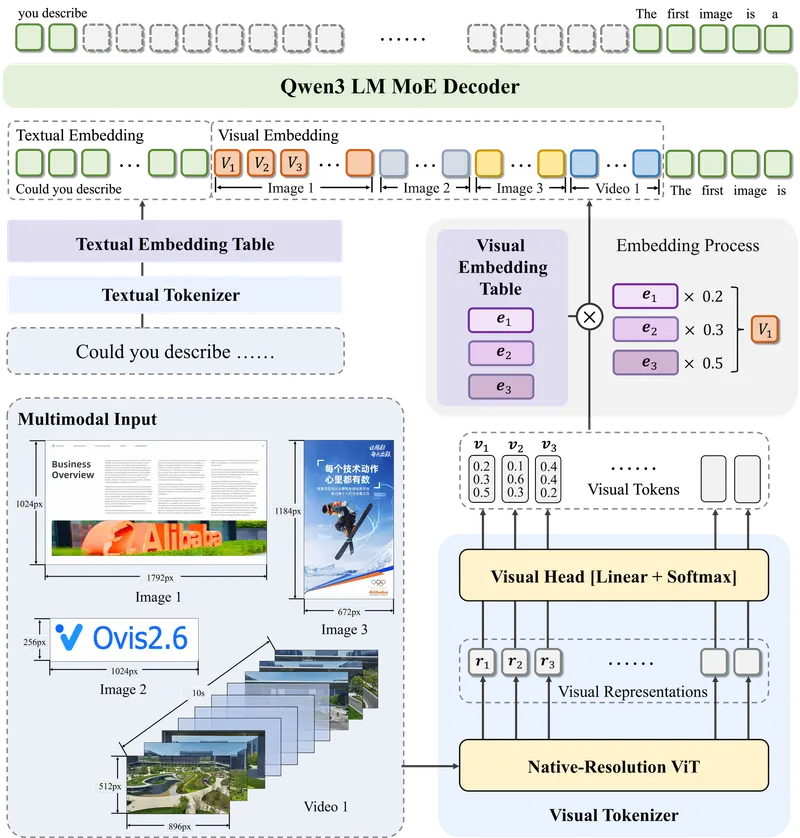
Ovis2.6-80B-A3B 的核心在于其视觉-语言对齐机制与MoE 路由策略的深度优化:
- 视觉编码器:采用高分辨率适配方案,确保图像细节无损传入 LLM。
- MoE 路由器:智能分配 Token 至最相关的专家网络,确保在处理视觉或文本任务时激活最优参数组合。
- 工具集成层:内置视觉操作工具接口,允许 LLM 在生成过程中动态调用裁剪、旋转等操作,并将结果反馈回思维链。
© 版权声明
文章版权归作者所有,未经允许请勿转载。