在端到端自动驾驶领域,如何平衡推理速度、决策精度与可解释性一直是行业难题。近日,小米正式发布并开源 Xiaomi OneVL 自动驾驶模型。这是业内首个将 VLA(视觉-语言-行动) 与 世界模型 统一于同一框架的创新方案,通过独特的**潜空间推理(Latent Space Reasoning)**技术,在保持极高推理速度的同时,实现了超越传统显式思维链(CoT)的精度与可解释性。
- GitHub:https://github.com/xiaomi-research/onevl
- 模型:https://huggingface.co/collections/xiaomi-research/onevl-models
Xiaomi OneVL 基于 Qwen3-VL-4B-Instruct 增强构建,不仅在多个主流基准测试中刷新 SOTA,更将推理延迟压缩至 0.24秒,为量产车端的实时部署提供了切实可行的路径。
核心亮点:统一架构、极速推理、双重可解释
1. 首创统一框架:VLA + 世界模型
过去,VLA(负责理解场景并输出动作)与世界模型(负责预测未来演变)往往是两条独立的技术路线。Xiaomi OneVL 通过潜空间推理首次将两者融合:
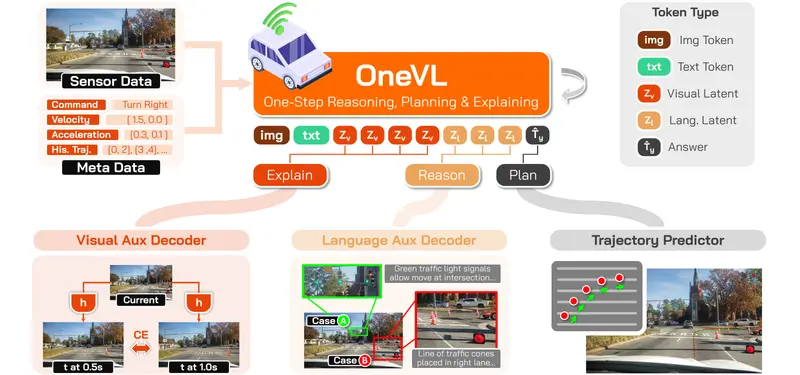
- 视觉潜在标记:编码未来场景动态,起到世界模型的作用。
- 语言潜在标记:编码逻辑推理过程,起到思维链的作用。
- 统一输出:在同一套框架下,既生成驾驶轨迹,又隐含了对物理世界演变的预测与逻辑推演。
2. 预填充推理:媲美“仅答案”的速度
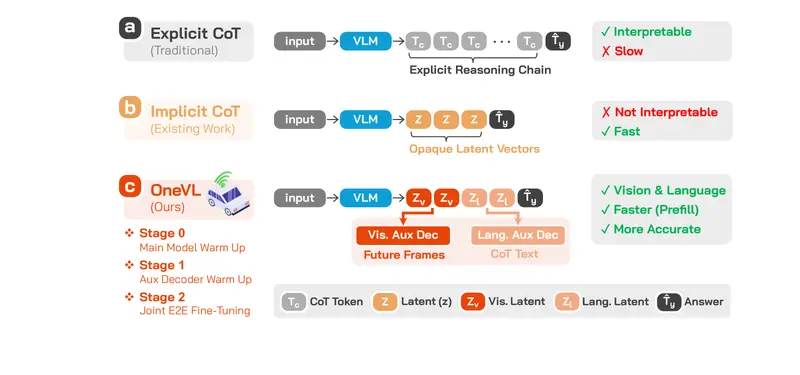
传统显式 CoT 因需生成大量中间文本而速度慢;传统隐式 CoT 速度快但不可解释。OneVL 实现了两全其美:
- 双模态辅助解码器(训练期):
- 视觉辅助解码器:从视觉潜在状态预测 t+0.5s 和 t+1.0s 的未来帧,监督模型理解物理动态。
- 语言辅助解码器:从语言潜在状态重构显式思维链文本,监督模型学习逻辑推理。
- 推理期丢弃解码器:在实际驾驶中,两个辅助解码器被丢弃,所有潜在标记通过单次并行传递预填充到提示上下文中。
- 极致延迟:推理延迟仅为 VLA 自回归推理的 5.4%,在 NAVSIM 上比显式 CoT 快 1.5 倍,在 ROADWork 上快 2.3 倍,最终延迟低至 0.24s (4.16 Hz)。
3. 双重可解释性:既懂“为什么”,又知“接下来”
尽管推理过程在潜空间完成,OneVL 仍能提供高水平的可解释性:
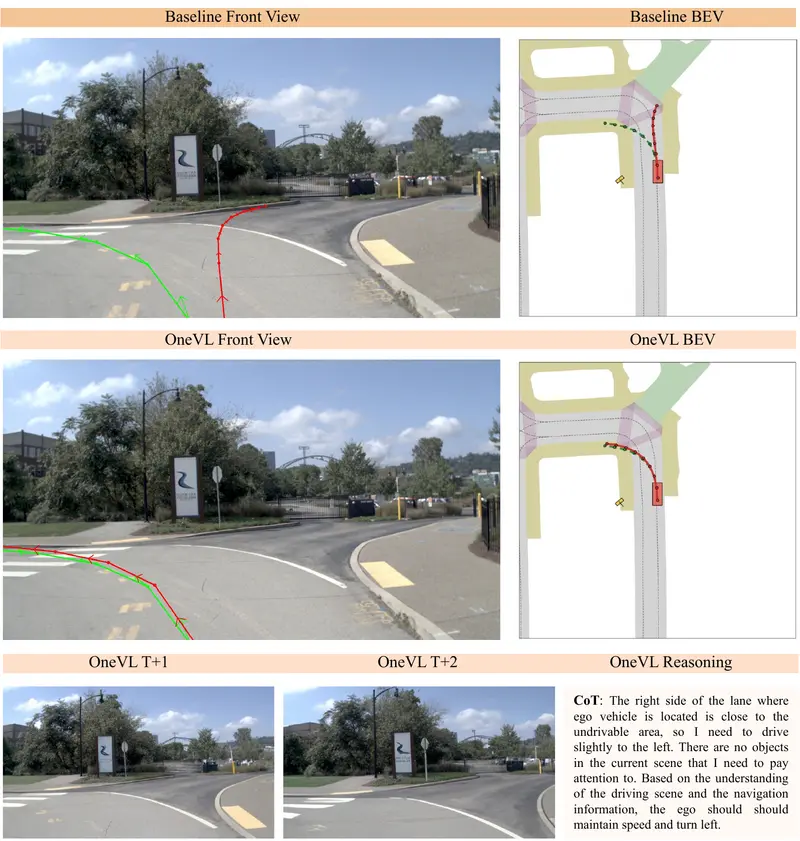
- 语言维度:可通过语言潜在标记还原思维链,用文字说明“为什么这样开”(如:“前方有行人,需减速”)。
- 视觉维度:可通过视觉潜在标记预测未来画面,展示“接下来会发生什么”(如:预测前方车辆轨迹、行人移动路径)。
性能表现:全面超越显式 CoT
Xiaomi OneVL 在涵盖感知、推理与规划的多个主流基准上取得突破性成绩:
| 基准测试 | 表现 | 备注 |
|---|---|---|
| ROADWork | SOTA | 显著超越现有方法 |
| Impromptu | SOTA | 复杂场景处理能力领先 |
| Alpamayo-R1 | SOTA | 长尾场景推理能力优异 |
| NAVSIM | PDM-score 88.84 | 首次在潜空间推理中超越显式 CoT (88.29) |
- 唯一性:目前唯一在所有四个基准测试中均优于显式自回归思维链的隐式推理方法。
- 消融实验验证:证明压缩物理世界的动态信息能带来显著的性能提升,证实了世界模型监督的有效性。
技术架构详解
OneVL 对 Qwen3-VL-4B-Instruct 进行了以下关键增强:
- 潜在标记接口:
- 在助手回答前插入 4 个视觉潜在标记 和 2 个语言潜在标记。
- 复用现有词汇标记,无需引入新的特殊 token,保持兼容性。
- 双辅助解码器监督:
- 视觉侧:预测未来帧视觉标记(基于 Emu3.5 IBQ,131k 码本),确保潜在标记扎根于物理现实。
- 语言侧:重构显式思维链文本,以 ViT 视觉特征为条件,确保逻辑严密性。
- 高效推理流程:
- 训练时:双解码器共同工作,提供强监督信号。
- 推理时:解码器离线,潜在标记预填充,仅轨迹部分以自回归方式生成,实现极速响应。
行业意义
- 打破速度-精度权衡:证明了无需牺牲可解释性即可实现高速推理,为端到端自动驾驶的实时性难题提供了新解法。
- 统一技术路线:将 VLA 的认知能力与世界模型的预测能力融合,提升了模型在复杂动态场景下的泛化能力。
- 开源赋能生态:小米选择开源 OneVL,将加速社区对潜空间推理、多模态自动驾驶大模型的研究与应用,推动行业技术标准化。
© 版权声明
文章版权归作者所有,未经允许请勿转载。