当你向 AI 询问“如何检查汽车机油”或“迷宫怎么走”时,传统的视觉语言模型(VLM)通常只会返回一大段枯燥的文字描述。用户很难将这些文字与图像中的具体位置对应起来,更难以验证 AI 的推理过程是否正确。
- 项目主页:https://sketchvlm.github.io
- GitHub:https://github.com/Brandon-Collins7/sketchvlm
- Demo:https://sketch-vlm-demo.vercel.app
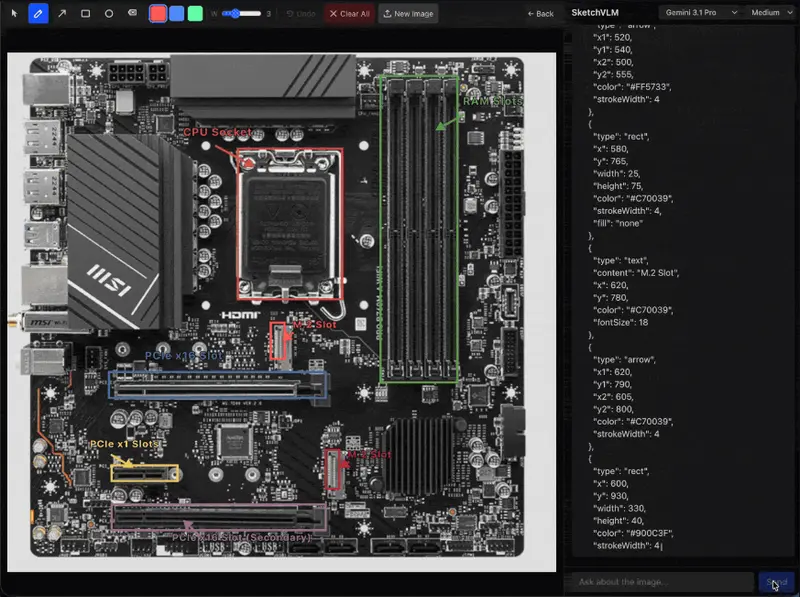
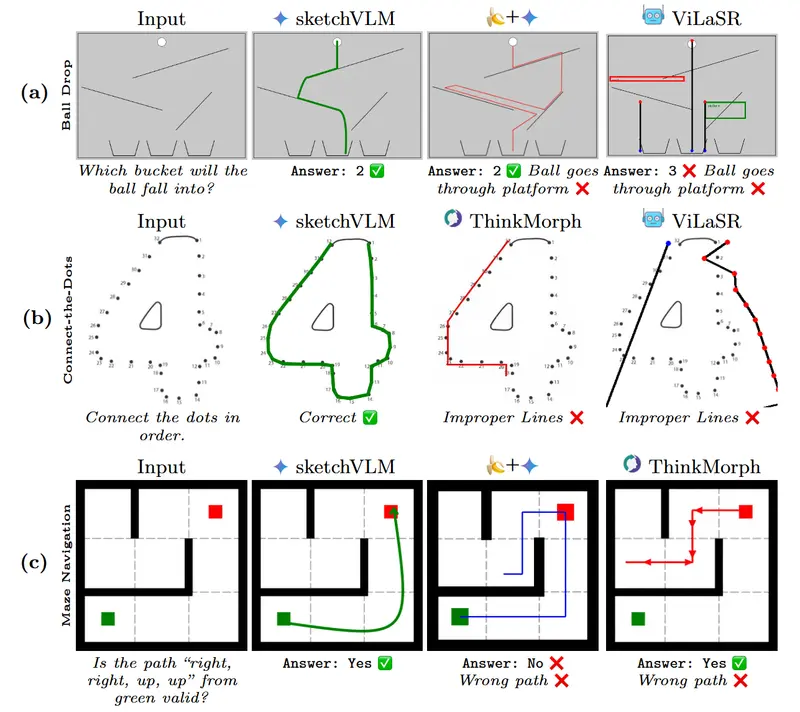
人类在解释复杂视觉问题时,自然会使用手指指向、画圈、箭头标注等方式。为了弥补这一差距,来自奥本大学和 Adobe 的研究团队提出了 SketchVLM。这是一个无需训练、模型无关的创新框架,它赋予 VLM 在输入图像上生成非破坏性、可编辑的 SVG 叠加层的能力,从而以直观的视觉方式解释其思维过程。
核心突破:从“只说不画”到“边看边画”
SketchVLM 的核心目标是让 AI 的推理过程可见、可验证、可交互。
- 无需微调:直接利用现有 VLM(如 GPT-5, Gemini-3-Pro 等)的原生能力,无需额外的训练数据或模型调整。
- 非破坏性标注:生成的标注以 SVG 格式叠加在原图之上,不修改原始像素,确保源图像的安全性与完整性。
- 高保真对齐:实验显示,SketchVLM 生成的草图与文本答案高度一致,解决了传统方法中“画的和说的不一样”的幻觉问题。
主要功能:全能视觉标注助手
SketchVLM 支持多种复杂的视觉任务,让 AI 的讲解更加生动精准:
- 轨迹预测:在物理模拟或迷宫任务中,画出小球掉落路径或最佳行走路线。
- 物体计数与标记:自动数出图中物品数量,并逐个标上数字标签,清晰明了。
- 轮廓勾勒:用方框、椭圆或多边形精准圈出目标物体,辅助定位。
- 部件标注:为复杂对象(如汽车引擎、动物解剖结构)添加详细的部件名称标签。
- 分步操作引导:结合箭头和文字,像教程一样一步步指导用户完成操作(如更换轮胎、检查油位)。
工作原理:三步实现智能绘图
SketchVLM 的实现逻辑简洁而高效,完全依赖 VLM 现有的空间理解能力:
- 坐标网格辅助:在输入图像边缘附加简易坐标网格,为 VLM 提供精确的空间参考系,使其能准确描述位置。
- 结构化指令输出:通过系统提示(System Prompt),指示 VLM 输出包含标注原语(圆形、箭头、文本、线条)的 XML 结构数据,并将其附在文本答案后。
- SVG 渲染叠加:后端自动将 XML 解析并转换为 SVG 矢量图,无缝叠加在原图上。整个过程无需外部视觉工具介入。
测试结果:性能全面领先
在涵盖视觉推理和绘图任务的六个基准测试中,SketchVLM 展现了卓越的性能:
- 📈 准确率飙升:在视觉推理任务(如迷宫导航、物理推理)中,准确率相比基线模型最高提升 28.5%。
- 🎨 标注质量优异:绘图质量比专门的图像编辑模型(如 Nano Banana Pro)和微调草图模型(如 ViLaSR)高出 48.3%。
- ✅ 高度一致性:标注-文本对齐得分极高,证明草图忠实反映了模型的推理逻辑,极大增强了用户信任。
- ⚡ 高效单轮生成:单次交互即可完成高质量绘图与回答,效率比多轮交互方式快近 6 倍。
为什么 SketchVLM 更重要?
| 特性 | 传统 VLM | 图像编辑模型 (如 Nano Banana) | SketchVLM |
|---|---|---|---|
| 解释方式 | 纯文本 | 修改原图像素 | SVG 叠加层 |
| 可验证性 | 低 | 中 | 高 |
| 是否需要训练 | – | 是 | 否 |
| 原图安全性 | 安全 | 破坏性 | 非破坏性 |
| 通用性 | 高 | 低 (特定任务) | 高 (模型无关) |
© 版权声明
文章版权归作者所有,未经允许请勿转载。