在当前的 AI 代理系统中,处理视觉、语音和语言任务往往需要调用多个独立的模型。数据在不同模型间传递不仅增加了延迟,还导致上下文丢失,进而影响响应的准确性和实时性。
今天,英伟达发布了 Nemotron 3 Nano Omni——一款开放的、一流的全模态推理模型。它将视觉、音频和语言能力整合到一个统一的系统中,使 AI 代理能够通过跨视频、音频、图像和文本的高级推理,提供更快、更智能的响应。
- 模型:https://huggingface.co/nvidia/Nemotron-3-Nano-Omni-30B-A3B-Reasoning-BF16
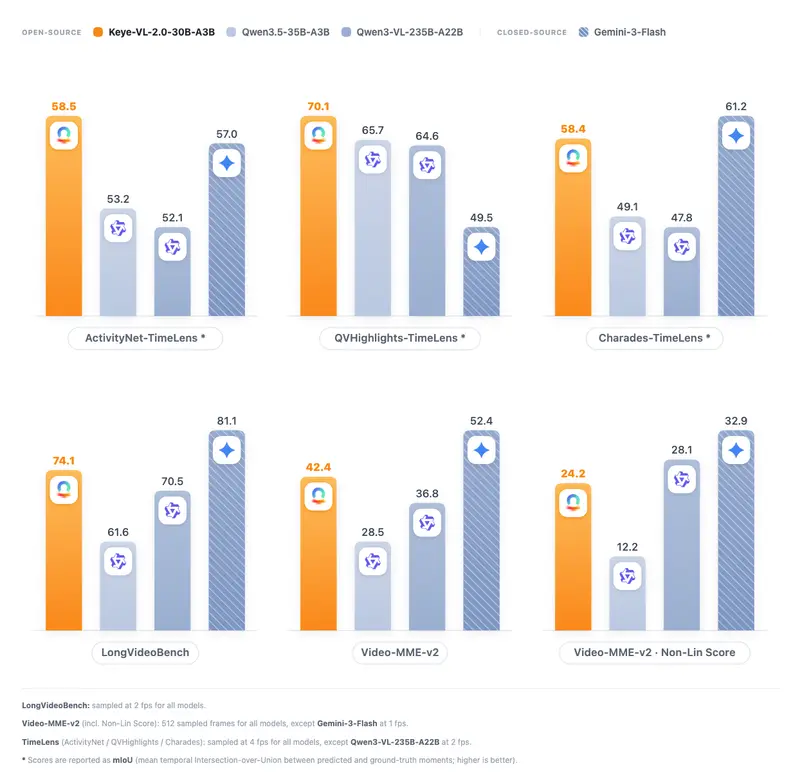
这款模型为企业和开发者构建高效、准确的多模态 AI 代理提供了全新的生产路径,同时保留了完整的部署灵活性和控制力。在复杂文档智能、视频和音频理解方面,Nemotron 3 Nano Omni 已在六个主流排行榜中领跑,为开放多模态模型设定了新的效率前沿。
目前,Aible、Applied Scientific Intelligence (ASI)、Eka Care、富士康、H Company、Palantir 和 Pyler 等公司已开始采用该模型;戴尔科技、DocuSign、Infosys、K-Dense、Lila、甲骨文和 Zefr 等企业正在对其进行评估。
“要构建有用的代理,你不能让模型花几秒钟去解读一个屏幕。”
—— H Company 首席执行官 Gautier Cloix
“通过在 Nemotron 3 Nano Omni 上构建,我们的代理可以快速解读全高清屏幕录制——这在以前是不现实的。这不仅仅是速度的提升,更是我们代理实时感知和交互数字环境方式的根本转变。”
为什么需要全模态统一?
想象这样一个场景:一个客户支持 AI 代理需要同时处理屏幕录制、分析通话音频并检查数据日志;或者一个金融代理需要解析 PDF、电子表格、图表以及语音记录。
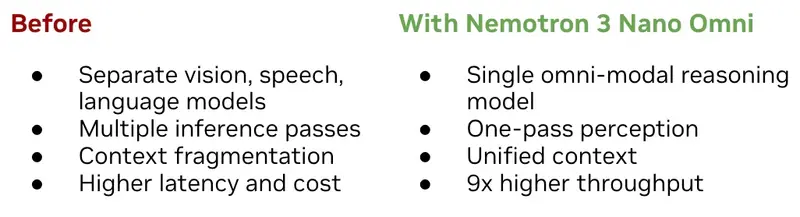
在传统的架构中,这些任务通常由独立的视觉、语音和语言模型分别完成。这种“拼凑式”的方法带来了三个主要问题:
- 高延迟:多次推理传递增加了响应时间。
- 上下文碎片化:跨模态的信息难以连贯整合。
- 成本与误差累积:随着时间推移,系统复杂度增加,成本和出错率随之上升。
Nemotron 3 Nano Omni 通过其 30B-A3B 混合专家(MoE)架构,内置了视觉和音频编码器,彻底消除对单独感知模型的需求。
作为首个同时提供极高效率和强大多模态感知准确性的开放模型,它使 AI 系统的吞吐量比具有类似交互性的其他开放全模态模型高出高达 9 倍。这意味着在不牺牲响应速度或质量的前提下,显著降低运营成本并提升可扩展性。
在复杂的代理系统中,Nemotron 3 Nano Omni 可以作为“感知中枢”,与专有云模型或其他 NVIDIA Nemotron 开放模型(如用于高频执行的 Nemotron 3 Super 或用于复杂规划的 Nemotron 3 Ultra)协同工作,为计算机使用、文档智能和音视频推理等子任务提供强大动力。
三大核心应用场景
1. 计算机使用代理(Computer Use Agents)
Nemotron 3 Nano Omni 为代理提供了导航图形用户界面(GUI)、推理屏幕内容以及随时间理解界面状态的“感知循环”。
- 高保真视觉推理:H Company 最新的计算机使用代理基于该模型构建,支持 1920×1080 像素的原生输入分辨率。
- 复杂界面导航:在 OSWorld 基准的初步评估中,该集成在导航复杂图形界面方面表现出显著飞跃,充分利用了模型处理极高分辨率图像的能力。
2. 文档智能(Document Intelligence)
对于企业分析和合规工作流至关重要。该模型能够解释文档、图表、表格、截图和混合媒体输入,使代理能够连贯地跨越视觉结构和文本内容进行推理,而非孤立地处理文字或图片。
3. 音频和视频理解(Audio & Video Understanding)
在客户服务、研究和监控工作流中,Nemotron 3 Nano Omni 能够保持音频-视频上下文的完整性。它将“所说的”、“所显示的”和“所记录的”内容连接到一个统一的推理流中,避免了传统方法中脱节摘要带来的信息损失。
开放、可定制、随处部署
Nemotron 3 Nano Omni 以开放权重、数据集和训练技术的形式发布,为组织提供了对其定制和部署方式的完全透明度和控制权。
- 灵活定制:开发者可以使用 NVIDIA NeMo 等工具,针对特定领域用例进行微调、评估和优化。
- 合规部署:由于模型是开放的,组织可以将其部署在满足监管、数据主权或本地化要求的环境中,无需依赖特定的云端黑盒服务。
- 广泛生态支持:该模型可在 Hugging Face、OpenRouter 和 build.nvidia.com 上作为 NVIDIA NIM 微服务获取,并通过广泛的 NVIDIA 云合作伙伴、推理平台和云服务提供商生态系统提供。
Nemotron 3 系列(包括 Nano、Super 和 Ultra 模型)在过去一年中已下载超过 5000 万次。Omni 模型的加入,进一步将该系列的能力扩展至多模态和代理领域。
其轻量级且开放的架构支持一致的部署体验,无论是本地系统(如 NVIDIA DGX Spark 和 DGX Station)、数据中心还是云环境,均可无缝运行。
© 版权声明
文章版权归作者所有,未经允许请勿转载。