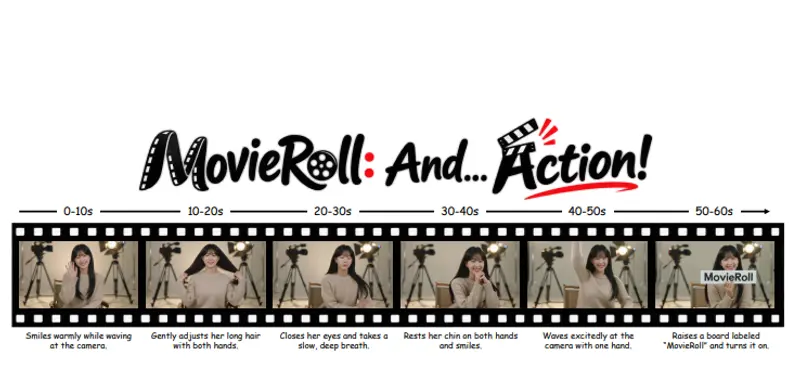
针对当前 AI 视频模型在生成长视频时面临的时序连贯性崩坏与显存爆炸两大难题,北京大学与腾讯混元研究团队共同提出了 MovieRoll。这是一套完整的从基础模型到快速蒸馏模型的长视频流式生成框架。它创新性地实现了“短素材训练、长视频推理”,仅使用上限为 15 秒的短视频素材进行训练,即可在推理阶段直接产出长达 60 秒(1 分钟)的高质量连贯视频,并支持多事件剧情切换。
- 项目主页:https://tencent-hunyuan.github.io/MovieRoll
- GitHub:https://github.com/Tencent-Hunyuan/MovieRoll
- 模型:https://huggingface.co/yunyangge/MovieRoll
核心痛点与解决方案
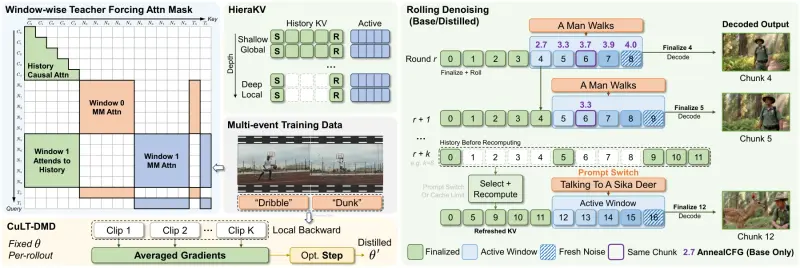
传统 AI 视频生成在延长时长时往往陷入两难:要么因错误累积导致人物变脸、场景突变;要么因保存全部历史信息导致显存溢出。MovieRoll 通过以下核心技术突破了这些限制:
- 分层历史缓存 (HieraKV):
- 不再“全存”或“全丢”。网络浅层保留全部历史以把握整体场景,深层网络仅保留起始锚定片段和最近片段。这在大幅降低显存开销的同时,有效保留了关键上下文,防止画面错乱。
- 窗口式并行训练 (WinTF):
- 采用滑动窗口机制,窗口内部双向打磨细节,窗口外历史单向读取。这种训练方式模拟了视频逐渐变长的过程,并人为加入噪声以缩小训练与推理的差距,显著提升了长序列的稳定性。
- 周期性 KV 重计算外推:
- 当历史信息积累到阈值时,模型会挑选关键片段重新编码整理记忆,清理过期依赖。这使得模型能够生成远超训练时长(15秒)的视频,并在切换剧情提示时触发记忆整理,确保角色与环境的一致性。
- CuLT-DMD 累积长调蒸馏:
- 将基础大模型提炼为少步数快速版本。不同于传统的逐段更新,它在跑完整条长序列后统一汇总学习信号,使学生模型能吸收整条视频的经验,实现更快的生成速度。
- AnnealCFG 引导退火:
- 在生成后期逐步降低引导强度,有效抑制了长视频末尾常见的色彩饱和失真和物体变形问题。
主要功能与特点
- 分钟级流式生成:支持输出 30-60 秒长视频,且为流式逐段产出,无需等待全部生成完毕即可预览。提供 MovieRoll-Base(高质量)和 MovieRoll-Distilled(快速版)两种模式。
- 多事件递进剧情:支持每隔一段时间更换文字提示(如前 10 秒画画,中间 10 秒拍照),模型能承接上一段的人物和环境执行新指令,实现连续剧情创作。
- 提示自动改写:用户输入简短指令,系统自动扩写为适合长视频生成的详细描述,维持角色与场景一致性。
- 高效硬件支撑:配套 FBCA 块因果注意力内核与 PS-VAE 并行流式解码器,进一步降低训练与解码的硬件开销。
性能表现
在 HeliosBench 评测基准及专业人员盲测中,MovieRoll 表现优异:
- 综合得分第一:MovieRoll-Distilled 在 10 秒、30 秒、60 秒单事件及多事件测试中均取得最高总分。
- 主观偏好领先:相比竞品,更少出现人物变脸、色彩跑偏和动作僵硬,画面自然度与运动活跃度平衡更好。
- 消融实验验证:WinTF 训练、HieraKV 缓存、KV 重计算及 AnnealCFG 等模块均被证明对提升长视频质量至关重要。
局限性与展望
尽管 MovieRoll 取得了显著突破,但目前仍属于科研原型:
- 非实时生成:即使多 GPU 加速,生成一分钟视频仍需上百秒。
- 微小漂移仍存在:极长视频中仍会缓慢累积细小瑕疵,无法彻底杜绝人物与画面的缓慢漂移。
- 硬件要求高:对显卡配置仍有较高要求。
- Base 版局限:基础版本在 60 秒超长生成时稳定性不足,主要依赖蒸馏版进行长视频创作。
MovieRoll 的出现,为 AI 视频从“短片拼接”走向“长篇叙事”提供了重要的技术路径,降低了长视频模型的训练门槛,并为未来更复杂、更长时长的 AI 影视创作奠定了基础。
© 版权声明
文章版权归作者所有,未经允许请勿转载。