H Company 正式发布了 NeoMME,这是一个包含 260M 和 800M 参数的双向多模态编码器家族。与当前主流的“二手”视觉文档检索器(如 ColPali,即复用生成式 VLM 的编码器部分)不同,NeoMME 从架构上彻底移除了独立的视觉塔(Visual Tower)和因果解码器(Causal Decoder)。它采用单一 Transformer 架构,直接处理多语言文本令牌和原始 RGB 图像块,实现了极高的参数效率和推理速度。
- 模型:https://huggingface.co/collections/Hcompany/neomme
- Demo:https://huggingface.co/spaces/tonywu71/neomme-retriever-demo
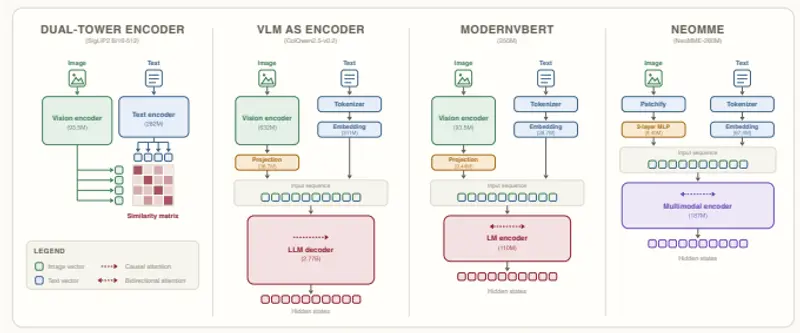
核心架构创新:单塔双模态
NeoMME 的设计哲学是极简与统一:
- 无视觉塔:不使用预训练的 SigLIP 或 ViT 作为前端。图像被分割为不重叠的 32×32 RGB 块,通过一个从头训练的 2 层 MLP 投影到模型空间。
- 无因果解码器:完全摒弃了用于生成的解码器部分,专注于双向编码表示。
- 统一处理流:文本通过 ALBERT 风格的分解嵌入进入,图像块直接拼接。两者在同一个 Transformer 栈中通过相同的层进行处理。
- 高效注意力机制:大多数层使用对称滑动窗口注意力,每第六层和最后一层使用全局注意力。结合分组查询注意力(GQA)、查询-键归一化和 2D 旋转位置嵌入(RoPE),支持高达 16,384 的上下文长度,足以容纳两张 4K UHD 图像。
- 高效分词器:使用无空白约束的 BPE,词表大小 131,072。在 FLORES-200 测试中,其发出的令牌数比 ModernBERT 少 44.4%。
训练策略:掩码扩散去噪
NeoMME 并非通过传统的对比学习预训练,而是采用离散掩码扩散(Discrete Masked Diffusion):
- 强制跨模态理解:在多模态段落中,损坏率(Masking Rate)从 0.30 到 1 均匀抽取。高损坏率迫使模型必须依赖可见的图像块来预测被掩码的文本令牌,从而消除仅靠语言统计规律的捷径。
- 显著增益:消融实验显示,在 90% 掩码率下,可见图像块将 260M 模型的掩码令牌准确率提高了 38.4 个百分点。
性能表现:小模型,大能量
NeoMME-Retriever 在共享主干上添加了两个联合训练的头:一个用于稠密检索的均值池化头,和一个用于后期交互(Late Interaction)的 128 维投影头。
| 模型 | 参数量 | ViDoRe v3 (nDCG@10) | 对比基准 |
|---|---|---|---|
| NeoMME-260M | 260M | 0.523 | 接近 3.75B 的 ColQwen2.5-v0.2 (0.525),体积小 14.4 倍 |
| NeoMME-800M | 800M | 0.556 | 略低于同规模的 Vultron Retriever Flash |
亮点:260M 版本击败了所有评估过的 8 亿参数以下的模型,并在 ViDoRe v3 上以极小的体积达到了与数十亿参数模型相当的性能。
吞吐量与存储优化
NeoMME 在部署效率上具有显著优势:
- 极速索引:在单张 NVIDIA L40S 上,NeoMME-260M 每秒可编码 51.3 页(2048×2048 输入),速度是 ColModernVBERT 的 1.97 倍。
- CPU 友好:在纯 CPU 主机上,编码一个查询仅需 78.3 毫秒。
- 极致压缩:通过分层令牌池化和非对称量化(Int8/二进制),可将每页索引大小从 1.5 MB 压缩至 6.0 kB(压缩 255.5 倍),同时保留 95.19% 的 nDCG@10 性能。
⚠️ 局限性
- 纯文本检索较弱:在 BEIR-15 基准上,其表现不如专门针对文本优化的 LateOn 模型,主要受限于监督数据的规模(43 万 vs 6.6 亿示例)。
- 自然图像迁移能力有限:由于专注于文档页面,其在通用自然图像任务上的零样本迁移能力仍有提升空间。
© 版权声明
文章版权归作者所有,未经允许请勿转载。