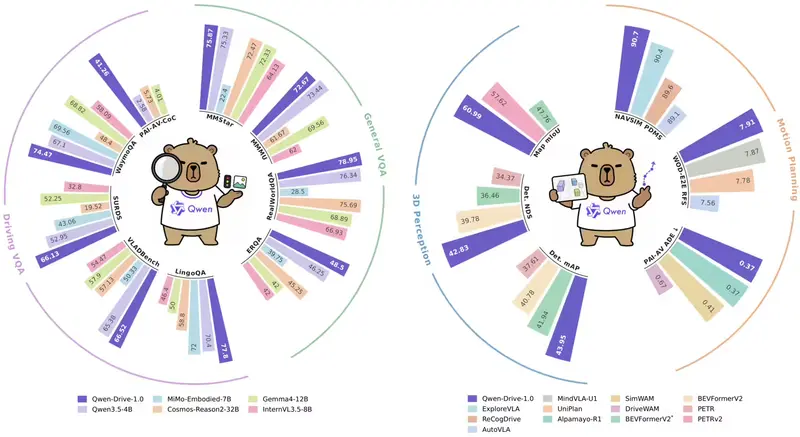
阿里巴巴通义千问团队本周正式开源了 Qwen-Drive-1.0-4B,这是基于 Qwen3.5-4B 构建的、专为自动驾驶场景设计的视觉语言模型(VLM)。作为业界首个将 3D 感知、视觉问答与运动规划统一在单一 VLM 架构下的基础模型,Qwen-Drive-1.0 标志着“端到端”自动驾驶技术向更具通用理解能力的认知智能迈出了关键一步。
- GitHub:https://github.com/QwenLM/Qwen-Drive-1.0
- Hugging Face:https://huggingface.co/Qwen/Qwen-Drive-1.0-4B
- ModelScope:https://modelscope.cn/models/Qwen/Qwen-Drive-1.0-4B
核心亮点:统一架构与分阶段训练
- 首个自动驾驶 VLM 基础模型:
- 打破了传统自动驾驶模块(感知、预测、规划)的壁垒,在预训练阶段即统一了 3D 感知与视觉问答(VQA),并进一步扩展至运动规划。
- 完全保留了预训练 VLM 的原始架构,使其不仅懂开车,还具备强大的通用视觉理解与指令遵循能力。
- 分阶段训练策略:
- 驾驶监督 + 通用数据:将驾驶特定的监督信号与海量通用视觉语言数据结合,确保模型在获得专业驾驶能力的同时,不遗忘通用的世界知识。
- 双专家规划:提供 SFT(监督微调) 和 RL(强化学习) 两个规划专家版本,分别侧重于基准性能与人类偏好对齐。
- 纯公开数据构建:
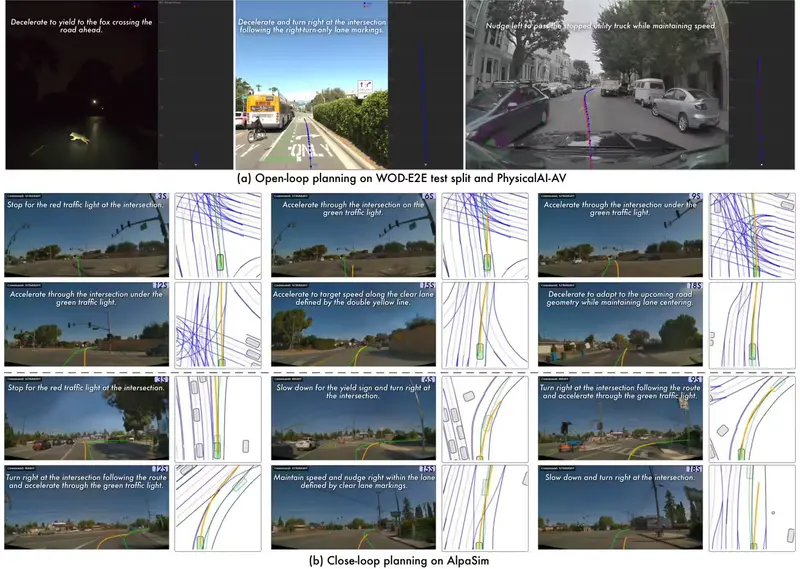
- 所有规划样本均源自公开数据集,团队统一了各数据集的轨迹格式,实现了从开环预测到闭环驾驶的全流程评估,极大降低了社区复现门槛。
性能表现:SFT 与 RL 的双重优势
| 维度 | SFT 模型表现 | RL 模型表现 |
|---|---|---|
| 基准测试 | 在所有基准(3D 感知、场景理解、开环/闭环规划)上均具备极强竞争力 | 在 SFT 基础上进一步优化 |
| 开环位移误差 | 极低 | 仅有微小增加 |
| 人类偏好对齐 | 良好 | 全面提升 |
| 闭环安全性 | 优秀 | 显著增强 |
关键洞察:经过强化学习(RL)训练的模型,虽然牺牲了极微小的开环位移精度,但在拟人化驾驶行为和复杂场景下的安全性上取得了质的飞跃,更符合真实道路环境的驾驶需求。
为什么 Qwen-Drive-1.0 很重要?
- 认知驱动的自动驾驶:传统的端到端模型往往是“黑盒”,而 Qwen-Drive-1.0 利用 VLM 的语言能力,能够解释驾驶决策(如“因为前方有行人所以减速”),提升了系统的可解释性。
- 通用能力的迁移:得益于 Qwen3.5 的强大底座,该模型不仅能处理驾驶任务,还能回答关于路况、交通标志甚至周围环境的复杂问题,为未来的人车交互提供了新可能。
- 开源生态推动:通过统一轨迹格式和开放全流程评估代码,Qwen-Drive-1.0 为学术界和工业界提供了一个标准化的研究基线,有望加速端到端自动驾驶技术的迭代。
适用场景
- 端到端自动驾驶研发:作为感知与规划一体化的基座模型。
- 智能座舱交互:利用其 VQA 能力,实现更自然的车内环境问答与导航解释。
- 自动驾驶仿真与测试:用于生成更拟人化的驾驶轨迹,提升仿真测试的真实度。
© 版权声明
文章版权归作者所有,未经允许请勿转载。