BRIA AI 正式推出图像理解模型 fibo-scene-analyzer(FIBO Scene Analyzer [dev]),该模型由 Qwen3.6-35B-A3B 微调而来,单个模型即可一次性完成多项视觉任务,输出高度标准化、结构化的场景信息。
- 模型:https://huggingface.co/briaai/fibo-scene-analyzer
- Demo:https://huggingface.co/spaces/briaai/fibo-scene-analyzer-demo
模型采用Bria自研的场景描述格式,输出完整场景信息:包含图片整体描述(画面类型、艺术风格、光照、构图、色彩调色板)以及对象树结构。每个对象会附带名称、文字描述、几何信息(边界框、多边形蒙版、人体关键点)、RGB色彩、对象间相互关系,同时区分物体类别:人、动物、文字以及其他物体。
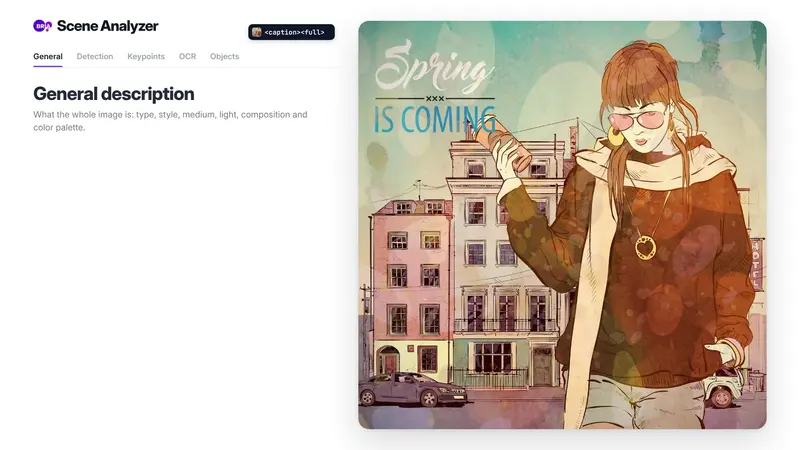
除基础场景解析外,模型支持目标检测、实例蒙版、人体关键点提取、带文本行框的OCR。同时具备生成侧能力:可以把简短提示词扩展为完整场景描述,也可以依据指令对已有场景描述做细化、编辑修改。
训练方案
基于自定义合成数据集,采用多阶段SFT监督微调;再使用任务专属奖励做GRPO强化学习,最后追加一轮短SFT收尾。合成数据依靠一套12步工作流,结合各类CV工具、通用与专业视觉模型,提取图像里全部结构化信息。
支持全部任务清单
- caption:输入图像,输出场景结构化描述,可指定细节等级
- detect:图像目标检测,输出对象名称、类别、边界框
- mask:实例分割,输出多边形蒙版
- keypoints:人体关键点检测,附带框与命名点位
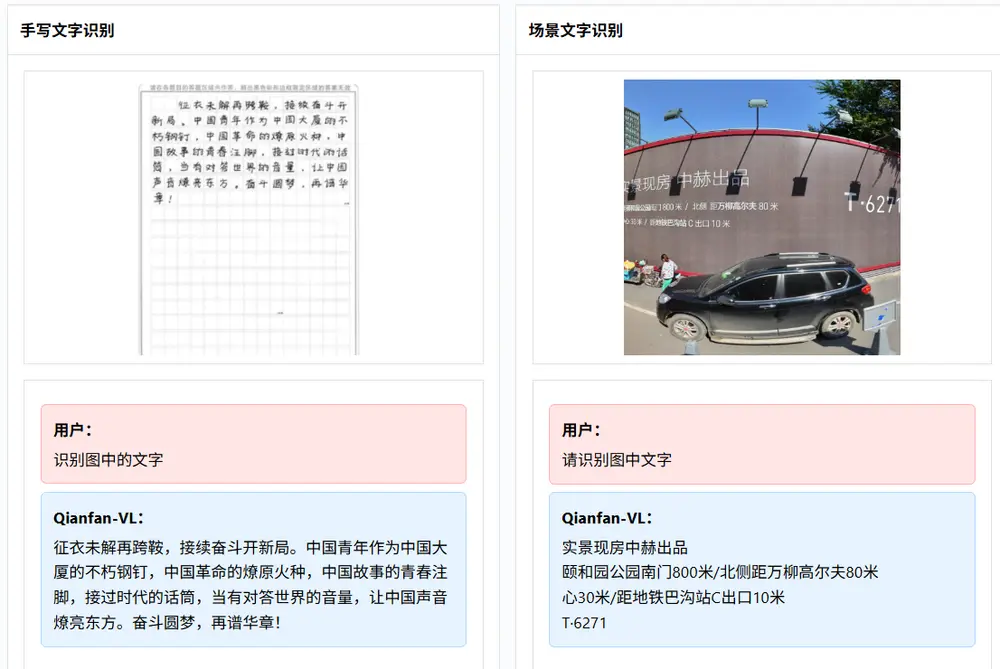
- ocr:图文识别,附带每行文本的位置框
- describe:针对指定单个对象,输出该对象完整字段信息
- expand:根据简短提示词+画面比例,生成全新完整场景描述,用于图像生成前置
- expand_object:基于已有场景,生成适配环境的对象描述(对象本身不在原始场景内)
- refine:接收指令+场景JSON,修改并输出更新后的场景描述
- edit:最多5张图像+修改指令,输出编辑后画面的结构化场景信息
说明:AR宽高比=宽度/高度,保留两位小数。场景描述使用紧凑JSON格式,坐标、颜色编码为token;可通过项目
scene_analyzer.py完成格式化输出与后处理。
目标检索规则:查询图像不存在的目标,返回空列表;不带目标参数时detect/mask会提取全部物体。衣物、鞋子、配饰会独立识别,命名格式为「ITEM on PERSON」。
5档场景细节等级
- general:仅整体场景概述,不输出对象列表
- short:扁平化对象清单,包含名称、类别、描述、位置、相对大小、文本行
- long:在short基础上增加色彩、细节描述、对象之间的关联关系
- full:对象树结构,附带边界框、相对距离、人体关键点
- full_mask:full等级基础上,大部分对象附带多边形蒙版
任务适配限制:
expand/refine/edit支持 general、short、long、full;expand_object支持 short、long、full、full_mask。
要点小结
- 基座:Qwen3.6-35B-A3B微调,BRIA发布FIBO Scene Analyzer开发版
- 核心能力:单模型统一完成结构化字幕、目标检测、实例蒙版、人体关键点、带坐标OCR;同时支持提示词扩写、场景描述编辑,适合作为图像生成前置理解模块
- 输出形式:标准化场景对象树JSON,每个物体携带位置、颜色、相互关系
- 训练链路:合成数据集 → 多阶段SFT → GRPO强化学习 → 收尾SFT
- 细节分级:5档粒度可选,兼顾轻量快速解析与高精度掩码全套信息
© 版权声明
文章版权归作者所有,未经允许请勿转载。