阿里巴巴通义千问团队正式发布了 Qwen3.8-Flash-Next,这是一款面向极致每 Token 成本优化的开放权重多模态混合专家(MoE)模型。作为 Qwen4 底层架构的早期预览版,该模型在保持强大性能的同时,将训练成本降低至前代 Qwen3.7-Plus 的约 九分之一。
- 官方介绍:https://qwen.ai/blog?id=qwen3.8-flash-next
- GitHub:https://github.com/QwenLM/Qwen3.8-Flash-Next
- Hugging Face:https://huggingface.co/collections/Qwen/qwen38-flash-next
- 魔搭:https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next
核心架构创新:四项关键变革
Qwen3.8-Flash-Next 并非简单的参数堆叠,而是通过以下四项技术革新实现了效率与性能的平衡:
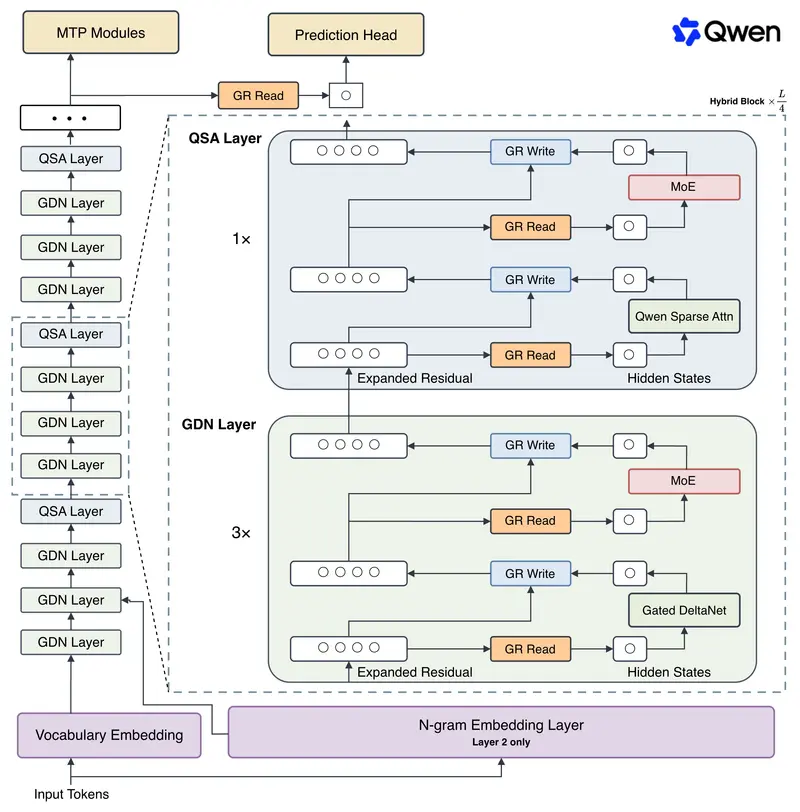
- 混合注意力机制 (GDN + QSA):
- Gated DeltaNet (GDN):在每四层中的三层使用,将历史信息压缩为固定大小的循环状态,实现线性注意力的高效处理。
- Qwen Sparse Attention (QSA):在第四层运行,通过轻量级索引器以微块(micro-block)粒度筛选重要上下文。在 1M Token 超长上下文下,Prefill 和 Decode 阶段分别实现最高 7.6 倍 和 4.9 倍 的加速。
- Gated Residual (GR) 机制:
- 将残差流扩展为 4 条并行分支,通过动态 Gate 控制信息的读写。支持 FP8 存储,大幅降低访存开销。
- N-gram Embedding:
- 引入 51B 参数的 N-gram 嵌入表(包含 2000 万个二元组/三元组条目),利用局部上下文查表扩展模型容量。这些参数可卸载至主机内存并通过异步预取与计算重叠,不长期占用 GPU 显存。
- Muon 优化器:
- 采用 Muon 优化器配合 AdamW,针对正交化精度和参数分工进行优化,重新拟合了 Scaling Law,消除了批次大小预热的需求。
模型规格与性能
- 参数量:主干网络 125B + N-gram 嵌入 51B + 多 Token 预测模块 4B = 总磁盘大小约 180B。
- 激活参数:每 Token 仅激活 6B 参数(MoE 层包含 512 个专家,激活 10 个路由专家 + 1 个共享专家)。
- 上下文长度:原生支持 262,144 Tokens,可通过 YaRN 扩展至 1,000,000 Tokens。
- 基准表现:
- 在 MMLU-Pro、SuperGPQA、BBH、SWE-bench 等 14 个基准中的 8 个取得最优结果。
- 代码能力强劲:LiveCodeBench v6 得分 91.9,SWE-bench Pro 得分 62.5。
- 多模态表现优异:AndroidWorld 84.5,MathVision (带代码解释器) 95.7。
部署与运行要求
虽然模型高效,但其庞大的权重体积对硬件提出了较高要求:
- 显存需求:
- FP8 检查点:172.78 GiB
- BF16 检查点:335.28 GiB
- 推荐配置:
- 最低配置:GB200/GB300 上的 TP2 (FP8)。
- 推荐配置:TP4 或更高。在 8×H200 节点上需使用 TEP8。
- 注意:普通 TP8 与检查点的 128 宽量化块不兼容。稀疏激活节省的是计算量,而非存储空间,因此无法在单个工作站显卡上运行。
- 支持框架:vLLM, SGLang, TokenSpeed, transformers serve, llama.cpp (GGUF)。
- 微调支持:Unsloth, Swift, LLaMA-Factory。
许可证与注意事项
- 许可证:采用 qwen-community-1.0 许可证,而非 Apache-2.0。商业使用前请务必核实具体条款。
- 推理建议:
- 思考模式(默认开启):Temperature 1.0, Top_p 0.95。
- 指令模式:Temperature 0.7, Top_p 0.80。
© 版权声明
文章版权归作者所有,未经允许请勿转载。