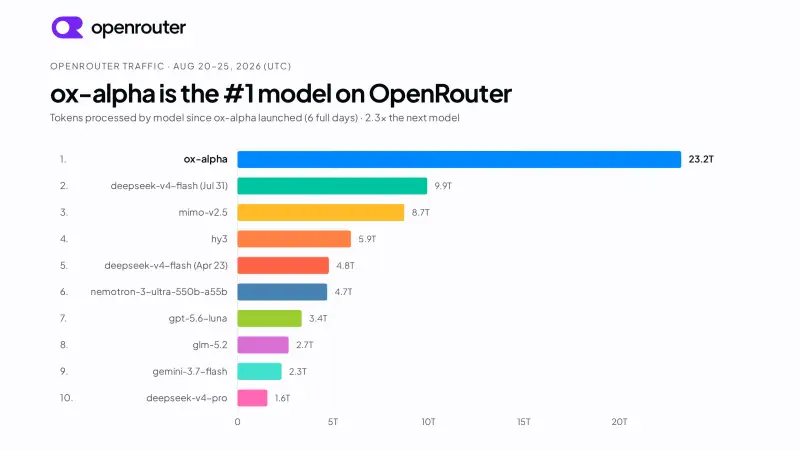
智谱AI正式上线并且开源 GLM‑5.3‑Flash(320B‑A18B),这也是GLM‑5产品线当中第一款原生多模态混合专家模型。此前在海外平台爆火、中文社区代号“牛来”的匿名模型Ox‑Alpha,正是这款新模型的内测版本。
- 官方介绍:https://z.ai/blog/glm-5.3-flash
- BigModel 开放平台:https://docs.bigmodel.cn/cn/guide/models/vlm/glm-5.3-flash
- Z.ai:https://docs.z.ai/guides/vlm/glm-5.3-flash
- GLM Coding Plan:https://bigmodel.cn/glm-coding
- HuggingFace:https://huggingface.co/zai-org/GLM-5.3-Flash
在内测阶段,Ox‑Alpha登陆OpenCode、OpenRouter两大平台,短时间内刷新双平台调用量记录,一跃成为当周热度最高的模型之一,而全部测试流量都跑在国产算力芯片之上。
核心规格:320B超大基座,推理仅激活18B参数
- 完整总参数量:320B(3200亿)
- 单次生成激活参数:18B(180亿)
- 训练语料:30T Token多模态预训练数据集
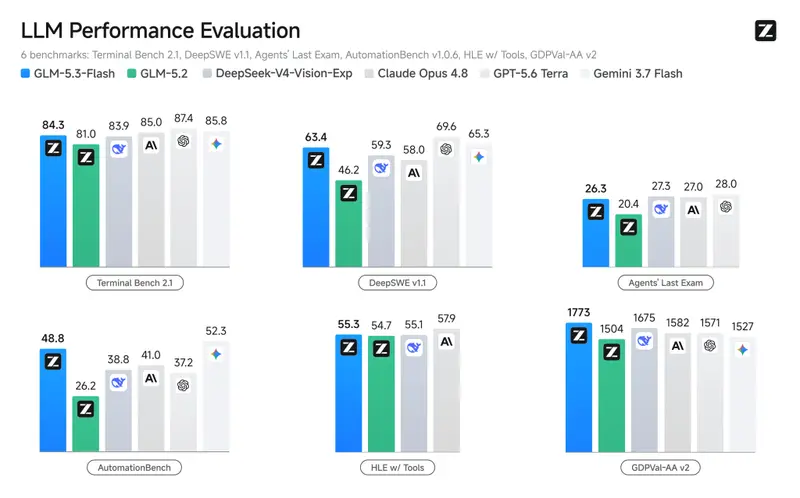
- 整体能力全面超越参数量高一倍的GLM‑5.2
性能榜单上,GLM‑5.3‑Flash交出亮眼答卷。在AA综合智能指数拿到57分,成绩和Claude Opus 4.8持平;自研Z.ai代码评测基准当中,编程能力同样达到Opus 4.8水准,正式迈入全球前沿模型梯队。
而最具冲击力的是它的定价策略:常规价格仅为GLM‑5.3的1/10;限时折扣期更是压低至原版的1/20,综合成本大约只有Claude Opus 4.8的 1/40,做到前沿能力、极低推理成本兼顾。
全新架构升级,两大注意力方案混合
为了实现低激活参数下的高性能,智谱对底层架构做出大刀阔斧的革新,它也是业内首款开源的稀疏注意力+线性注意力混合架构前沿模型。
- 稀疏‑线性混合注意力,兼顾超长上下文精度,大幅降低长文本推理开销
- 流形约束超连接(mHC),提升模型缩放能力,让模型更容易从海量数据当中习得知识
相比前代GLM‑4.5(355B),新模型总参数规模接近,但是激活参数由32B下降至18B,网络层数从92层精简到45层,用更少的计算资源换来了更强的综合实力。
原生视觉融入代码循环,可自主完成GUI交互
GLM‑5.3‑Flash最大的亮点之一,就是视觉能力深度嵌入代码生成流程。模型可以主动观察网页界面、渲染结果、图形反馈,不断迭代调试代码。
适用场景覆盖前端网页开发、独立游戏搭建、Blender三维场景制作,还能够依托BUA、CUA技术操控真实电脑桌面程序,打通代码‑浏览器‑图形界面的闭环任务链路。
在办公落地层面,它支持复杂目标拆解、工具调用、结果自检优化,独立完成从资料调研、数据分析,一直到生成PPTX、PDF、Word、Excel文档的全套工作流,适配金融研究、企业文档处理等专业场景。
开源、API、福利活动同步上线
目前GLM‑5.3‑Flash已经全球开源开放,API接口同步开启调用,并且接入ZCode编程开发平台。
配套的 GLM Coding Plan 福利继续运行,每天限量发放10000张试用额度卡。同时全员用户的额度已经重置,大家前往后台用量统计页面即可看到回满后的可用配额。
© 版权声明
文章版权归作者所有,未经允许请勿转载。