小鹏集团联合北京大学、香港大学等高校研究团队,正式发布了具身感知基座模型 GroundingPI。该模型以约 40 亿参数规模,首创“感知优先”的技术路线,在 34 项公开感知基准的综合评测中位列第一,并在机器人仿真任务中展现出卓越的数据处理效率与场景泛化能力。
- 项目主页:https://groundingpi.github.io
- 论文:https://arxiv.org/abs/2609.39601
- GitHub:https://github.com/groundingpi/GroundingPI
- Model:https://huggingface.co/GroundingPI/GroundingPI
核心特性与技术路线
GroundingPI 的核心创新在于其 “感知优先” 的训练范式。研究团队认为,精准感知自身与周边物体的空间位置是具身智能的首要前提。
- 纯感知数据驱动:在训练阶段,模型完全摒弃了带有机器人关节动作标签的数据,转而全部采用无动作标签的纯感知数据。
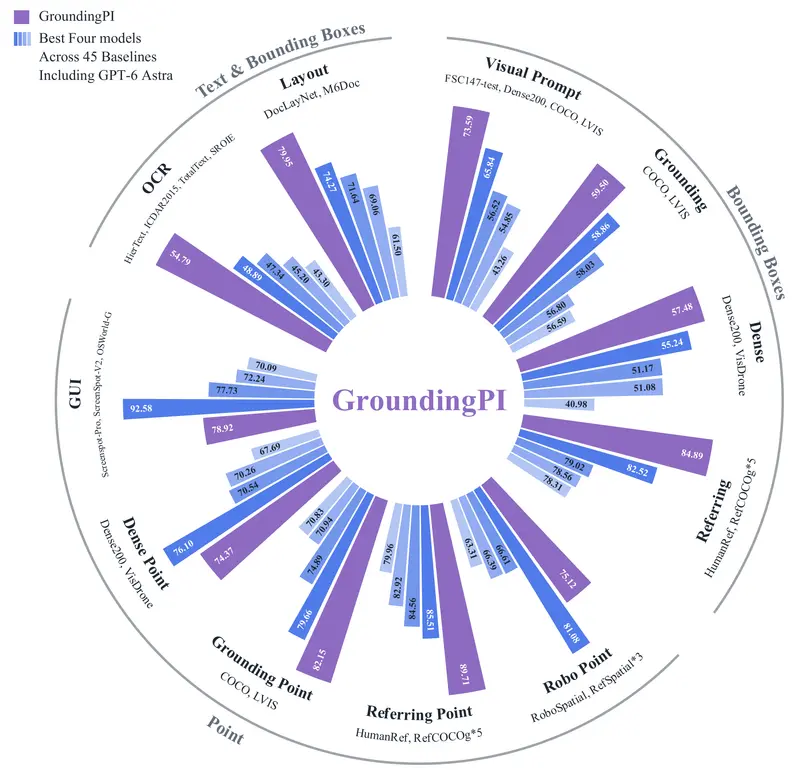
- 11 类核心感知能力:模型专注于让 AI 首先理解“物体是什么、在画面的哪个位置”,能力覆盖通用检测、密集小目标、指代定位、文字识别、文档版面、界面元素以及机器人空间定位等 11 个维度。例如,当被要求寻找“右边那个杯子的把手”时,模型必须用点或边界框精准标出目标区域,而非仅给出文本描述。
卓越的性能表现
- 基准评测登顶:在 34 项公开感知基准的综合评测中,GroundingPI 均位列第一。
- 超越前沿闭源模型:在与 OpenAI 前沿模型 GPT-6 Astra 的同维度(11 类能力等权平均)对比测试中,GroundingPI 取得了 73.68 分,优于 Astra 的 71.54 分,展现了其在物理世界视觉定位上的显著优势。
落地价值与仿真验证
尽管目前 GroundingPI 仍处于科研原型阶段,但其实验设计已直指具身智能量化部署的核心痛点,并在仿真环境中验证了两大关键价值:
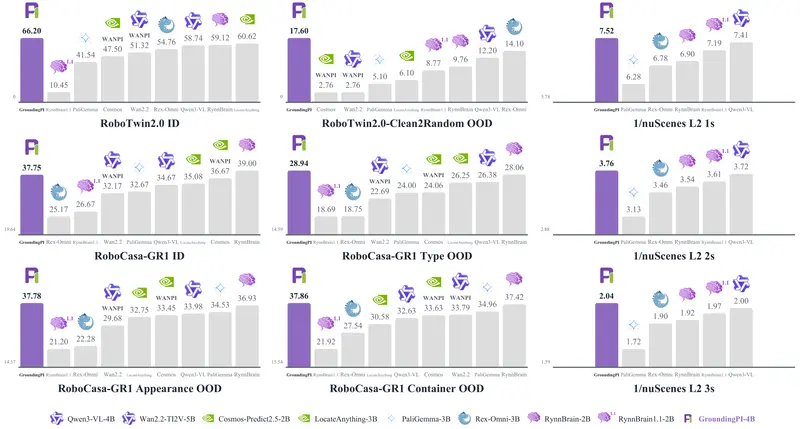
- 显著降低示教成本:传统机器人完成新任务通常需要人工采集成百上千条示教数据。而以 GroundingPI 为视觉底座的系统,仅需 50% 的示教数据,其成功率即可超越对比模型使用 75% 数据的水平。这是因为模型直接接管了传统 VLA(视觉-语言-动作)模型中耗费大量数据学习的“物体在哪”这一基础工作。
- 极强的场景泛化性:当前机器人换工位或换物体后往往需要重新训练。GroundingPI 凭借强大的感知力,在面对材质变化、物体品类变化、容器变化或背景变化等现场变量时,仍能保持极高的执行稳定性(如在散料分拣、料箱清点等场景中快速对应物品形态),为 “一套权重跨工位复用” 提供了坚实的实验支撑。
© 版权声明
文章版权归作者所有,未经允许请勿转载。