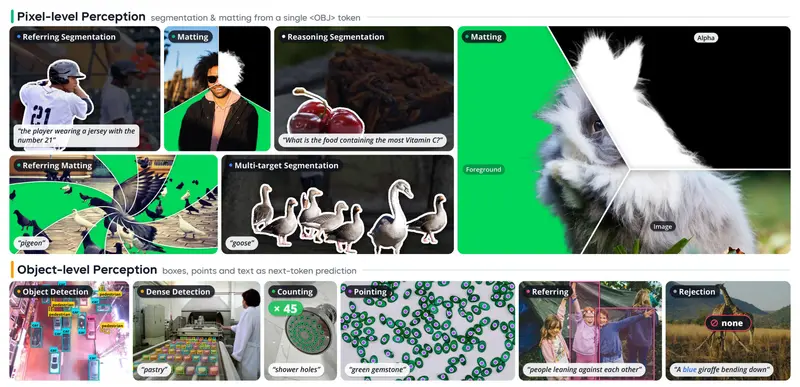
腾讯微信团队开源 WeVisOne-VL(WeChat Vision All-in-One),一款面向目标级 + 像素级任务一体化的视觉语言基础模型,主打一套模型承载多种视觉感知任务。它采用结构化 next-token 预测方案,搭配仅 9.6M 参数的轻量像素解码器,把目标检测、指代定位、计数、指点、OCR、指代分割、可提示抠图融合在同一框架,不再依赖 SAM 分割模型。
- 项目主页:https://tencent.github.io/WeVisOne-VL
- GitHub:https://github.com/Tencent/WeVisOne-VL
- WeVisOne-VL-2B:https://huggingface.co/tencent/WeVisOne-VL-2B
- WeVisOne-VL-4B:https://huggingface.co/tencent/WeVisOne-VL-4B
核心特性与技术亮点
- All-in-One 统一感知:打破了传统模型任务单一的局限,单模型即可无缝处理目标检测、指代定位、计数、指点、OCR、指代分割以及可提示抠图等多种复杂视觉任务。
- 极致轻量的像素解码器:仅需 9.6M(960 万)参数即可直接输出高分辨率的掩码(Mask)和 Alpha Matte,摆脱了对庞大独立分割模型(如 SAM)的依赖,大幅降低了推理开销。
- 可靠的拒识机制:针对视觉幻觉痛点,模型在目标不存在时会明确返回
None,而非强行生成虚假结果,显著提升了工业级应用的可靠性。
卓越的性能表现
在多项权威基准测试中,WeVisOne-VL-4B 展现了超越同量级甚至更大参数量开源基线(如 Qwen3-VL / Qwen3.5、Rex-Omni、LocateAnything 及专用分割/抠图模型)的强劲实力:
- 检测与定位:在 LVIS (F1 Mean 55.3)、Dense200 (71.3) 和 RefCOCOg test (81.8) 上大幅领先。
- 鲁棒性与计数:在 WeRef-Bench 拒识率上达到惊人的 96.4%;在 PixMo-Count 计数准确率上达到 89.6%。
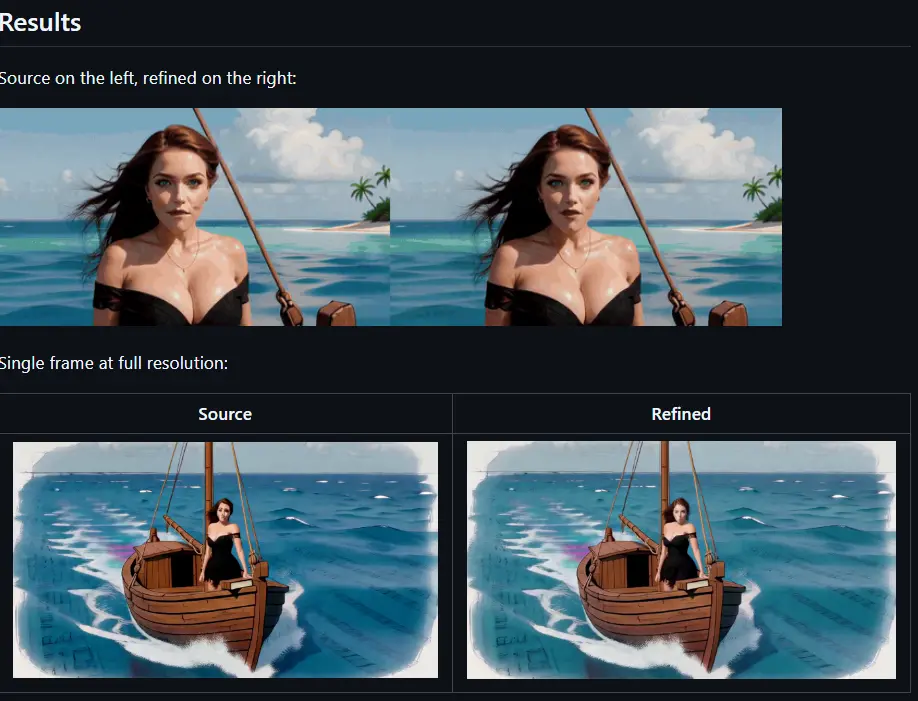
- 像素级精细操作:在 ReasonSeg val (gIoU 71.2)、P3M-500-NP 框提示抠图 (MAD 7.3) 以及 WeRefMat 文本提示抠图 (MAD 9.8) 等指标上均取得最优结果。
底层架构与工作原理
WeVisOne-VL 的高效表现得益于其精心设计的三大核心模块:
- 高质量数据引擎:由知识图谱驱动概念发现,利用多个互补的专家模型进行目标定位,再经由 VLM(视觉语言模型)进行严格校验,最终将校验后的边界框扩展为高质量的掩码和 Alpha Matte。该引擎共构建了超过 1 亿张图像的高质量标注数据集。
- 统一的任务格式化:将所有视觉任务转化为结构化文本序列。边界框和点使用坐标 token (
<0>到<1000>) 表示;若目标不存在则统一输出None;对于像素级任务,则在每个框后附加一个特殊的<OBJ>token 作为触发器。 - 高效的混合模型架构:轻量级的 9.6M 参数像素解码器,能够巧妙结合
<OBJ>token 的隐状态、对应的预测框坐标以及 Qwen3-VL ViT 的多层视觉特征,直接预测出全分辨率的精细掩码或 Alpha Matte。
© 版权声明
文章版权归作者所有,未经允许请勿转载。