谷歌研究院联合新南威尔士大学悉尼分校推出一款面向连续血糖监测(CGM)的自监督基础模型 GlucoFM。它跳出过往将血糖时序作为单一序列处理的思路,创新性采用双流分离架构,仅以0.72M可训练参数就取得了超越多款大参数量基线模型的效果。目前该项目属于科研原型,尚未达到临床产品落地标准。
- 官方介绍:https://research.google/blog/glucofm-foundation-model-for-continuous-glucose-monitoring
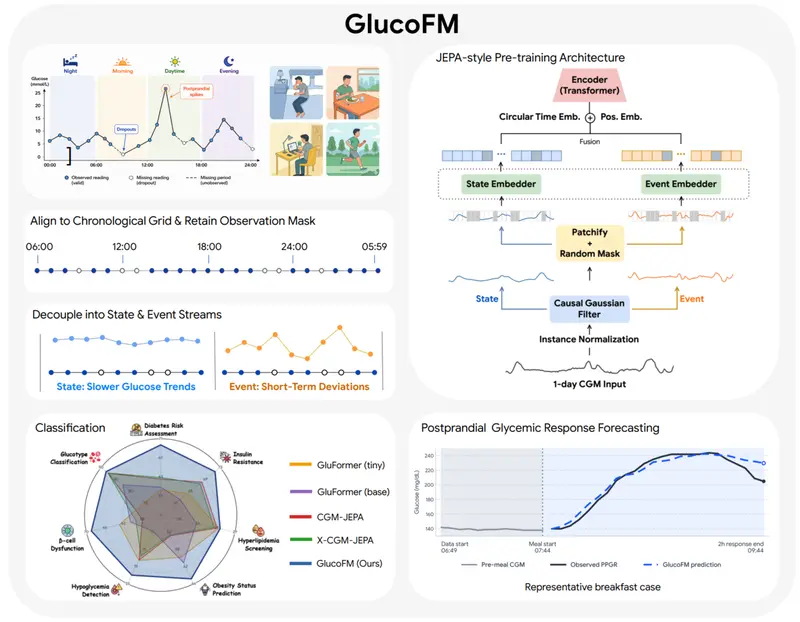
现有血糖时序模型存在的短板
CGM设备采集到的血糖曲线包含两种完全不同的信号:缓慢变化的生理基线状态,以及饮食、运动、压力、传感器噪声带来的短期波动事件。
此前主流方案,例如CGMformer、GluFormer、CGM‑JEPA,都会将整条血糖轨迹打包成一条纠缠在一起的序列送入模型。两种信号互相干扰,模型很难精准区分长期生理趋势与突发短暂波动。
同时高质量带标注的临床血糖标签获取成本高昂,也限制了监督学习方案的发展空间。
GlucoFM双流架构工作原理
模型首先将血糖记录对齐至24小时固定网格,5分钟一个采样点,全天共计288个采样位置,完整保留昼夜节律时间信息。缺失数据使用观察掩码标记,不会使用插值填充信号。
随后通过因果可学习高斯滤波器完成信号拆分:
- 状态流:滤波之后缓慢变化的血糖基线,代表长期生理状态
- 事件流:原始信号减去基线之后的残差部分,捕捉餐后、运动等短期瞬态事件
高斯滤波器带宽可在10‑60分钟区间内自动学习调整,并且采用单侧因果内核,杜绝未来数据泄露。
两条数据流各自切分为一小时长度的数据块,编码成128维Token,搭配日内循环时间特征,送入预训练框架。预训练目标采用双JEPA潜空间预测任务,掩码预测部分数据块并预测后续时序动态。
编码器本体为3层Transformer,4头注意力,隐藏层维度128,可训练参数仅 0.72M,全部参数1.18M。
预训练数据集包含来自477位受试者、超过10.9万小时无标注血糖监测数据,在单张H100显卡上即可完成训练。
实测性能结果亮眼
在14项队列‑任务评估当中,GlucoFM取得平均PR‑AUC 58.8,而同数据集最强基线模型得分仅54.7,性能相对提升约7.5%。它甚至在指标上超越了参数量大得多的GluFormer(135M)以及MOMENT(385M)。
模型优势集中体现在糖尿病风险评估、β细胞功能障碍检测、胰岛素抵抗筛查等临床核心任务;跨数据集迁移能力强劲,24项迁移测试中21项排名第一。
餐后血糖预测场景,两小时餐后血糖反应平均误差MAE低至 21.88 mg/dL,优于现有基线。即使仅使用全部数据集的20%开展训练,GlucoFM就已经能够追上使用完整数据集训练的传统CGM模型。
落地现状与重要提醒
- 当前GlucoFM仅属于科研原型基础设施,没有拿到任何医疗监管审批,不能用于诊断、治疗疾病。所有结果均来自回顾性数据分析。
- 预训练使用的最大数据集是非公开数据;截止2026‑08‑26,模型权重检查点还未放出。论文承诺后续开源代码与复现脚本。
- 推理门槛低,24小时血糖窗口任务可以直接在CPU或者设备端容器运行,很方便后续研究团队复现与二次开发。
核心亮点小结
- 首创双流分离思路,拆分血糖基线状态流和短期事件流,解决信号纠缠问题
- 极小0.72M参数量,性能碾压上一代大参数量时序模型
- 自监督预训练降低了对于昂贵临床标注数据的依赖
- 擅长糖尿病相关风险筛查,具备很强跨数据集迁移能力
- 仅科研用途,暂不可商用、临床使用
© 版权声明
文章版权归作者所有,未经允许请勿转载。