企业大模型厂商 Cohere 正式发布新一代文档解析产品 Parse‑v5.0(Parse 5),一款面向大批量文档处理、RAG知识库数据摄入场景的轻量视觉语言模型。无需单独的OCR环节,就能够直接解析PDF、PPT、图片文件,输出结构化 Markdown 文档,为金融、保险、政务等文档密集行业提供性价比更高的文档提取方案。
- 官方介绍:https://cohere.com/blog/parse
- Demo:https://huggingface.co/spaces/CohereLabs/cohere-parse
Parse 5 属于23亿参数视觉语言模型,基于 North‑Micro‑Vision‑Instruct 架构打造,上下文窗口大小为8192 Token,模型运行内存占用仅约 4.6GB,轻量化的特性十分适合企业部署。
文件输入以base64编码形式传入,支持PDF、PPT、JPEG页面。最核心的亮点是没有独立前置OCR步骤,模型单次推理就可以一次性识别页面内全部元素:文本阅读顺序、列表、表单键‑值对、表格、配图说明以及各个元素对应的边框坐标。表格内容会直接渲染成HTML格式,方便下游系统二次加工。
模型稳定支持阿拉伯语、英语、法语、德语、意大利语、日语、韩语、葡萄牙语、西班牙语共9种语言;其余语种可通过零样本能力识别,但解析精度会有所下降。同时它提供两种输出模式,默认输出单页 Markdown;output_format="blocks" 则返回结构化数据块,附带表格HTML、边框坐标信息,可实现原文内容的溯源定位。
部署渠道与适用对象
该模型已经正式投产可用,没有内测等待名单,可通过多种途径接入:Cohere Parse API、Microsoft Foundry、AWS SageMaker,或是单租户隔离环境 Model Vault 私有部署。
- 中小企业:走按量计费API,免费密钥即可上手,适合已经搭建好RAG知识库的团队;
- 大型企业:有数据本地留存、物理隔离需求,可以选择 Model Vault 私有部署;
- 成本平衡点:按月处理页数高于167万页时,Medium规格专用实例成本才优于按量API;XL实例盈亏线约287万页。月处理量较低时,直接调用API更加划算。
目标落地行业覆盖金融服务、保险、医疗生命科学、政府部门、电信、能源与制造业。典型场景包含知识库RAG文档导入、发票理赔自动化流水线、合同档案检索、AI智能代理获取文档上下文。
基准成绩:看清得分背后的评估口径
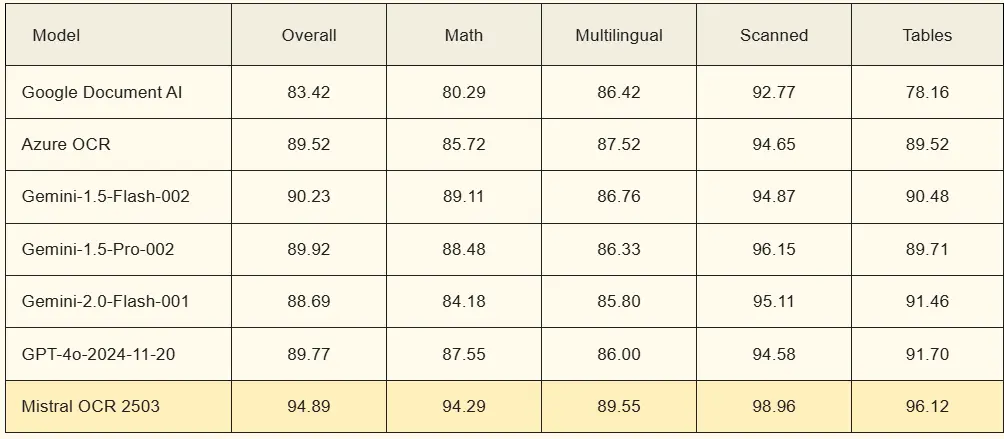
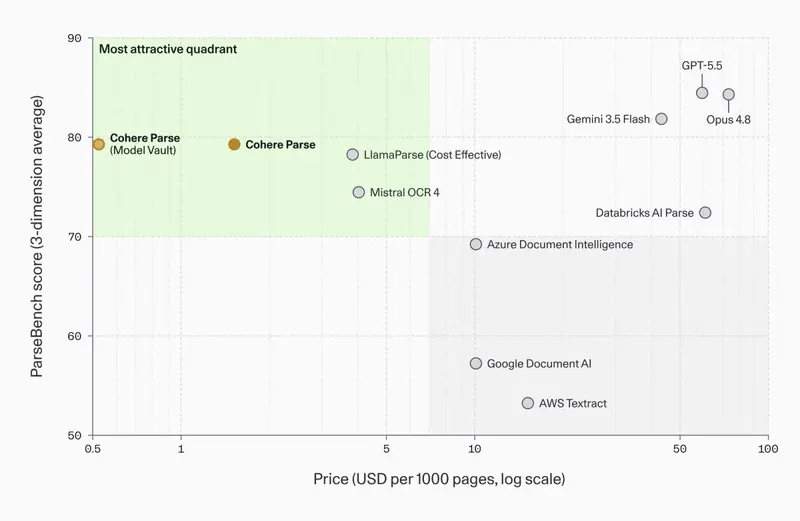
Cohere 公布其在 ParseBench 评测得分 79.2。这份基准来自 LlamaIndex,一共设置五大评估维度:表格识别、图表解析、内容保真度、语义格式、视觉定位。
这里79.2仅取表格、内容保真度、语义格式三项指标取平均值,图表、视觉定位两项未计入。
在这三项维度对比当中,Parse 5(79.2)领先 Mistral OCR 4(74.5)、Azure Document Intelligence(74.3)、Databricks AI Parse(72.4)。
而完整五项维度排行榜当中,各家厂商分数都明显下降,因此该成绩并不等同于综合榜单排名,企业落地之前建议拿自身业务文档开展实测验证效果。
定价方案
- 按量计费API:1.5美元 / 1000页,折合每页 0.0015 美元;
- Model Vault 专用实例
- Medium:4美元/小时,包月2500美元
- XL:7美元/小时,包月4300美元
整体定位主打高吞吐量、高性价比的文档处理,而非追求行业顶尖的极限解析精度。
© 版权声明
文章版权归作者所有,未经允许请勿转载。