Cohere Labs 正式发布了 North-Micro-Vision-Instruct,一款拥有 24 亿(2.4B)参数的开放权重视觉语言模型(VLM)。该模型采用 Apache 2.0 许可证,专为多模态应用设计,其核心突破在于支持原生分辨率图像输入,能够在不牺牲宽高比和精细细节的前提下,高效处理文档、表格、图表及自然图像。
- 模型:https://huggingface.co/CohereLabs/North-Micro-Vision-Instruct
核心亮点
- 📐 原生分辨率支持:
不同于传统模型将图像压缩为固定小方块,North Micro Vision 保留了输入图像的原始宽高比和空间结构。其视觉编码器支持最高 1654×2339 像素(约 200 dpi 的 A4 页面)的原生分辨率,使其在文档理解、OCR 和细粒度视觉定位任务中表现卓越。 - 🚀 轻量化与边缘部署:
2.4B 的参数规模使其成为目前最小的 VLM 之一。结合量化技术,该模型可在笔记本电脑、边缘设备甚至移动端硬件上流畅运行,降低了多模态 AI 的部署门槛。 - 🌍 多语言与多领域适应:
训练数据涵盖多种语言及广泛的视觉领域(文档、图表、自然图像等),支持多语言评估和特定领域的微调定制。
技术架构
North Micro Vision 采用三部分架构设计:
- 原生分辨率视觉编码器:基于 SigLIP 2 SO400M 预训练,引入连续旋转位置嵌入(C-RoPE),结合 2D RoPE 和学习的 1D 位置嵌入,以保留高分辨率下的空间结构。
- 投影器:遵循 DeepStack 理念,将多层视觉编码器的 Patch 嵌入注入到语言模型的早期层,使 LLM 能访问不同抽象层次的视觉特征。
- 紧凑语言模型:基于 20 亿参数的 North Micro LLM,采用 Command A+ 架构,交错使用滑动窗口注意力层和全局注意力层,平衡了长上下文处理能力与计算效率。
训练策略:四阶段课程学习
| 阶段 | 目标 | 关键操作 |
|---|---|---|
| 阶段 1 | 基础对齐 | 冻结 LLM,仅训练视觉编码器和投影器。分辨率从 384×384 起步,混合密集描述与 OCR 数据。 |
| 阶段 2.1 | 分辨率提升 | 分辨率提至 1024×1024,联合训练全模型。 |
| 阶段 2.2 | 高分辨率适配 | 分辨率上限提至 1654×2339(A4 文档级),继续联合训练,强化文档布局理解。 |
| 阶段 3 | 指令调优 | 使用 5000 万示例进行多模态指令跟随训练,强调 OCR、图表、定位及通用 VQA。 |
| 阶段 4 | 偏好优化 | 应用简化的混合偏好优化(MPO),结合 DPO 与 SFT 损失,提升安全性、格式化及响应质量。 |
基准测试表现
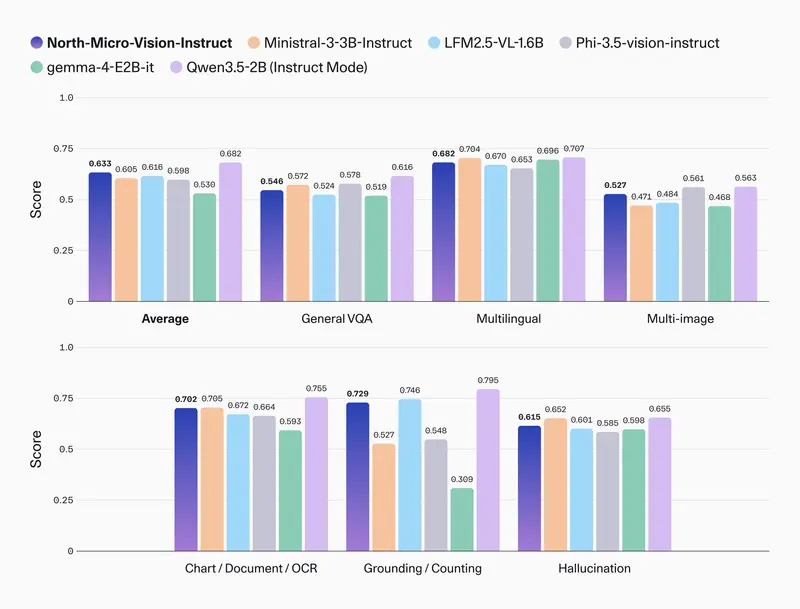
North Micro Vision 在文档理解和视觉定位方面展现出与其规模不相称的强大能力:
- 文档/OCR:在 DocVQA (VAL) 上得分 0.921,接近 Qwen3.5-2B-Instruct (0.926);在 ChartQA (Test) 上得分 0.808,优于多数同量级模型。
- 视觉定位:在 RefCOCO 平均得分上达到 0.732,显著优于 Ministral-3-3B (0.317) 和 Gemma-4-E2B (0.084),体现了原生分辨率对空间信息保留的优势。
- 通用 VQA:在 MMBench 和 MMStar 等基准上表现稳健,虽略低于部分更大参数模型,但在 2B 级别中极具竞争力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。