MiniMax 正式发布了其最新一代旗舰模型 MiniMax-M3。这是一款总参数量达 4280 亿、激活参数量约 230 亿 的原生多模态模型。M3 不仅支持高达 100 万 Token 的超长上下文窗口,更引入了创新的 MiniMax 稀疏注意力(MSA) 架构,在保持顶尖性能的同时,将长文本处理效率提升了数个数量级。此外,M3 具备直接操作桌面电脑的能力,标志着 AI 从“内容生成”向“任务执行”迈出了关键一步。
- GitHub:https://github.com/MiniMax-AI/MiniMax-M3
- Hugging Face:https://huggingface.co/MiniMaxAI/MiniMax-M3
- ModelScope:https://www.modelscope.cn/collections/MiniMax/MiniMax-M3
MiniMax M3 正式发布:首个集前沿编码、100万上下文与原生多模态于一身的开放权重模型,MSA 架构实现推理速度 15 倍加速
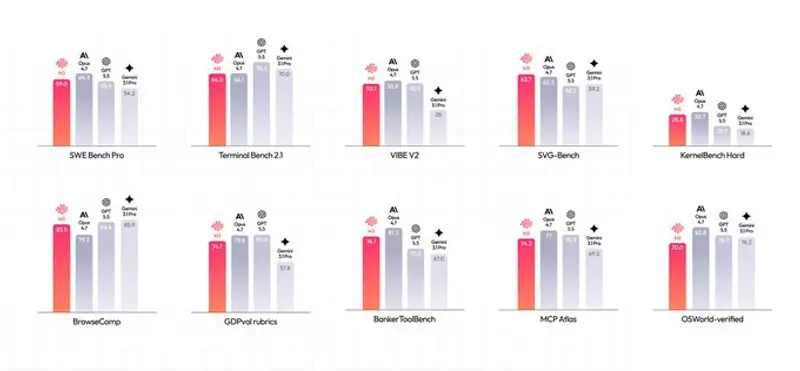
核心亮点:原生多模态、极致效率、智能体就绪
1. 原生多模态融合
- 深层语义理解:不同于后期拼接的多模态模型,M3 从训练初始阶段即采用混合模态训练,实现了文本、图像和视频之间更深层次的语义对齐与融合。
- 视频与图像输入:能够精准理解长视频内容、复杂图表及高分辨率图像,为多媒体分析提供强大支持。
2. MSA 架构带来的效率革命
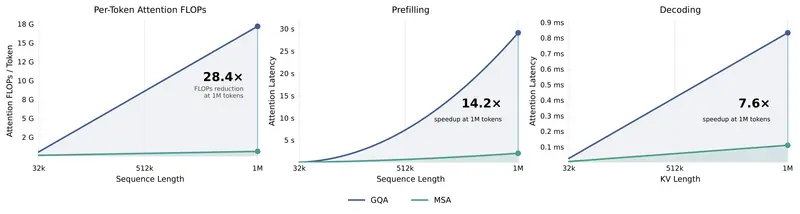
- 百万级上下文轻松驾驭:引入专为百万级 Token 设计的 MiniMax 稀疏注意力(MSA) 算子。相比传统的 GQA,MSA 在保持模型质量的同时,大幅降低了计算开销与内存占用。
- 速度飞跃:在 1M 上下文长度下,相比前代 M2 模型:
- 预填充(Prefill)速度提升 9 倍
- 解码(Decode)速度提升 15 倍
- 每 Token 计算量降至原来的 1/20
3. 强大的智能体与编程能力
- 桌面操作能力:M3 能够理解屏幕内容并直接操作鼠标、键盘等界面元素,实现真正的“所见即所得”自动化。
- 前沿编码表现:在长周期智能体基准测试中达到前沿水平,擅长处理复杂的代码重构、调试及多文件协同开发任务。
双模式推理:灵活适配不同场景
M3 支持两种推理模式,用户可根据任务需求自由切换:
| 模式 | 适用场景 | 特点 |
|---|---|---|
| Thinking (思考模式) | 复杂逻辑推理、数学解题、长周期智能体协作、深度代码分析 | 启用深度思维链,牺牲少量延迟以换取更高的准确率与逻辑严密性。 |
| Non-Thinking (非思考模式) | 日常聊天、即时代码补全、简单问答、低延迟交互 | 快速响应,专注于流畅性与即时性,适合对时间敏感的应用。 |
技术架构解析:MiniMax 稀疏注意力 (MSA)
MSA 是 M3 高效处理超长上下文的核心引擎。它通过动态稀疏化注意力矩阵,仅关注最相关的 Token 关联,从而避免了传统稠密注意力在序列增长时的平方级复杂度爆炸。这使得 M3 能够在消费级或中等规模集群上高效运行百万级上下文的推理任务,极大地降低了部署成本。
对于追求高效、深度且具备多模态处理能力的开发者与企业而言,MiniMax-M3 提供了一个兼具性能与成本优势的全新选择。
© 版权声明
文章版权归作者所有,未经允许请勿转载。