百度发布 PP-OCRv6:轻量级 OCR 新标杆,3450 万参数模型精度超越 Qwen3-VL-235B 等千亿级 VLM,支持 50 种语言与工业场景识别,CPU 推理提速 5.2 倍
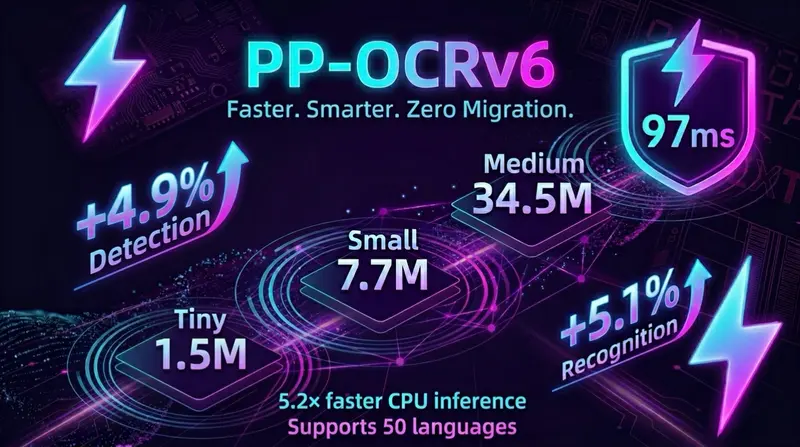
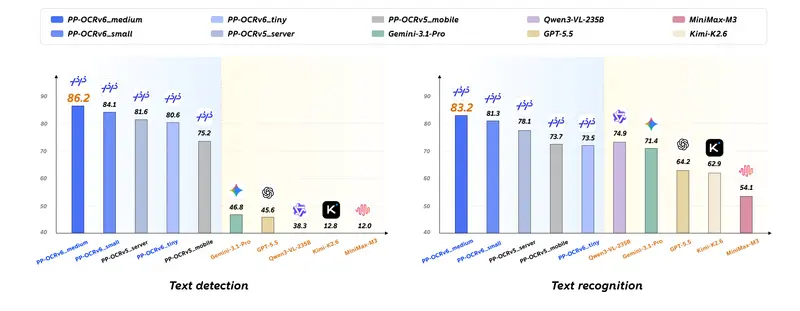
在光学字符识别(OCR)领域,百度PaddleOCR 团队正式推出了新一代旗舰模型 PP-OCRv6。该系列模型参数量仅在 150 万至 3450 万之间,却通过架构创新与数据优化,实现了检测准确率提升 4.9%、识别准确率提升 5.1% 的显著突破。更令人瞩目的是,其 Medium 版本在多项基准测试中,以极小的体量超越了 Qwen3-VL-235B、GPT-5.5 等千亿参数视觉语言大模型(VLM),重新定义了轻量级 OCR 的性能边界。
- GitHub:https://github.com/PaddlePaddle/PaddleOCR
- HuggingFace:https://huggingface.co/collections/PaddlePaddle/pp-ocrv6
- ModelScope:https://www.modelscope.cn/collections/PaddlePaddle/PP-OCRv6
核心亮点:小身材、大能量、全覆盖
1. 精度逆袭,超越巨型 VLM
- 极致效率比:PP-OCRv6_medium(34.5M 参数)在检测 Hmean 上达到 86.2%,识别准确率达到 83.2%,分别比前代 Server 版提升 4.6% 和 5.1%。
- 降维打击:在参数量低几个数量级的情况下,其专业 OCR 性能优于通用的千亿级 VLM,证明了专用模型在特定任务上的不可替代性。
2. 50 种语言,单一模型统一支持
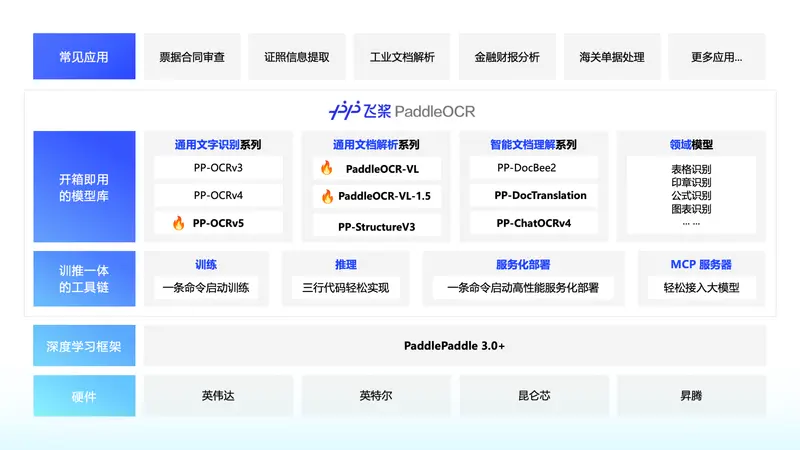
- 多语种无缝切换:一个模型即可覆盖中文、英文、日文及 46 种拉丁语系语言,无需为不同语种加载不同权重,极大简化了部署流程。
- 全球通用:适用于跨国业务、多语言文档数字化及国际化应用开发。
3. 工业场景深度增强
- 攻克难点:针对传统 VLM 难以处理的数码显示屏、点阵字符、轮胎印字、PCB 板标识、CAD 图纸等复杂工业场景进行了专项优化。
- 高鲁棒性:在低对比度、不规则排列及特殊字体环境下,依然保持极高的识别稳定性。
4. 极速推理,全端部署
- CPU 加速:基于 OpenVINO 优化,Medium 档 CPU 推理速度提升 5.2 倍。
- 移动端友好:Tiny 档在 Apple M4 芯片上加速 6.1 倍,A100 GPU 上仅需 0.13 秒即可完成处理。
- 三档灵活选择:
- Tiny (1.5M):面向极致资源受限的边缘设备、浏览器插件。
- Small (7.7M):面向移动端 App、IoT 设备。
- Medium (34.5M):面向服务器、高性能边缘盒子。
技术架构创新
PP-OCRv6 围绕统一的 MetaFormer 风格构建,引入了多项轻量级架构创新:
- LCNetV4 骨干网络:采用结构重参数化技术,在训练时保持多分支结构以提升表达能力,推理时合并为单路结构以降低延迟。
- RepLKFPN 检测颈部:包含膨胀的可重参数化深度卷积,增强了对多尺度文本特征的融合能力。
- EncoderWithLightSVTR 识别颈部:融合局部-全局注意力机制与加性跳跃连接,提升了长文本及复杂排版下的识别精度。
对于需要在边缘设备、移动端或低成本服务器上实现高质量文字识别的团队而言,PP-OCRv6 无疑是当前的最佳选择。
© 版权声明
文章版权归作者所有,未经允许请勿转载。