阿里发布 Qwen-Robot Suite:具身智能“手脑脚”三位一体,含操作模型 Manip、导航模型 Nav 与世界模型 World,基于 >38,000 小时开源数据训练,实现跨本体零样本泛化
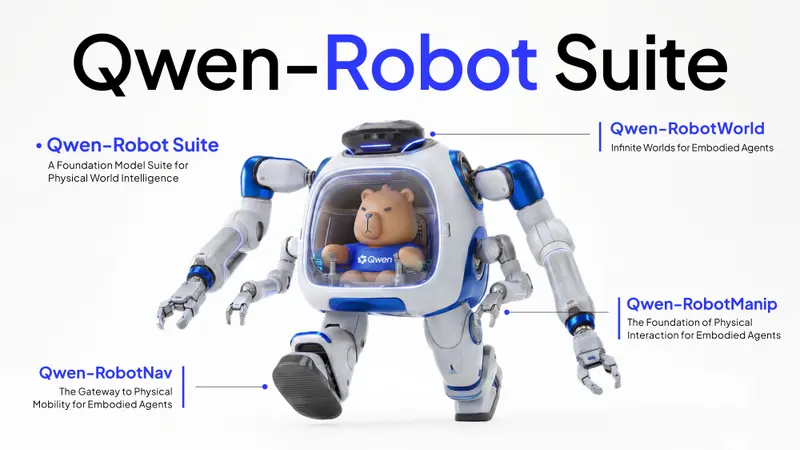
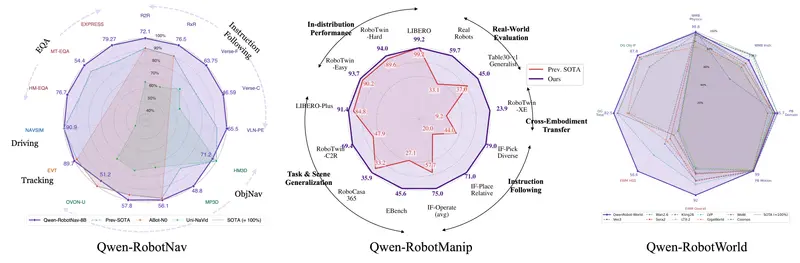
阿里巴巴正式发布了千问家族首个完整的具身智能模型套件 —— Qwen-Robot Suite。该套件包含 Qwen-RobotManip(操作)、Qwen-RobotNav(导航)和 Qwen-RobotWorld(世界模型)三大基础模型,旨在为机器人装上“灵巧的手”、“认路的脚”和“会思考的大脑”。通过统一的自然语言接口与大规模开源数据训练,Qwen-Robot Suite 成功弥合了视觉语言理解与物理控制之间的鸿沟,让不同形态的机器人迈向真实落地有了可靠的“通用底座”。
- 官方介绍:https://qwen.ai/blog?id=qwen-robotsuite
核心组件:手、脚、脑的协同进化
1. Qwen-RobotManip:物理交互的基石
- 跨本体对齐:通过统一的 80 维状态-动作表示及相机坐标系下的增量位姿,屏蔽了单臂、双臂、灵巧手等不同机器人本体的形态差异。
- 海量开源数据:基于完全由开源数据构建的 >38,100 小时操作语料库(含人类视频迁移合成),实现了大规模多机型训练。
- 卓越泛化能力:在 RoboChallenge Table30 v1 通用赛道中排名第一,包揽冠亚;在 LIBERO-Plus 等分布外泛化评测中大幅超越 prior SOTA。
2. Qwen-RobotNav:智能体的行动入口
- 统一导航任务:单一模型权重即可处理指令跟随、目标搜索、目标追踪、自动驾驶及具身问答(EQA)五大领域任务。
- 参数化视觉分配:通过可控的视觉 Token 预算、时间衰减等参数,动态适配不同任务对历史信息的需求,无需修改模型架构。
- 零样本真机部署:在 Unitree Go2 四足机器人上,仅使用单目低分辨率相机即可在开放环境中实现强大的零样本导航与循证问答能力。
3. Qwen-RobotWorld:预测物理未来的无限世界
- 自然语言动作接口:将末端执行器位姿、转向指令等统一为自然语言描述,使 20 余种本体类型和 500+ 动作类别得以联合训练。
- 内化物理常识:采用双流 MMDiT 架构,以完整的多模态大语言模型作为动作编码器,隐式学习刚体、流体、重力等物理规律。
- 开源榜首:在 EWMBench、WorldModelBench 等 4 个基准测试中位列开源模型第一,运动保真度超越亚军 33%。
技术突破:弥合感知与行动的鸿沟
| 挑战 | 传统方案局限 | Qwen-Robot Suite 解决方案 |
|---|---|---|
| 形态异构 | 不同机器人需单独训练,数据无法互通 | 统一状态-动作空间,实现跨本体信号提取与迁移 |
| 任务多样 | 导航、操作、预测需独立模型,难以协同 | 自然语言统一接口,将物理动作标准化为语言指令 |
| 数据稀缺 | 真实机器人数据采集成本高、规模小 | 人-机迁移合成管线,利用开源人类视频生成数万小时机器人数据 |
| 长程任务 | 缺乏记忆与规划,易陷入局部失败循环 | VLM 上层规划 + VLA 底层执行,具备子任务分解与失败恢复能力 |
从模型到智能体:闭环系统实践
Qwen-Robot Suite 不仅是一组独立模型,更是一个可组合的智能体框架。通过 Qwen-RobotClaw 内部项目,通用 Qwen VLM 智能体可以将这三个模型作为“物理世界工具”进行调用:
- 开放式任务执行:Qwen-Omni 观察场景并语音提出随机任务,Qwen-RobotManip 即时执行,无需预定义列表。
- 长程操作与失败恢复:Qwen-3.5 担任规划器,将复杂指令(如“清理杂乱桌面”)分解为原子任务,并在执行僵局时动态调整策略,显著提升成功率。
- 具身问答与探索:结合 Qwen-RobotNav,在 HM-EQA 等长程 3D 探索任务中取得显著进步,并已部署于真实环境。
Qwen-Robot Suite 的发布,标志着具身智能从“单一技能演示”迈向“通用物理智能”的关键一步。它证明了通过大规模开源数据、统一的自然语言接口以及精心设计的对齐机制,我们可以构建出既懂物理规律又能灵活行动的机器人基础模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。