Zyphra 发布 Zamba2-VL:开源混合 Mamba2-Transformer 视觉语言模型,首 Token 延迟降低一个数量级,支持 1.2B/2.7B/7B 多规模边缘部署
在多模态大模型日益普及的今天,高昂的计算成本与漫长的首字延迟(TTFT)仍是阻碍其实时交互与端侧落地的主要障碍。Zyphra 正式发布了 Zamba2-VL,这是首个基于完全开源的混合 Mamba2-Transformer 架构构建的视觉语言模型(VLM)系列。通过引入状态空间模型(SSM),Zamba2-VL 在保持竞争力的准确率的同时,将推理速度提升了约 一个数量级,为边缘设备与实时应用开辟了新的可能性。
- GitHub:https://github.com/Zyphra/transformers/tree/zamba2-vl
- 模型:https://huggingface.co/collections/Zyphra/zamba2-vl
核心亮点:极速、高效、开源
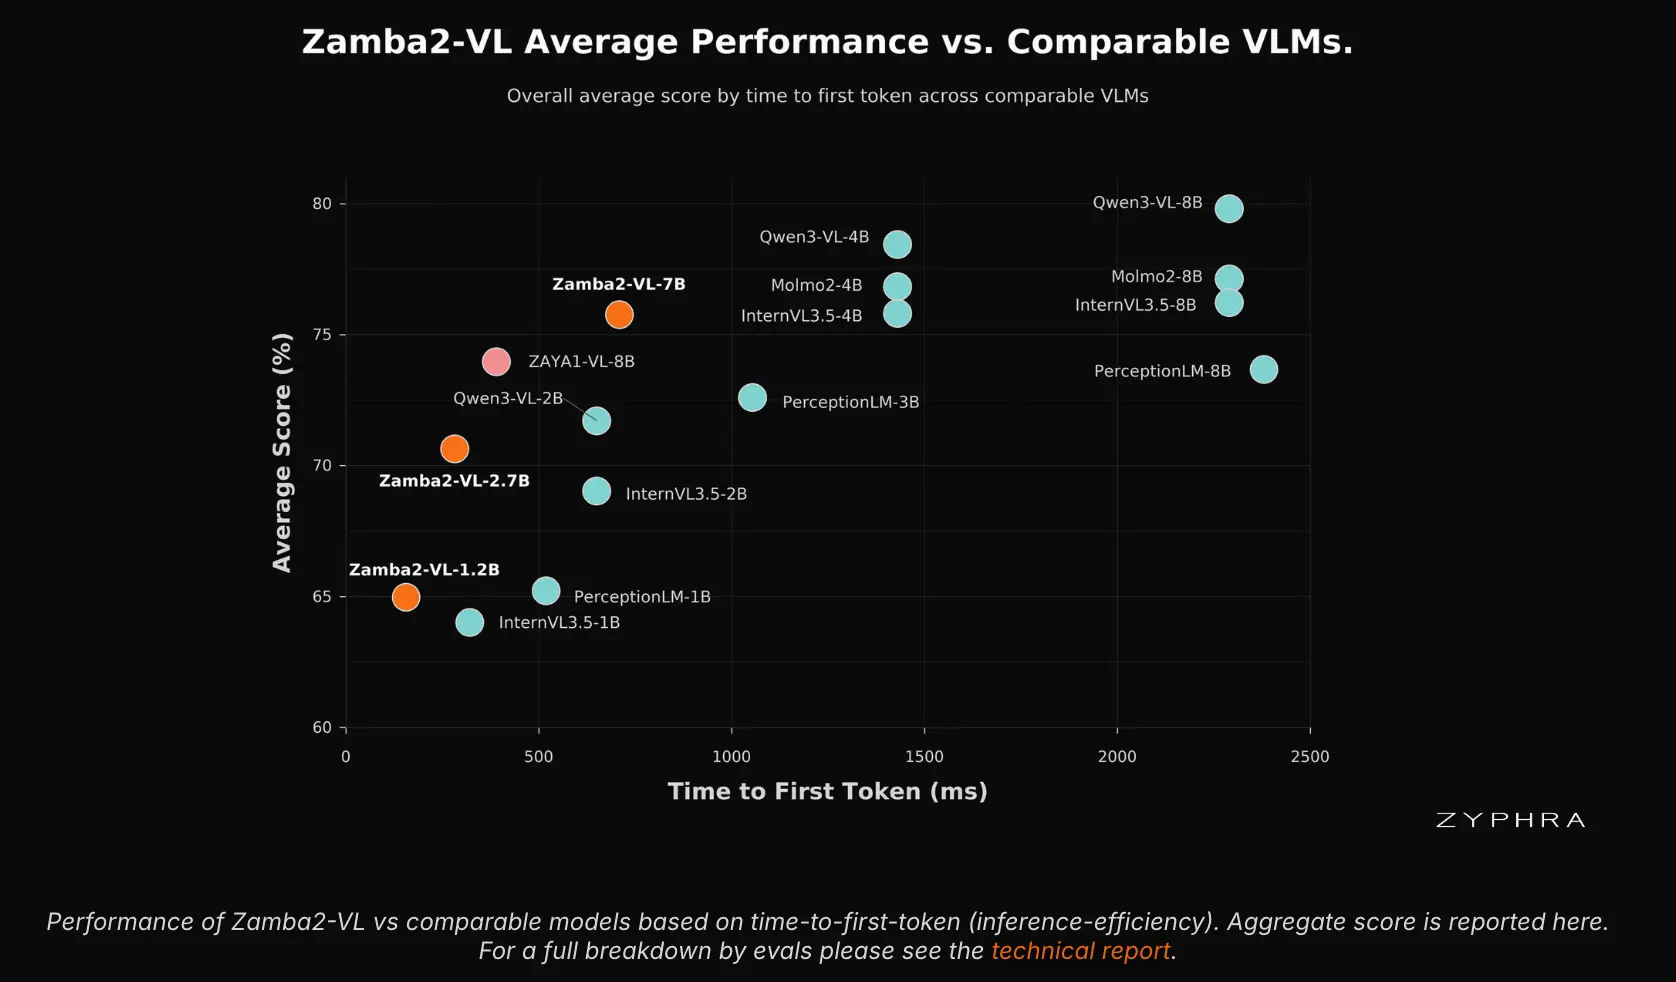
1. 突破注意力瓶颈,TTFT 降低 10 倍
- 线性时间预填充:传统 Transformer 的注意力机制随序列长度呈平方级增长,而 Zamba2-VL 利用 Mamba2 层的固定大小循环状态,实现了近线性时间的预填充。
- 极低延迟:在 32k token 的长上下文测试中,其首 Token 生成时间远超同等规模的纯 Transformer 模型,且在相似延迟下得分更高。
2. 创新的混合架构设计
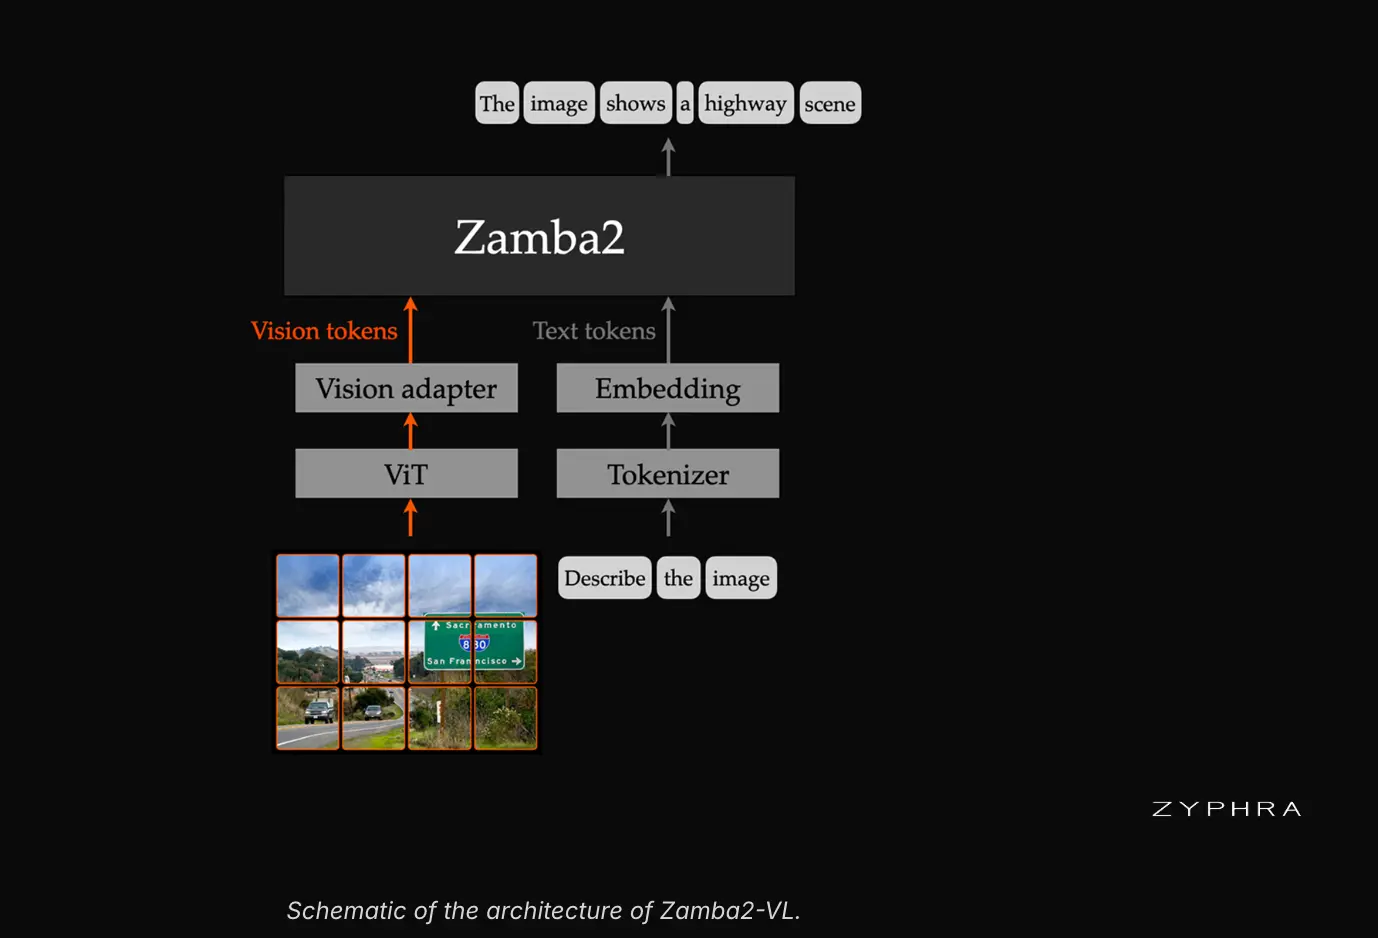
- Mamba2 + Shared Transformer:骨干网络由承担大部分廉价计算的 Mamba2 状态空间层 与保留上下文检索能力的 少量共享 Transformer 块 组成。
- LoRA 适配器增强:每个共享注意力块均配备独特的 LoRA 适配器,在提升表达能力的同时控制参数量。
- 强力视觉编码器:配对 Qwen2.5-VL 的视觉 Transformer,支持 2D 旋转位置嵌入与原生动态分辨率处理,确保对复杂图表与文档的高精度理解。
3. 多规模覆盖,Apache 2.0 开源
- 灵活部署:提供 1.2B、2.7B 和 7B 三种参数规模,分别针对极致边缘设备、中型终端及高性能本地服务器。
- 完全开放:模型权重、训练数据说明及推理代码均在 Hugging Face 和 GitHub 上公开,采用宽松的 Apache 2.0 许可证,便于商业集成与二次开发。
性能表现:计数与文档理解见长
在 14 个基准测试中,Zamba2-VL 展现了特定的优势领域:
| 能力维度 | 表现亮点 | 备注 |
|---|---|---|
| 视觉计数 | 极强 (PixMoCount: 62.5 @ 1.2B) | 擅长识别与统计图像中的物体数量 |
| 文档理解 | 优秀 (DocVQA: 90.9 @ 2.7B) | 能精准提取表格、表单及密集文本信息 |
| 基础感知 | 有竞争力 | 支持单/多图像理解及基础定位 |
| 知识推理 | 相对较弱 | 在 MMMU/MathVista 等复杂推理任务上落后于更大规模的基线模型 |
适用场景
- 移动端 AI 助手:1.2B/2.7B 版本可在手机或平板上流畅运行,实现实时的拍照问答与文档扫描。
- 工业质检与计数:利用其强大的视觉计数能力,快速统计生产线上的物品数量或缺陷点。
- 企业文档自动化:高效处理发票、合同及报表的 OCR 与信息提取,降低人工录入成本。
- AR/VR 实时交互:低延迟特性使其成为增强现实眼镜中实时环境理解的理想后端。
局限与挑战
- 推理硬件依赖:目前优化的内核主要面向 CUDA GPU,CPU 路径速度较慢,限制了在非 GPU 设备上的普及。
- 复杂推理短板:在需要深厚世界知识或多步逻辑推理的任务上,表现不如参数量更大的纯 Transformer 模型。
- 自托管门槛:用户需自行部署推理服务,对运维能力有一定要求。
Zamba2-VL 证明了 混合架构(Hybrid Architecture) 是多模态模型走向高效化与普及化的重要方向。它不再盲目追求参数规模的膨胀,而是通过架构创新,在速度、成本与性能之间找到了新的平衡点。
© 版权声明
文章版权归作者所有,未经允许请勿转载。