快手 Keye 发布 Keye-VL-2.0-30B-A3B:300 亿参数多模态旗舰,DSA 架构支持 1 小时长视频无损理解,时间定位能力媲美 Gemini-3-Flash
快手 Keye 团队正式发布了 Keye-VL-2.0-30B-A3B,这是 Keye 系列最新的 300 亿参数旗舰基础模型。作为首个在生产环境中落地 DSA(动态稀疏注意力) 架构的多模态模型,它不仅在长视频理解上实现了突破,更开启了 Keye 家族第一代智能体(Agent)能力的大门,标志着多模态模型从“被动感知”向“主动执行”的重要演进。
- 模型:https://huggingface.co/Kwai-Keye/Keye-VL-2.0-30B-A3B
核心亮点:长视频理解与智能体原生
1. 卓越的视频理解与时间定位
- 1 小时长视频无损处理:基于 DSA 原生长上下文架构,支持长达 256K 的超长上下文,实现对一小时视频的精确理解,且计算效率极高。
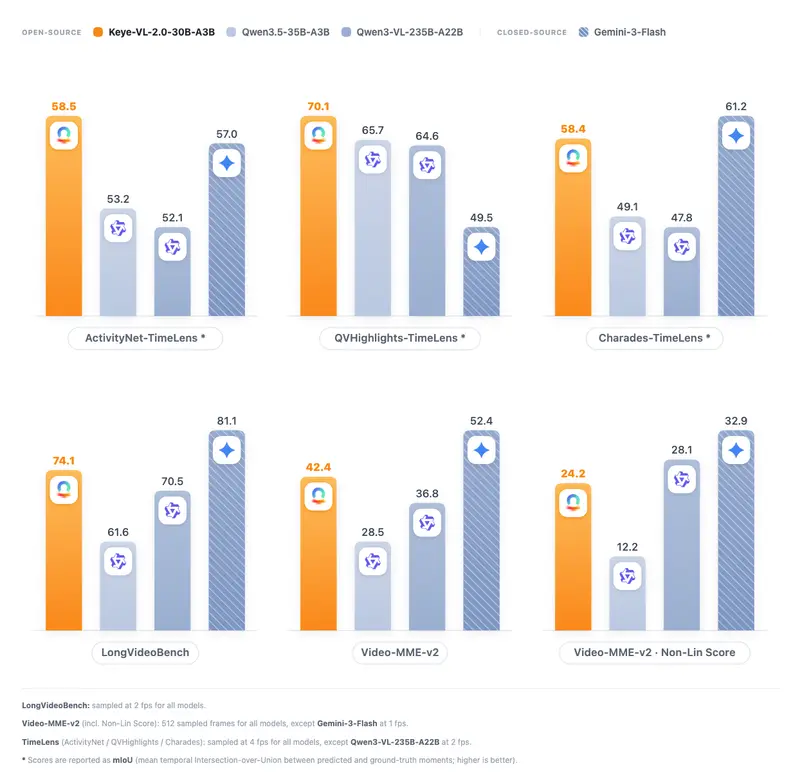
- 细粒度时间感知:在 Charades-TimeLens 基准上达到 58.4 mIoU,与最强闭源基线持平;在 ActivityNet-TimeLens 上达到 58.5 mIoU,超越 Gemini-3-Flash。
- 长上下文扩展性:在 VideoMME V2 中,随着输入帧数增加(64->512帧),准确率不降反升(35.3%->42.4%),非线性推理得分显著提升。
2. 内置智能体协作机制
- 多模态 Agent 能力:内置代码、工具和搜索智能体能力,支持仓库级任务、API 风格工具使用及基于网络的信息搜索。
- 视觉自纠正工作流:能够根据视觉反馈自动调整执行策略,展现强大的系统级编排能力。
3. 高效推理与训练堆栈
- DSA 架构:通过稀疏注意力和目标特征聚合,显著降低长序列预填充成本。
- 技术集成:整合 ExtraIO、异构 ViT-LM 并行、激活优化及自定义内核,大幅提升训练吞吐量与推理速度。
4. 稳健的后训练与数据策略
- 以数据为中心:利用 Keye-VL-1.5 视觉编码器及合成思维链数据,强化 OCR、图表理解及推理连贯性。
- 减少幻觉:通过 MOPD、Context-RL 及高信噪比数据筛选,优化跨模态专家融合,确保长上下文决策的稳定性。
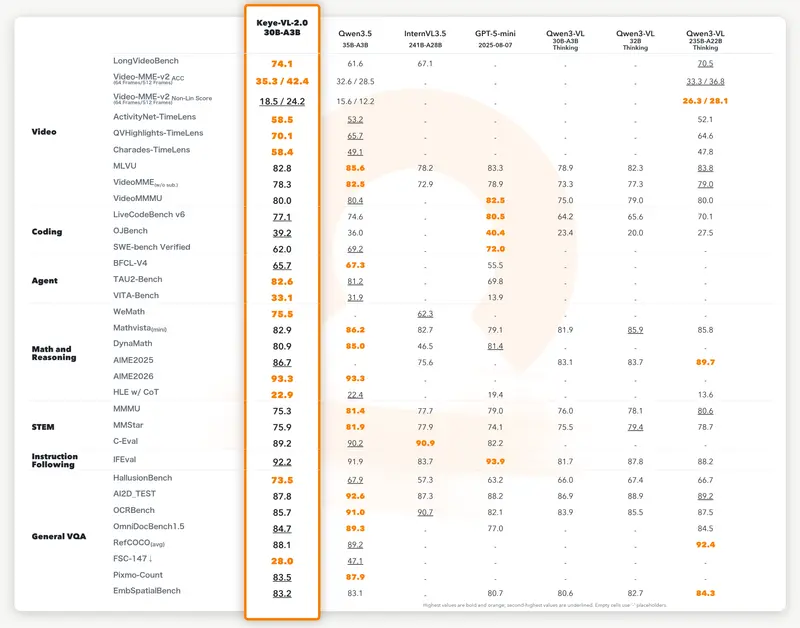
基准测试表现:小参数的大能量
| 维度 | 关键指标/表现 | 对比优势 |
|---|---|---|
| 长视频理解 | LongVideoBench: 74.1 | 超越 Qwen3.5-35B 及 Qwen3-VL-235B (2350 亿参数) |
| 时间定位 | ActivityNet-TimeLens: 58.5 mIoU | 超越 Gemini-3-Flash |
| 长上下文扩展 | VideoMME V2 (512 帧): 42.4% | 竞品性能随长度下降,Keye 持续上升 |
| 综合规模效应 | 300 亿参数 | 时间理解能力超越 2000 亿+ 参数开源模型 |
技术架构解析
- DSA (Dynamic Sparse Attention):核心创新点,允许模型在处理超长序列时仅关注关键信息,实现几乎无损的推理能力。
- 异构 ViT-LM 并行:优化视觉编码器与大语言模型的协同工作,提升多模态融合效率。
- Context-RL:引入上下文强化学习,增强模型在长对话或长视频中的逻辑一致性。
适用场景
- 长视频内容分析:电影、剧集、会议记录的完整理解、摘要生成及关键片段定位。
- 复杂事件检索:在海量视频库中精准查找特定动作、物体或行为发生的时间点。
- 多模态智能体任务:基于视频内容的自动化操作、代码生成及外部工具调用。
- 文档与图表理解:高精度识别视频或图像中的复杂表格、流程图及 OCR 文字。
Keye-VL-2.0-30B-A3B 的发布证明了架构创新与数据质量可以弥补参数规模的差距。通过在 300 亿参数级别实现超越千亿甚至两千亿参数模型的性能,它为多模态 AI 的高效部署树立了新标杆。
更重要的是,它将长视频理解与智能体执行完美结合,为构建能够“看懂世界并采取行动”的 AI 应用提供了强大的基础模型支持。
© 版权声明
文章版权归作者所有,未经允许请勿转载。