微软 Mage 团队近期发布了 Mage-VL-Cowork,这是一款参数量为 4B 的混合计算机使用智能体(Computer Use Agent, CUA)。该模型旨在解决当前 CUA 领域的两个核心工程痛点:一是纯像素级 CUA 单张截图需消耗数千 token,且通过多次鼠标点击推导结构化文件编辑的效率极低;二是直接赋予前沿模型 GUI 和终端工具,若缺乏优化的执行脚手架,模型往往会产生次优的通道选择习惯,且现有后训练管道高度依赖已专门化的检查点。
- 项目主页:https://microsoft.github.io/Mage/cowork
- GitHub:https://github.com/microsoft/Mage/tree/main/mage_vl_cowork
- 模型:https://huggingface.co/microsoft/Mage-VL-Cowork
Mage-VL-Cowork 从中间 4B Mage-VL 检查点开始端到端训练,通过渐进式五阶段“先专门化后统一”的课程,将基于截图的 GUI 交互(computer_use)与持久的代码/终端执行(bash)整合至单一视觉-语言策略中,无需依赖外部多智能体编排器。
模型架构与核心规格
Mage-VL-Cowork 采用 llava_onevision2 架构,支持图像与文本输入并输出结构化文本。其设计重点在于平衡上下文预算与视觉状态意识,具体规格如下:
- 参数规模:4B(bfloat16 精度下占用 9.48 GB,分为 2 个 safetensors 分片)。
- 骨干网络:Mage-ViT(16×16 patch 网格,
spatial_merge_size=2,3D RoPE) + Qwen3-4B(Qwen3-4B-Instruct-2507)。 - 上下文长度:活跃训练和推理窗口为 32,768 token(架构层面支持高达 262,144 token)。
- 动作通道:支持
computer_use(11 个 GUI 原语,[0, 999] 归一化坐标)与bash(持久 shell 和 Python 环境)。 - 输出格式:三部分结构化回合,包含
<think>...</think>推理过程、Action:摘要以及<tool_call>...</tool_call>工具调用。 - 许可协议:Apache-2.0。
训练配方与工程优化
为实现高效的混合执行能力,Mage-VL-Cowork 在数据合成、框架设计与训练策略上进行了系统性优化。
1. 进化的混合 CUA 测试框架
在大规模轨迹收集前,系统通过编写智能体进化外部测试框架 $\mathcal{H} = (\mathcal{F}, \mathcal{T}, \mathcal{P}, \mathcal{E})$。该框架精炼了执行脚手架,移除了 xdotool 和冗长的可访问性树转储等重叠工具,并预安装了 python-pptx、openpyxl、pandas、pypdf 和 pillow 等领域 Python 库。这一优化将教师模型的表现提升至 92.0%,步骤减少 29.2%,进而为 4B 学生模型带来 +12.5 个百分点的蒸馏增益。
2. 工作流优先环境合成 (Mage-CUA-Forge)
传统的开放式智能体循环生成任务成本高昂。Mage-CUA-Forge 采用工作流优先策略,为每个原子技能一次性编写可重用的生成工作流和应用特定准备器。对于 Web 和跨应用任务,系统将桌面准备器与合成的 InfiniteWeb 站点及确定性、SQLite 支持的 WebHarbor 副本配对,确保每次 episode 前环境干净重置。该机制将单任务 token 消耗降低 93.3%(从 1,276K 降至 85K),支出从每任务 $0.906 降至 $0.158,整体重复生成成本削减 82.6%。
3. 五阶段“先专门化后统一”训练课程
模型训练分为五个明确阶段,逐步构建并统一各项能力,累计带来 +20.44 个百分点的性能提升:
- 阶段 1:GUI 导向中期训练(1.18 ZFLOPs)。聚焦视觉接地、思维链推理和模式合规工具调用,引入提示解耦与选择性
<think>正文掩码。OSWorld-G 准确率从 30.6% 提升至 56.9%。 - 阶段 2:GUI 智能体 SFT(1.55 ZFLOPs)。通过截图、鼠标和键盘执行多步桌面和 Web 工作流,涵盖 156.7K 轨迹。
- 阶段 3:编码和终端 SFT(0.27 ZFLOPs)。针对仓库软件工程及程序化桌面文件/状态操作,涵盖 563.7K 轨迹。
- 阶段 4:混合 CUA SFT(2.17 ZFLOPs)。训练模型在
computer_use和bash之间进行轮次级通道路由与验证,涵盖 318.8K 轨迹。 - 阶段 5:在线混合 RL(2.62 ZFLOPs)。采用带可验证任务奖励的异步 GRPO,结合前沿任务采样、有界策略滞后(≤3 更新)和截断重要性采样(TIS ≤ 2.0)。
4. 非对称工作记忆机制
为缓解长时程桌面任务中的上下文预算压力,模型在步骤 $t$ 采用非对称滑动窗口策略:
- 折叠的长时程记忆 ($1 \dots t-4$):早期回合被压缩为单行命令式
Action:摘要,紧跟在系统提示之后,节省 token。 - 活跃视觉窗口 ($t-3, t-2, t-1$):完整保留最近 3 张截图和 4 个完整助手响应,确保模型能直接检查前后 UI 转换,并从无操作点击中快速恢复。
性能表现与基准测试
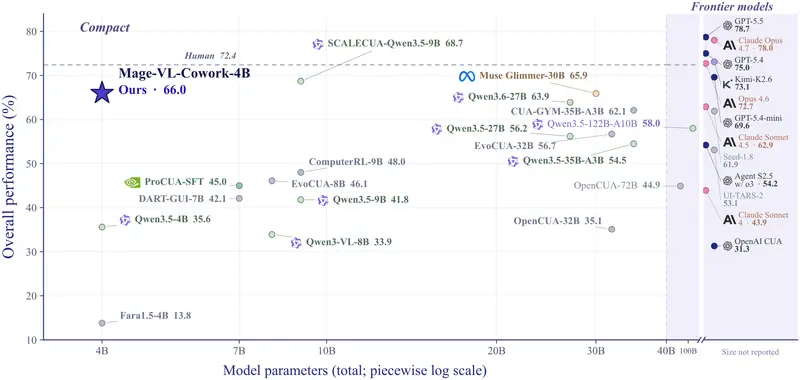
在 50 步预算下,Mage-VL-Cowork 在 OSWorld-Verified 基准测试中达到 66.0%(两次独立完整基准测试的平均值:65.33% 与 66.75%),在 4B 规模模型中取得最高性能。
- 任务细分表现:在纯 OS 任务上达到 87.5%,在多应用工作流上达到 62.7%,证明统一 GUI 与终端执行能有效将复杂跨应用任务转化为紧凑、可靠的轨迹。
- 在线 RL 的压缩效应:相较于混合 SFT,带可验证任务奖励的在线 GRPO 将任务准确性提升了 10.16 个百分点,同时将平均模型调用次数从 21.57 次压缩至 18.77 次(-13.0%),每任务输出 token 从 7,374 降至 5,499(-25.4%)。
实时并排加速对比(4B 混合 vs. 27B 纯 GUI)
在相同任务、相同桌面环境及挂钟计时器下,Mage-VL-Cowork 展现出显著的效率优势:
| 任务场景 | Mage-VL-Cowork (4B · 混合 GUI + CLI) | Qwen3.6-27B (27B · 仅 GUI) | 效率优势 |
|---|---|---|---|
| LibreOffice Calc:合并两个横幅范围、标记并添加柱状图,保存为 .xlsx | 0:39 完成(6 步) 通过终端 Python 程序化操作工作簿 | 9:56 完成(39 步) 通过 GUI 逐格点击和拖动 | 挂钟时间快 15.3 倍 执行步骤少 6.5 倍 |
| GIMP 图像编辑:添加 alpha 通道、清除纯青色背景、缩放图层至 280×210 并保存 .xcf | 1:58 完成(15 步) 在 GUI 中视觉编辑,随后通过终端验证文件尺寸与 alpha 状态 | 7:02 停止(29 步) 保存的文件未通过任务验证检查 | 挂钟时间快 3.6 倍 且成功通过验证 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。