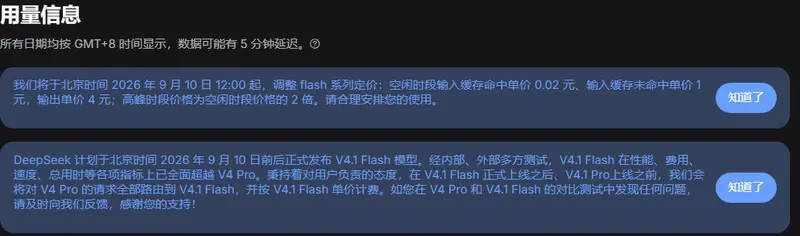
DeepSeek开放平台官宣,计划于北京时间2026年9月10日前后正式上线V4.1 Flash模型,同时9月10日12点起执行Flash系列全新峰谷定价。新版本采用全新模型架构、原生多模态能力,官方称在性能、速度、成本、总耗时全部维度已经超过V4 Pro;并且上线之后,V4 Pro的调用请求会自动路由至V4.1 Flash,并且按照Flash更低的单价计费。
V4.1 Flash:新架构、原生多模态,能力全面对标并超越V4 Pro
在此之前DeepSeek已经放出V4.1 Flash中间内测版本,内测模型名称:deepseek‑v4.1‑flash‑expires‑on‑0910,开发者base_url无需改动,切换模型名即可调用,内测阶段单账号限流20并发,计费沿用V4‑Flash标准。
核心特性:
- 全新模型结构,不再是旧版Flash的简单迭代;
- 原生一体化多模态:区别于此前外挂视觉模块的
deepseek‑v4‑flash‑vision‑exp,V4.1 Flash模型底座天生支持图文输入输出,图片理解、图表OCR、截图分析能力整合进模型本身; - 官方经过内外部多轮测试,性能、费用、推理速度、端到端总用时全部指标全面超越V4 Pro。
重要业务规则:
在V4.1 Flash正式发布之后,直到V4.1 Pro问世之前,所有指向V4 Pro的API请求,会自动路由到V4.1 Flash执行,并且按照V4.1 Flash的低价来计费,开发者无需手动修改代码即可享受升级与降价红利。
Flash系列9月10日12点正式调价,最高降幅60%
本次调价覆盖 deepseek‑v4‑flash、deepseek‑v4‑flash‑vision‑exp 两款模型,继续保留峰谷分时定价机制:高峰时段价格为空闲时段2倍。
| 计费项 | 空闲时段原价 | 空闲时段调整后 | 空闲降幅 | 高峰时段原价 | 高峰时段调整后 | 高峰降幅 |
|---|---|---|---|---|---|---|
| 输入(缓存命中,每百万Token) | 0.05元 | 0.02元 | 60% | 0.10元 | 0.04元 | 60% |
| 输入(缓存未命中,每百万Token) | 1.5元 | 1.00元 | 33.33% | 3.0元 | 2.00元 | 33.33% |
| 输出(每百万Token) | 4.5元 | 4.00元 | 11.11% | 9.0元 | 8.00元 | 11.11% |
价格变化解读
- 缓存命中输入降价幅度最大,直降60%:对于Agent、长会话、固定System Prompt这类KV缓存命中率高的业务,成本下降非常显著;
- 缓存未命中输入降幅约三分之一,输出端小幅下调11.11%;
- 高峰时段全部价格同步翻倍,适合开发者把大批量任务调度到空闲时段,进一步压缩API开销。
对开发者意味着什么
- 零成本享受更强模型:现存调用V4‑Pro的业务,不用改代码,流量自动切到更强的V4.1 Flash,同时账单会变低;
- 原生多模态替代外挂Vision扩展,图文场景推理效果、稳定性有望提升;
- 峰谷定价+缓存大幅降价,对高缓存的Agent应用、知识库问答、自动化工作流非常友好;
- 注意:内测版本并发限制仅20,不适合大规模压测,正式发布之后才会放开完整能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。