字节跳动近期发布了 Axion 1.0,这是一款完全开放的智能体基础模型。该模型的核心设计理念在于“将复杂性放在学习问题中”,即通过构建具有挑战性的科学问题和带有可验证答案的工具依赖任务来驱动模型学习,而非依赖日益臃肿和复杂的训练管道。
- 项目主页:https://axion1-0.github.io/
- GitHub:https://github.com/bytedance/axion1_0
- 模型:https://huggingface.co/Axion1-0/Axion-1.0-35B
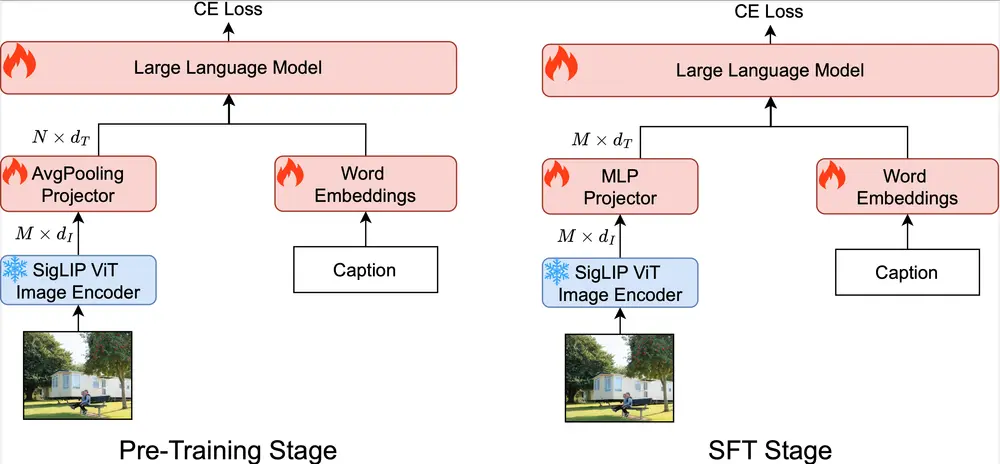
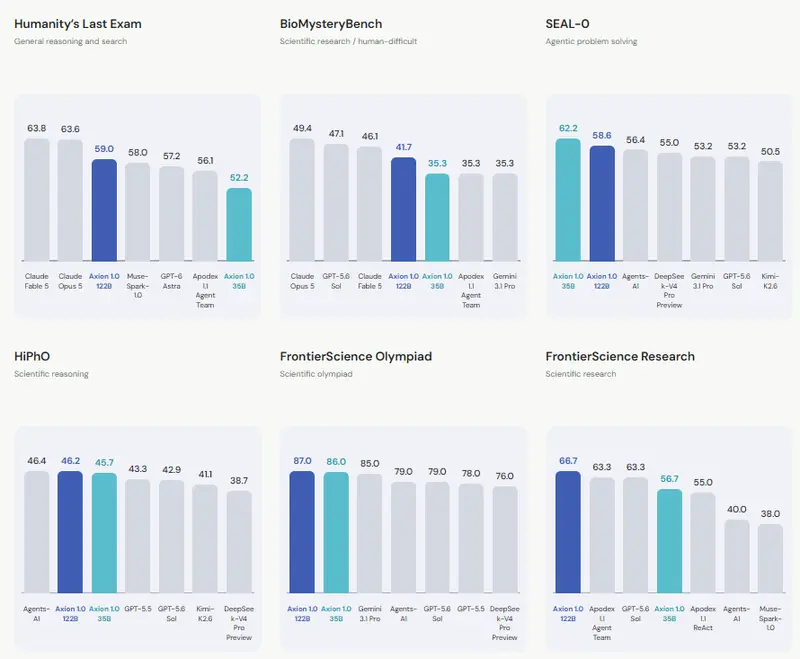
Axion 1.0 遵循清晰的三阶段能力构建进程:学习推理、学习获取缺失信息,随后通过交互精炼这些能力。其训练配方高度精简,仅包含两个轻量级的监督微调(SFT)阶段,随后衔接强化学习(RL),摒弃了专门的中期训练、DPO(直接偏好优化)或同策略蒸馏等复杂环节,最终在 HLE、SEAL-0 和 FrontierScience 等多项基准测试中取得了具备竞争力的结果。
核心亮点与技术特性
- 极简的三阶段训练架构:仅采用两个监督微调(SFT)阶段后接强化学习(RL),大幅降低了训练流水线的工程复杂度。
- 强化的科学推理与工具使用能力:模型在受限网站访问条件下展现出稳定的工具调用与逻辑推演能力。例如,Axion 1.0-122B 在完整 HLE 基准中得分 59.0,在 FrontierScience Olympiad 中得分 87.0,在 FrontierScience Research 中得分 66.7;Axion 1.0-35B 在 SEAL-0 基准中得分 62.2。
- 可验证的训练数据构建:推理问题采用基础模型反馈进行增强;需要工具的任务则从公共数据源构建,并配备程序化确定的参考答案,确保训练信号的准确性。
- 全面的开源生态:官方仓库完整开放了数据生成与过滤逻辑、提示词模板、两阶段 SFT 代码、异步 RL 实现,以及基准测试的准备与评分脚本。
模型规格与基准测试结果
Axion 1.0 提供了两种主要参数规模的模型,均基于成熟的开源基础模型进行演进。技术报告中同时报告了仅使用 SFT 训练的 4B 和 9B 变体作为参考。
| 模型 | 基础模型架构 | 总参数量 / 激活参数量 |
|---|---|---|
| Axion 1.0-35B | Qwen3.6-35B-A3B | 35B / 3B |
| Axion 1.0-122B | Qwen3.5-122B-A10B | 122B / 10B |
在多项权威基准测试中,Axion 1.0 展现了与主流闭源及开源智能体模型相当的性能表现(注:带 * 标记的基线分数由 Axion 团队自行评估,其他基线分数引自官方报告,”—” 表示未报告结果):
| 模型 | HLE | BMB (BioMysteryBench 困难子集) | SEAL-0 | HIPHO | FS OLYMPIAD | FS RESEARCH |
|---|---|---|---|---|---|---|
| Agents-A1 | 47.6 | — | 56.4 | 46.4 | 79.0 | 40.0 |
| Apodex 1.1 (Agent Team) | 56.1 | 35.3 | — | — | — | 63.3 |
| GPT-5.6 Sol | — | 47.1* | 53.2* | 42.9* | 79.0* | 63.3* |
| Gemini 3.1 Pro | 51.4 | 35.3* | 53.2* | 38.5* | 85.0* | 26.7* |
| Claude Fable 5 | 63.8 | 46.1 | — | — | — | — |
| Axion 1.0-35B | 52.2 | 35.3 | 62.2 | 45.7 | 86.0 | 56.7 |
| Axion 1.0-122B | 59.0 | 41.7 | 58.6 | 46.2 | 87.0 | 66.7 |
训练配方详解
Axion 1.0 的训练过程被严格划分为三个阶段,每个阶段针对特定的能力短板进行定向优化。
1. 阶段 I:自包含推理 (Self-Contained Reasoning)
此阶段使用 10,819 条科学和数学推理轨迹。公共种子问题被系统性地改写为难度更高的问题。基础模型已解决的问题,会通过组合、参数化、范围移动或案例分析等方式进一步增强,且每次改写后均会校验参考答案的正确性。在此阶段,求解器允许使用 Python 进行计算,但禁止使用外部搜索或网页检索,以强制模型建立内在的逻辑推导能力。
2. 阶段 II:工具依赖推理 (Tool-Dependent Reasoning)
此阶段使用 7,544 条轨迹(约 3.12 亿 token)。数据构建采用程序化过滤:记录并选择唯一实体,在 LLM 制定问题之前预先计算参考答案。求解器必须通过调用外部工具来寻找所需证据,且构建数据和答案在求解期间被严格扣留。任何无需检索即可解决的问题均被移除,以确保模型真正学习工具调用。
生成器覆盖了单个实体查询、排名列表以及跨数据库的复杂链路,数据源包括 NASA Exoplanet Archive、OurAirports、OpenAlex、UniProt 和 Ensembl 等。
3. 强化学习 (Reinforcement Learning)
RL 阶段从阶段 II 的检查点开始,采用异步 GRPO(Group Relative Policy Optimization)算法,在包含搜索、网页访问、学术检索和 Python 执行的智能体交互环境中进行训练。
- 奖励机制:得出正确的最终答案可获得全额奖励;经过验证的中间推理进展也可获得部分信用奖励,以鼓励探索过程。
- 上下文压缩:将长 rollout 轨迹划分为多个会话片段进行训练,以优化显存使用。
- 对齐技术:引入 Token-In-Token-Out (TITO) 机制以保留 token ID 的连贯性;使用 Rollout Routing Replay (R3) 技术,确保 rollout 阶段与训练阶段之间的 MoE(混合专家)专家选择保持一致。
训练基础设施与算力成本
技术报告详细披露了训练基础设施的配置与算力消耗,体现了该方案的高效能。SFT 运行统一使用 128K 上下文窗口,并结合 FSDP(完全分片数据并行)、专家并行和上下文并行技术。在 RL 阶段,rollout 工作器、训练器和辅助服务被分配至不同的 GPU 池以提升资源利用率。
根据论文第 5.1 节报告,两阶段 SFT 的算力成本如下:
| 模型 | GPU 数量 | 阶段 I 耗时 | 阶段 II 耗时 | 总 GPU 小时数 |
|---|---|---|---|---|
| Axion 1.0-35B | 32 | 1 小时 02 分 | 1 小时 46 分 | ≈ 90 小时 |
| Axion 1.0-122B | 32 | 3 小时 32 分 | 3 小时 58 分 | 240 小时 |
注:发布的 122B SFT 配方使用 32 块 GPU、128K 上下文窗口和全局批次大小 8。其保存的训练参数记录微批次大小为 1(第 5.1 节列表中提及为 2),发布的 SFT 配方保留了保存的训练参数以确保复现一致性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。