阿里ATH-MaaS推出 Ovis-Embedding 系列嵌入模型,核心目标是把文字、图片、视频、音频全部映射到同一个共享语义向量空间,实现任意模态检索:用任意一类内容作为查询,检索其他类型素材。官方同步开源三款模型:Ovis-Omni-Embedding-3B、Ovis-VL-Embedding-2B、Ovis-VL-Embedding-9B。
- GitHub:https://github.com/ATH-MaaS/Ovis-VL-Embedding
- 模型:https://huggingface.co/collections/ATH-MaaS/ovis-embedding
嵌入模型的本质,是把不同内容转成表征语义的数字向量。语义相近的内容,向量在空间距离更近;含义相差大则距离更远,是检索、推荐、RAG系统的底层核心组件。过去绝大多数嵌入模型只能支持单一或两种模态,不同模态向量空间互相隔离,无法直接跨类型比对检索,Ovis-Embedding就是为解决这个痛点而生。
核心能力
- 多模态统一理解
全模态版本原生支持文本、图像、视频、音频,可解析混合模态内容,例如一段带画面、人声、背景音乐的视频,模型可以融合全部信息做统一表征。视觉语言版本(VL系列)聚焦文字、图片、视频。 - 任意到任意跨模态检索
支持跨类型双向检索:文搜图、图搜文、音频搜视频、视频检索图文文档,不再局限同类型素材匹配。 - 多任务适配
不只做相似内容检索,还覆盖图片分类、图问答、视频理解、音频识别、文档检索、界面检索、工具检索、知识检索等任务,适配Agent工具查找场景。 - 可变长度向量输出
同一个模型可以生成不同维度的向量。长向量保留更多语义细节,精度更高;短向量节省存储空间、降低检索算力开销,业务可按需取舍精度与成本。
核心特点
- 共享骨干网络,统一语义空间
不是文本、视觉、音频独立模型拼接,整套使用同一个多模态主干网络处理所有模态,让狗叫音频、狗狗照片、描述狗奔跑的文字、狗狗视频能够在向量空间互相靠近。 - 原生全模态底座训练
全模态版本基于原生支持图文音视频的基础模型训练,不是文本大模型后期外挂音频模块,减少模态之间的语义割裂,视觉、文字、音频的语义关联更加自然。训练数据集规模预估约五千万组查询-目标样本,覆盖文本、图像、视频、音频、文档、智能体任务。 - 困难样本优先训练 + 模型蒸馏
训练会侧重容易混淆的困难样本,简单样本减少训练权重;同时引入更强教师模型做蒸馏,不只区分对错,还学习候选素材之间细微的相似度排序,提升检索排序质量。
训练采用同来源批次策略,避免模型依靠格式、长度这类表面特征“走捷径”,真正学习语义本身。 - 向量压缩方案,兼顾性能与部署
配套向量压缩适配方案,在缩短向量维度的同时,尽可能保留检索排序效果,降低线上存储与算力压力。
工作原理
- 原始内容输入,分模块预处理:文本分词编码、视频抽取帧并保留时序信息、音频转为声学特征;
- 全部模态送入共享多模态主干,混合模态素材可以一起输入;全模态版本移除语音生成模块,只保留理解能力;
- 模型输出统一语义向量,无论输入是文字/图片/音视频,向量处于同一个语义空间,直接计算相似度;
- 对比学习训练,区分正负样本,重点修正困难案例,借助教师模型优化细粒度相似度;
- 向量压缩,输出不同长度的表征,供业务按需选用。
评测表现与局限
测试结果
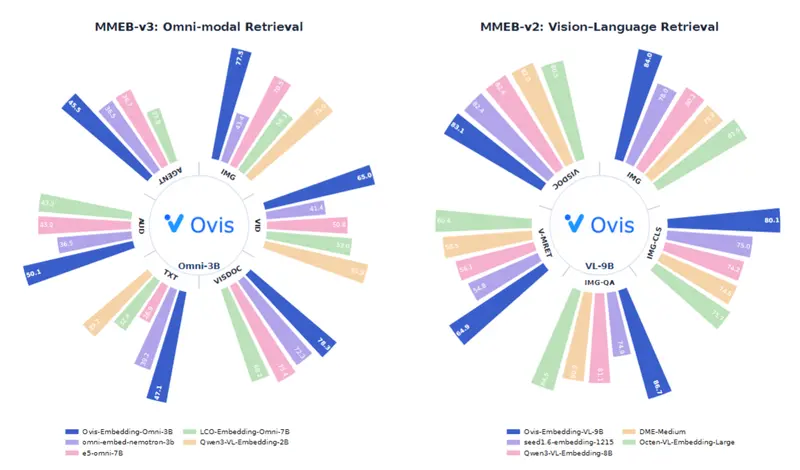
Ovis-Omni-Embedding-3B全模态版本,在跨模态综合评测总分58.46%,在六大类任务综合排名第一;
VL-9B视觉语言版本,在5大任务组里4组取得最优成绩。
音频、视频检索分类是它的突出优势,音频不再是附加模块,从训练阶段就和图文共享语义空间。
向量压缩方案中,降维+适配组合效果最优,短向量依然维持不错检索能力。
限制
- 数据集规模为当前冻结版本估算值,最终正式版本存在变动可能;
- 评测结果基于论文的实验配置,落地到自有业务数据需要重新实测;
- 模型推理对算力有一定要求,普通终端设备运行效果需要评估。
应用场景
- 多媒体内容检索:文字描述搜音视频,音频片段检索图文素材,不依赖关键词标签;
- 相册/媒体资产管理:本地或云端相册,用文字、照片、声音检索海量图片、录像;
- 企业知识库检索:统一检索文档、扫描件、示意图、培训视频,接入RAG做知识问答;
- 影视、播客、短视频平台:以片段声音、画面查找相关影音素材;
- AI智能体:检索软件截图、操作教程、工具说明,帮助Agent找到对应的功能界面与工具。
对普通用户价值
搜索脱离关键词限制,可以用文字、拍照、录音、上传视频任意方式提问,跨各类多媒体资料检索。但目前属于研究阶段模型,真实复杂场景落地仍需要工程优化。
© 版权声明
文章版权归作者所有,未经允许请勿转载。