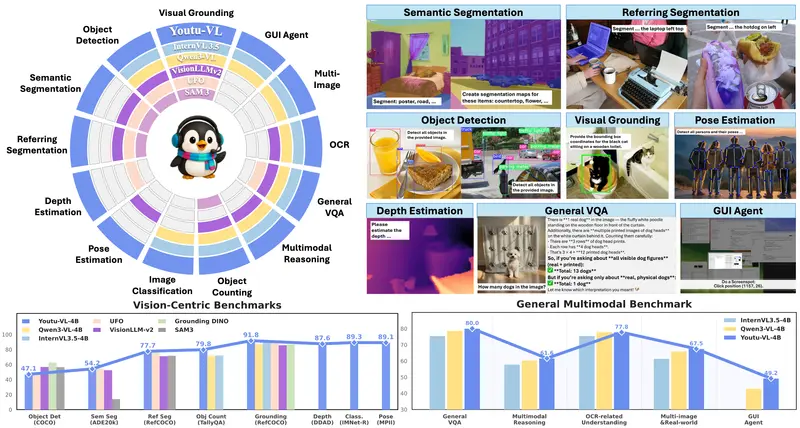
腾讯发布了 Youtu-Parsing-Omni,这是一款参数规模为 5B 的全模态解析模型。该模型的核心能力在于,能够通过单一的输入接口处理文档页面、自然图像、图表、几何图形、音频片段以及音视频流,并输出涵盖感知与认知双重维度的结构化 JSON 格式数据。
- GitHub:https://github.com/TencentCloudADP/youtu-parsing/tree/main/youtu_parsing_omni
- 模型:https://huggingface.co/tencent/Youtu-Parsing-Omni
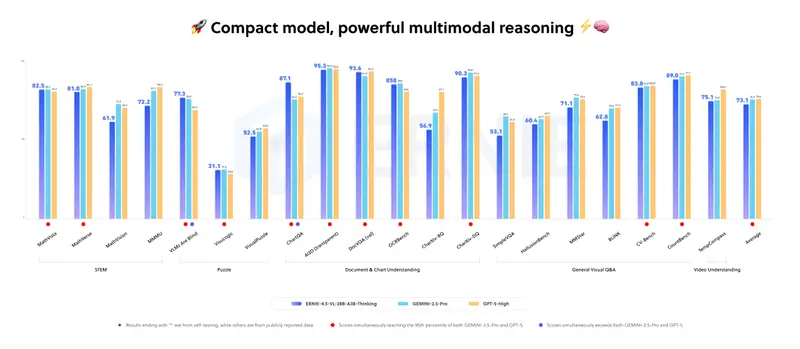
在基准测试中,该模型在 OmniDocBench v1.6 中取得了最优表现(综合得分 96.96),并在 OmniParsingBench 的开放权重模型中位居前列(平均得分 75.08,仅次于 Gemini-3-Pro)。此外,在化学结构(ChemOCR)和乐谱(PDMX-Synth)等垂直领域的识别任务中,其表现可与专用模型相媲美。
核心能力与任务矩阵
Youtu-Parsing-Omni 采用统一的任务提示机制(通过 --task 参数或 prompts/youtu_parsing_omni.json 中的键值选择),针对不同类型的输入模态,输出特定的结构化 JSON 信封。具体支持的任务类型及关键解析内容如下:
| 输入模态 | 任务标识 (--TASK) | 模态/子类型 | 关键解析内容 |
|---|---|---|---|
| 文档页面 | document | image / document | 带边界框 (bbox) 的布局元素、文本、LaTeX/OTSL 表格、Markdown 图表、Mermaid 流程图及阅读顺序。 |
| 自然图像 | natural_image | image / natural_image | 带边界框的实体与文本、标签、图像字幕及全局场景描述。 |
| 图表 | graphics_chart | image / document | 图表专属元素:Markdown 表格、数据注释、图表字幕。 |
| 流程图 | graphics_flowchart | image / document | 流程图专属元素:Mermaid 代码表示、流程字幕。 |
| 几何图形 | graphics_geometric | image / document | 几何专属元素:点、线、弧、形状、几何关系及测量数据。 |
| 音频 | audio | audio / – | 带时间戳的声乐/非声乐片段、说话人识别、ASR 转录、音色/场景字幕及声学事件。 |
| 自然视频 | natural_video | video / natural_video | 包含视觉元素、动作、交互、相机运动及音轨的时间片段序列。 |
| 文本丰富视频 | textrich_video | video / text_rich_video | 结合 OCR 与 ASR 的片段级解析,以及整个视频的 Markdown 结构化报告。 |
技术架构与方法论
该模型在架构设计上摒弃了传统多模态模型的冗余设计,主要通过以下三个核心技术模块实现高效解析:
1. 单编码器统一处理架构
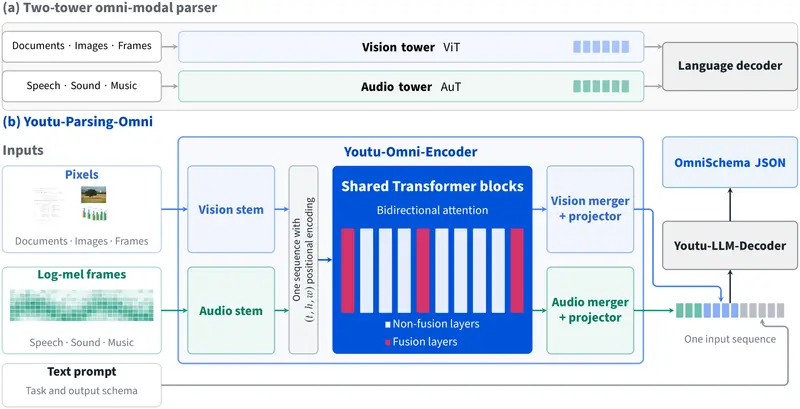
现有的全模态解析器通常采用双塔架构,分别使用独立预训练的视觉和音频编码器,其特征流仅在语言模型内部才进行融合。Youtu-Parsing-Omni 对此进行了简化,采用单一的 Youtu-Omni-Encoder 替换双塔结构。
- 初始化优势:该编码器从预训练的文本语言模型初始化,以强化文本阅读与理解能力。
- 参数共享机制:通过轻薄的模态特定茎(stem),将像素和对数梅尔频谱帧映射为 token。随后,共享的双向 Transformer 在统一的
(t, h, w)位置编码下,对任意打包的图像、音频块和视频混合数据进行上下文编码。 - 解耦设计:模态特定的合并器(merger)和投影器(projector)负责将编码后的 token 与文本提示结合,并馈送至
Youtu-LLM解码器以生成 OmniSchema JSON。由于仅有茎和合并器/投影器头依赖特定模态,模型绝大部分的感知参数实现了跨模态共享,显著降低了参数量。
2. 编码器内部的音视频时空融合
在处理视频输入时,模型的帧和音频块按时间顺序进行打包,并在编码器内部完成跨模态对齐,而非依赖解码器进行事后重建。
- 注意力窗口机制:在非融合层,每帧和每个音频块拥有独立的注意力窗口;而在少数融合层,系统会在每个“音频到帧”的边界开启新窗口,确保同一时刻的视觉帧能够直接关注对应的音频信号。
- 统一时间坐标系:视觉 token 从帧索引获取时间
t,从 patch 网格获取空间(h, w);音频 token 同样从其时间偏移获取t,但空间维度固定为h = 0, w = 0。这种设计使得两种模态在编码器内部共享同一个时间坐标系,实现了原生的时空特征对齐。
3. OmniSchema 感知的同策略蒸馏 (OSAD)
由于所有解析任务共享统一的 OmniSchema 输出格式,模型在后训练阶段采用了一种名为 OSAD(OmniSchema-aware On-policy Distillation)的自演化程序。
- 自采样与评分:学生模型自行采样生成解析结果。这些结果需通过一系列准入门槛(包括 JSON 有效性、模式一致性、边界框语法正确性及重复检查),随后由一个冻结权重的教师模型副本(该副本已见过参考解析)进行评分。
- 基于 Token 角色的损失计算:由于输出严格遵循 OmniSchema,系统能够识别每个 token 的角色。对于内容 token,采用 Jensen-Shannon (JS) 散度计算损失;对于结构 token,则在较高温度下使用前向 Kullback-Leibler (KL) 散度,并辅以全 token 的 JS 项。
- 自演化循环:在每个训练轮次边界,学生模型的 LoRA 适配器会被合并,学生模型随即转变为下一轮的教师模型。这种机制使得解析器及其监督信号能够共同演化,完全摒弃了手工设计的奖励函数或独立训练的教师模型。
部署与服务支持
为降低工程落地门槛,Youtu-Parsing-Omni 提供了完善的推理与服务支持:
- vLLM 插件集成:官方提供了适配 vLLM 的插件,支持高吞吐量的并发推理。
- 固定服务配置:仓库内包含预设的服务启动配置,减少了环境调试成本。
- 标准化提示词与示例:提供了完整的任务提示词模板(
prompts/youtu_parsing_omni.json)以及覆盖各模态的推理代码示例,开发者可直接复用或基于此进行二次开发。
© 版权声明
文章版权归作者所有,未经允许请勿转载。