由香港中文大学 MMLab、清华大学、香港科技大学(广州)及京东探索研究院联合研发的 CUA-Master-27B 计算机使用智能体(Computer Use Agent, CUA)正式发布。
- 项目主页:https://xlyu0106.github.io/CUA-Master
- GitHub:https://github.com/xlyu0106/CUA-Master
- 模型:https://huggingface.co/yxl66666/CUAMaster-27B
该模型基于 Qwen-3.5-27B 构建,通过引入嵌套双环递归改进框架,在仅 270 亿参数的规模下,实现了在纯图形用户界面(GUI)及 GUI 与命令行(CLI)混合基准测试中的竞争力,其性能表现已接近或匹配参数量大一个数量级的闭源模型。
核心方法:嵌套双环递归改进框架
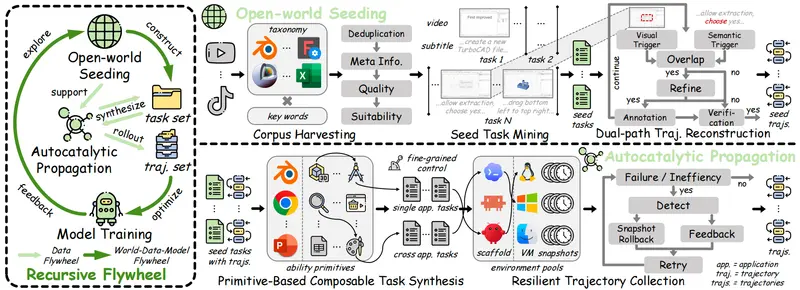
当前计算机使用智能体的发展主要受限于交互数据的多样性不足、可控性弱以及可靠性低。传统的训练管道缺乏有效的迭代反馈,而现有的递归方法过度依赖模型自生成的经验,容易导致能力扩展受限和收益递减。为此,CUA-Master 提出了一套嵌套双环递归改进框架,从系统和数据两个层面解决上述问题。
- 外层飞轮:世界-数据-模型闭环
该机制持续将开放世界语料库纳入训练循环。系统会根据模型在测试中暴露出的能力弱点,有针对性地指导后续的数据构建与优化迭代,形成持续进化的反馈闭环。 - 内层飞轮:数据层面的自催化与可控合成
内层循环包含三个关键步骤,以确保训练数据的质量与多样性:- 开放世界播种:从 YouTube、TikTok、Bilibili 等平台的真实教学视频中挖掘实际工作流,并利用视觉-语义双路径机制重建操作轨迹,为模型注入其自身能力之外的外部先验知识。
- 自催化传播:将挖掘出的种子任务抽象为可重用的能力原语。通过组合这些原语,系统能够合成出复杂度高且结果可验证的新任务,实现对单应用及跨应用工作流的精确控制。
- 快照回滚重试机制:在真实环境中收集轨迹时,若操作失败,系统会通过反馈引导将环境回滚至最近的有效快照,而非从头重启。这一机制保留了已验证的有效执行前缀,大幅提升了轨迹收集的成功率与计算效率。
训练策略与迭代增益
CUA-Master-27B 的训练过程结合了迭代监督微调(SFT)与强化学习(RL)。训练数据来源于开放世界任务的验证轨迹以及上述框架合成的组合任务。
实验表明,这种双环设计在递归迭代中表现出持续的增益。SFT 阶段逐步扩展了模型的基础操作能力,而随后的 RL 阶段则有效突破了模型的能力平台期。与单向或封闭世界的数据生成管道相比,该框架显著提升了合成任务在多样性、覆盖范围、可靠性和可控性方面的指标。
性能表现与跨平台泛化能力
在一致的基准测试协议下,CUA-Master-27B 展现出强劲的性能与卓越的执行效率:
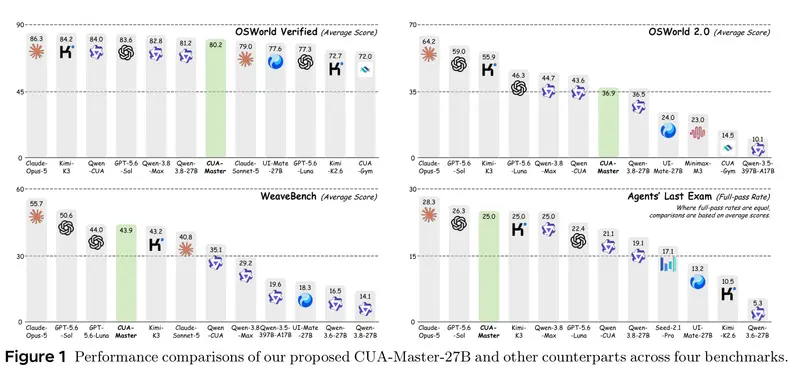
- 基准测试优势:在四个核心基准上,该模型分别比同量级的 UI-Mate-27B 提升了 2.6、12.9、25.6 和 11.8 个百分点。在混合设置下,其表现匹配甚至超过了 Qwen-CUA-397B-A17B。
- 执行效率提升:与可比模型相比,CUA-Master-27B 完成任务所需的步骤更少,整体运行时(挂钟时间)减少了 24% 至 36%。
- 跨平台泛化:无需针对特定操作系统进行微调,该模型在 WindowsAgentArena 上得分为 56.2,在 MacOSWorld 上得分为 43.0,在 MacAgentBench 上得分为 59.9,验证了其在 Linux、Windows 和 macOS 环境下的广泛泛化能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。