Perplexity 正式推出 pplx-embed-v2-late,一对ColBERT架构风格的多模态嵌入模型,分为0.6B轻量边缘版本与9B高质量版本,二者共享同一嵌入空间,支持文本、图片、渲染PDF页面的检索。模型已上传至Hugging Face,采用MIT许可证,允许商业使用;托管版API端点目前仅在规划阶段,尚未上线,开发者需要自行部署运行。
- 模型:https://huggingface.co/collections/perplexity-ai/pplx-embed-v2
这套模型底层基于Qwen3.5基座蒸馏而来,0.6B版本总参数594M,文本部分活跃参数约240M、图像约340M,bf16权重预估约1.2GB,适配笔记本、边缘设备、小型GPU,主打本地实时查询编码;9B版本总参数9B,活跃参数7.4B,bf16权重预估16–18GB,面向数据中心、大显存GPU,适合用来构建文档索引。
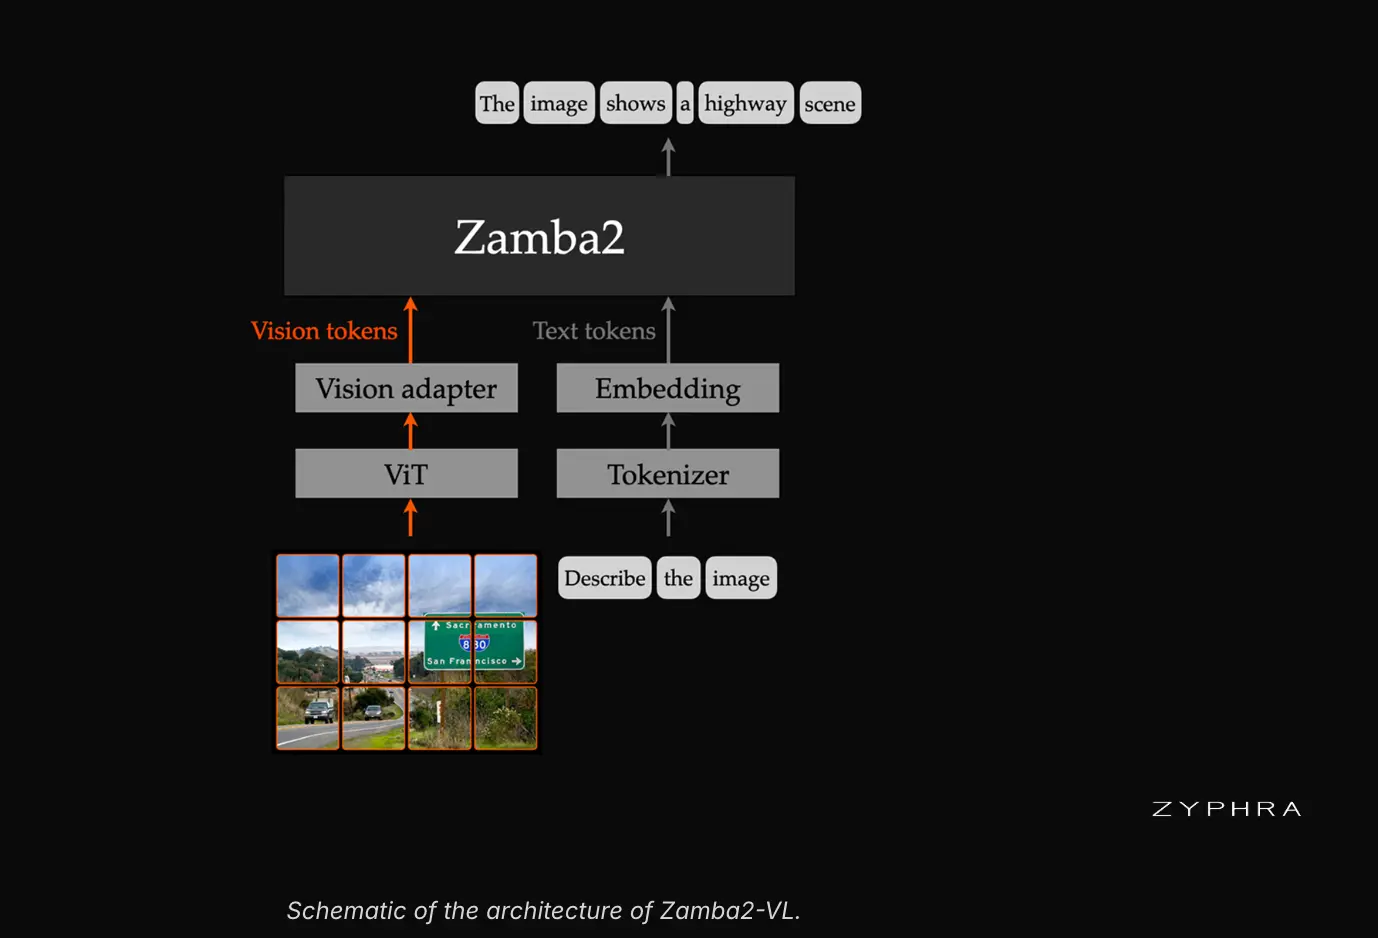
两个模型均输出每token 128维向量,相比竞品20484096维向量,维度缩小1632倍。模型采用MaxSim打分机制:查询的每个token匹配文档最优token,取最大值求和。PDF页面直接以图像编码,无需额外OCR;模型基于LEAF风格token级训练,从18B教师模型蒸馏得到,因此大小模型之间嵌入空间互通。
一个极具性价比的用法:用9B模型构建文档索引,用0.6B模型执行查询检索。查询成本维持轻量模型水平,但可以追回接近一半9B文本质量差距,在图像检索任务上也优于全程使用0.6B。
基准表现(全部为官方自测结果,技术报告暂未发布)
- MADQA代理式PDF问答基准:0.6B得分90.1%,9B达到92.4%;仅次于Mixedbread Agentic Search(93.4%),高于Mixedbread检索器88.9%
- 72项领域文本任务nDCG@10:0.6B为78.0%,9B达到81.3%
- Q2D-Web网页检索Recall@1000:两个版本都突破过往最优值69.3%,分别73.6%、74.8%
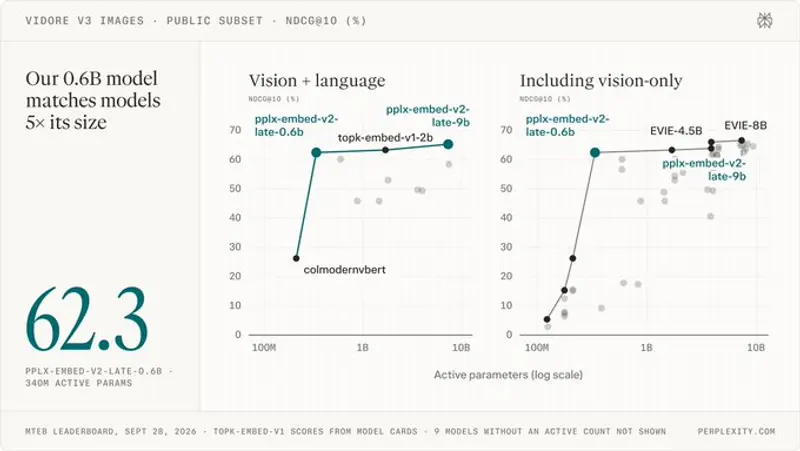
- ViDoRe v3图像检索nDCG@10:0.6B=62.3%,9B=65.2%;该赛道腾讯EVIE得分更高,未能登顶
- ViDoRe v3 Markdown:0.6B 61.2%,9B 64.7%,二者超过所有外部对比模型
- BrowseComp+:仅9B有数据,64.0%,相比其他ColBERT模型高出4.9个百分点
优缺点梳理
✅ 优势
- MIT开源许可,支持商用,可本地部署
- 大小模型共享嵌入空间,“重索引、轻查询”方案兼顾检索质量与推理成本
- 向量维度极低,128维/Token,向量存储开销大幅降低
- 支持渲染PDF图像检索,省去OCR流程,适合扫描文档、幻灯片检索
- 0.6B版本体量小,能够在边缘设备本地跑检索查询
⚠️ 局限
- 每一个token单独保存向量,文档越长,索引体积越大
- 图像检索ViDoRe v3不敌腾讯EVIE;在MIRACL-Vision、PPLX-Q2I弱于Gemini Embedding 2
- 单次输入不能同时混合文本+图像
- 基准成绩全部为厂商自报,完整技术报告尚未公开
- 托管API还没上线,需要开发者自备GPU完成部署
适用场景
优先用于PDF、扫描报告、幻灯片这类视觉文档检索;低延迟本地检索,云端用9B建索引、终端0.6B做查询;面向大规模PDF与网页集合的代理式RAG检索。
要点小结
- 产品定位:ColBERT风格多模态嵌入模型 pplx-embed-v2-late,0.6B边缘版 + 9B索引版,MIT开源
- 核心亮点:大小模型共享嵌入空间,可9B建索引,0.6B查询;每token仅128维向量
- 最佳成绩:MADQA基准92.4%;强项在PDF视觉文档检索
- 部署要求:自行托管,依赖sentence-transformers >=6.0.0、transformers >=5.4.0;托管API待上线
- 主要短板:索引体积随文档长度增长;基准为自报数据,图像检索赛道存在更强竞品,不支持图文混合输入
© 版权声明
文章版权归作者所有,未经允许请勿转载。