LLaVA-OneVision-2 (LLaVA-OV-2) 是 LLaVA 家族的新一代里程碑式作品。作为一个完全开放的 80 亿参数多模态大模型,它基于 Qwen3-8B 语言骨干,首创性地引入了编码流感知(Codec-Aware)机制,彻底改变了传统多模态模型处理视频的方式。
- 项目主页:https://evolvinglmms-lab.github.io/LLaVA-OneVision-2
- GitHub:https://github.com/EvolvingLMMs-Lab/LLaVA-OneVision-2
- 模型:https://huggingface.co/collections/lmms-lab/llava-onevision-2
不同于以往依赖均匀抽帧的模型,LLaVA-OV-2 能够直接“阅读”视频压缩码流,在单一架构下统一了图像、长视频和三维空间理解,并在多项基准测试中刷新了开源模型的最好成绩(SOTA)。
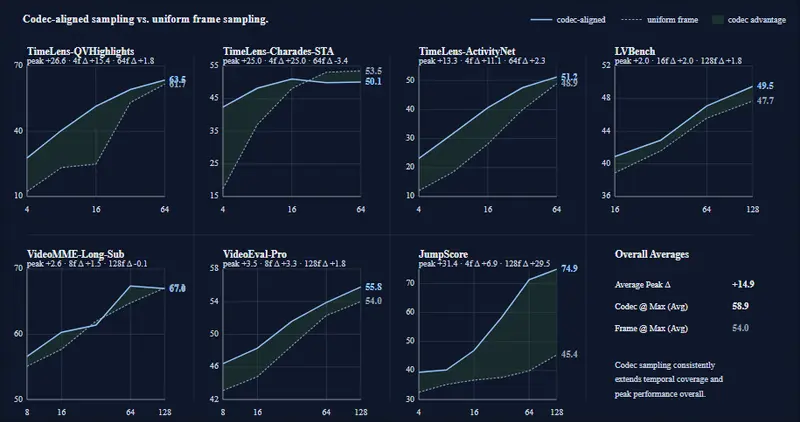
核心突破:告别暴力抽帧,拥抱编码流
传统视频 MLLM 通常将视频解码为帧序列,导致 Token 浪费且容易丢失运动细节。LLaVA-OV-2 提出了 Codec-Stream Tokenization 技术:
- 自适应时间分组:利用 H.264/HEVC 码流中的 P/B 帧包大小作为信号,码率高(变化大)时短分组,码率低(平稳)时长分组。
- 空间显著块选择:结合运动向量与亮度残差生成显著图,仅选择富含运动和残差的 2×2 Patch 块。
- 紧凑视觉画布:将有限 Token 预算集中在“事件发生处”,而非均匀分配给所有帧。
结果:在相同 Token 预算下,实现了更长的时间覆盖和更精准的事件捕捉,尤其擅长处理长视频和突变场景。
模型架构:统一且高效
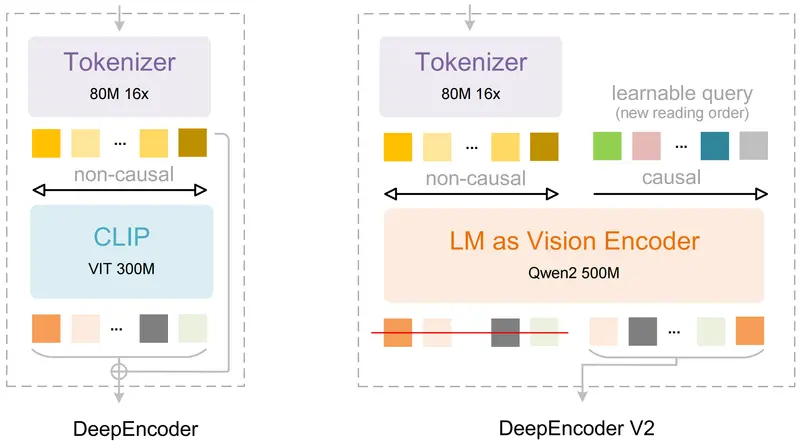
- 视觉编码器:OneVision-Encoder,采用 HEVC 风格的视觉 Transformer,支持原生分辨率输入。
- 语言骨干:Qwen3-8B,提供强大的逻辑推理与语言理解能力。
- 统一接口:图像、抽帧视频、编码流视频共享同一编码器,无需特定任务适配器。
- 3D RoPE:引入统一时空位置编码,将编码画布、抽帧和图像纳入同一坐标系,增强空间与时序感知。
性能表现:全维度碾压
LLaVA-OV-2 在视频、空间、跟踪及图像任务上均展现出卓越性能:
| 任务领域 | 关键指标/基准 | LLaVA-OV-2 表现 | 对比 Qwen3-VL-8B |
|---|---|---|---|
| 时序定位 | JumpScore (新基准) | 74.9 mAP | +44.8 点 🚀 |
| Charades/ActivityNet | 大幅领先 | +显著优势 | |
| 空间推理 | CrossPoint | 61.9 | +35.0 点 |
| TraceSpatial-3D | 31.0 | 第二名仅 8.0 | |
| 目标跟踪 | DAVIS/MeViS/ReVOS | J&F 48.0 | +15.6 点 |
| 综合视频 | 18 个基准平均 | 62.5 | +4.3 点 |
注:JumpScore 是一个全新的精细时序定位基准,要求模型以亚秒级精度列出跳绳视频中每一次起跳时间,极大考验模型对高频重复运动的分辨能力。
完全开放:从第一天起即可复现
与许多“半开放”模型不同,LLaVA-OneVision-2 承诺端到端开放:
- 四大数据集:
LLaVA-OneVision-2-VideoCaption:极密集视频字幕。LLaVA-OneVision-2-Spatial:3D 感知空间推理数据。LLaVA-OneVision-1.5-Mid-Training-85M:8500 万条中期训练语料。LLaVA-OneVision-1.5-Instruct:完整指令微调混合集。
- 全套资源:编码器权重、训练代码、配置文件、完整训练日志全部公开。
应用场景
- 精细时序定位:毫秒级事件检测(如体育动作分析、监控异常行为识别)。
- 长视频理解:高效处理 10-15 分钟视频,生成摘要或回答细节问题。
- 机器人操作:输出 3D 路径点,预测操作轨迹,结合 SAM 2 生成 Mask。
- 空间交互:精准的 2D/3D 坐标指向,适用于 AR/VR 及具身智能。
© 版权声明
文章版权归作者所有,未经允许请勿转载。