2025 年 11 月,AllenAI 发布了专注于地球观测的开源模型家族 OlmoEarth v1。自发布以来,该模型已被广泛应用于追踪红树林变化、分类森林损失驱动因素以及生成国家级作物类型地图等关键任务,部署范围从国家层面扩展至全球。
- GitHub:https://github.com/allenai/olmoearth_pretrain
- 模型:https://huggingface.co/collections/allenai/olmoearth
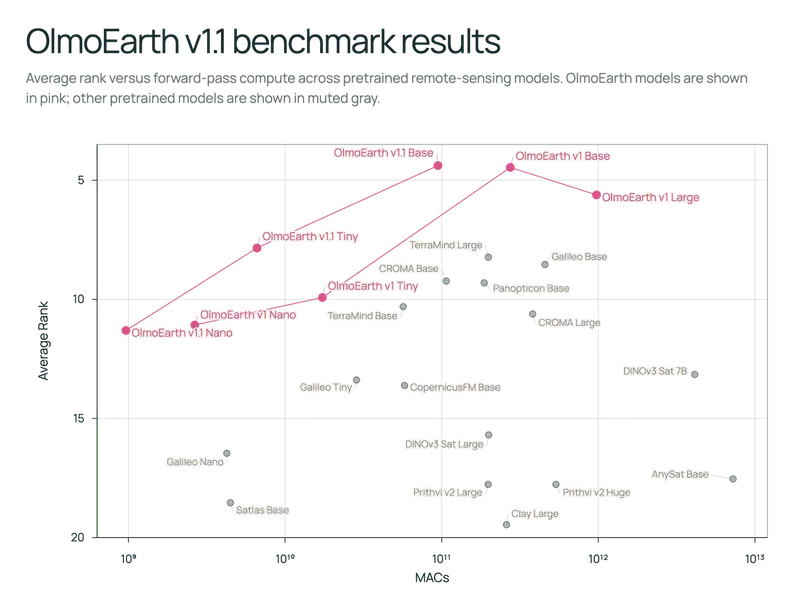
为了进一步降低算力门槛,让更多致力于保护地球的组织能够负担得起先进的 AI 技术,AllenAI 正式推出了 OlmoEarth v1.1。这一新版本在保持原有性能基准的同时,将计算成本降低了高达 **3 倍显著提升了运行效率。
核心突破:为何效率至关重要?
在处理覆盖数十万平方公里的卫星图像时,计算资源是最大的瓶颈。OlmoEarth 基于 Transformer 架构,其计算成本与输入 Token 序列长度呈二次方比例增长。这意味着,即使是微小的序列长度减少,也能带来巨大的成本节省。
OlmoEarth v1.1 的核心目标非常明确:用更少的资源做更多的事。通过优化底层数据处理逻辑,新模型使得频繁刷新全球地图、进行大规模微调推理变得更加经济可行。
技术揭秘:Token 合并的艺术
OlmoEarth v1.1 的效率提升主要源于对 Token 表示方式 的重构。
1. 传统做法:分辨率分离
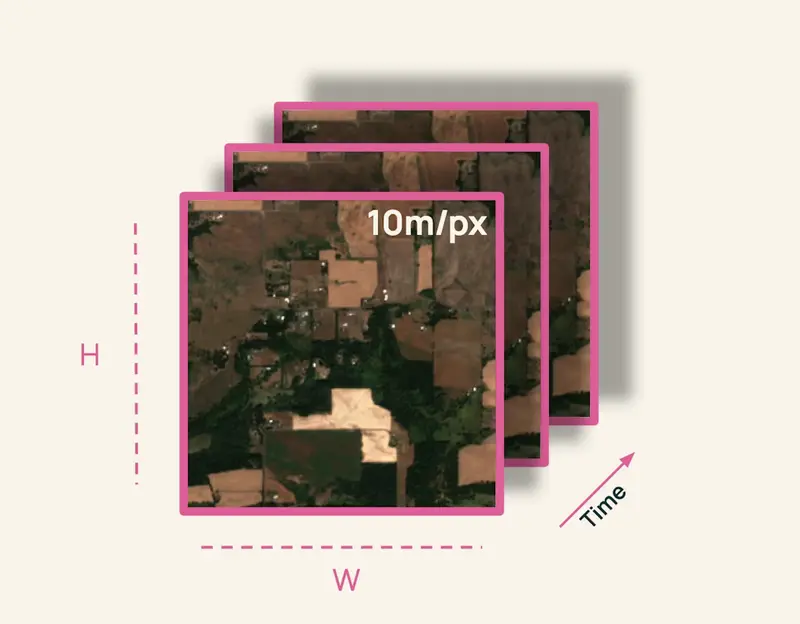
以常见的 Sentinel-2 卫星数据为例,传统方法(包括 OlmoEarth v1)通常将不同分辨率的波段分割成独立的 Token。
- 机制:对于一个空间 Patch,每个时间步、每个分辨率都生成一个独立的 Token。
- 后果:Token 数量乘法叠加。例如,一个包含 2个时间步的输入,每个 Patch 可能产生 6 个 Token。总 Token 数为 $H/p \times W/p \times T \times 3$(假设3种分辨率)。
2. 创新方案:跨分辨率合并
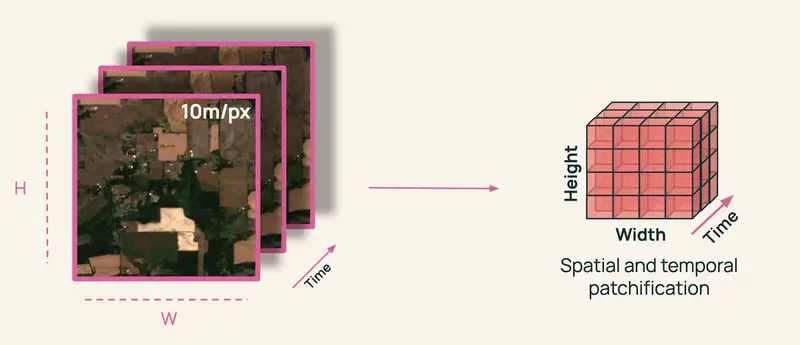
OlmoEarth v1.1 借鉴了如 CROMA 等模型的理念,尝试将不同分辨率的波段合并为单个 Token。
- 优势:Token 数量直接减少为原来的 1/3。由于 Transformer 的计算复杂度与序列长度平方相关,这带来了实质性的预训练、微调和推理加速。
- 挑战:简单合并会导致性能下降,因为模型难以捕捉跨波段的复杂关系。
3. 解决方案:改进的预训练方案
为了在合并 Token 的同时不牺牲精度,AllenAI 修改了预训练方案。通过引入特定的注意力机制和数据增强策略,模型能够在更短的序列中有效学习跨波段、跨分辨率的特征关联。最终,OlmoEarth v1.1 在多个研究基准和合作伙伴任务中,达到了与 v1.0 相当的性能水平。
价值主张:面向开发者与研究者的双赢
对于开发者与应用团队
- 成本大幅降低:在每种模型规模下,运行成本仅为 v1.0 的 1/3。
- 速度显著提升:微调和推理过程中的加速效果明显,使得实时或近实时的全球监测成为可能。
- 无缝迁移:API 和接口保持兼容,现有用户可轻松切换至 v1.1,立即享受性能红利。
对于研究人员
- 可控的实验变量:OlmoEarth v1.1 在与 v1.0 完全相同的数据集上进行训练。这意味着两者之间的任何差异都严格归因于方法学(Token 合并与预训练策略)的改变,而非数据偏差。
- 科学洞察:这为研究遥感模型预训练中的科学原理提供了一个理想的对照实验场,有助于社区更深入地理解架构、数据与算法之间的相互作用。
开始使用
OlmoEarth v1.1 现已开源,提供 Base、Tiny 和 Nano 三种规模的模型权重及训练代码。
- 适用场景:土地覆盖分类、变化检测、农作物监测、自然灾害评估等。
- 获取方式:开发者可通过 AllenAI 官方仓库下载权重,快速部署到自己的遥感分析流水线中。
© 版权声明
文章版权归作者所有,未经允许请勿转载。