在视频大模型(Video VLM)领域,高昂的算力成本和庞大的模型体积往往是落地应用的最大阻碍。近日,Nemostation 推出了 Marlin——一款仅拥有 20 亿(2B)参数的微型视频视觉语言模型。尽管体量小巧,Marlin 却在密集字幕生成和时间定位任务上展现了惊人的实力,旨在以极低的成本解决开发者最关心的两个核心问题:视频中发生了什么?以及这些事件发生在什么时间?
- 模型:https://huggingface.co/NemoStation/Marlin-2B
- Demo:https://vlm.nemostation.com
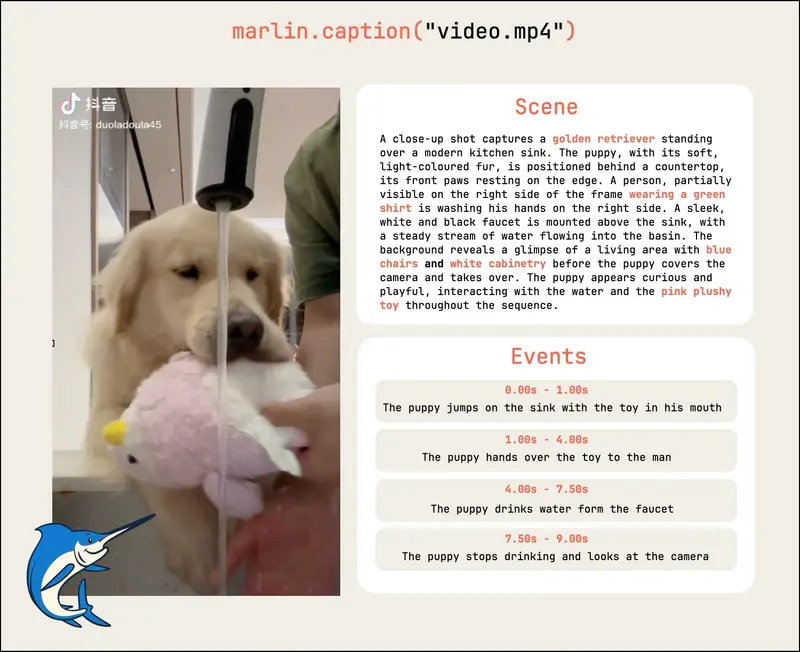
核心亮点:小身材,大智慧
Marlin 专为高效提取视频中的结构化信息而设计,其核心优势体现在以下几个方面:
1. 顶级的密集字幕生成能力
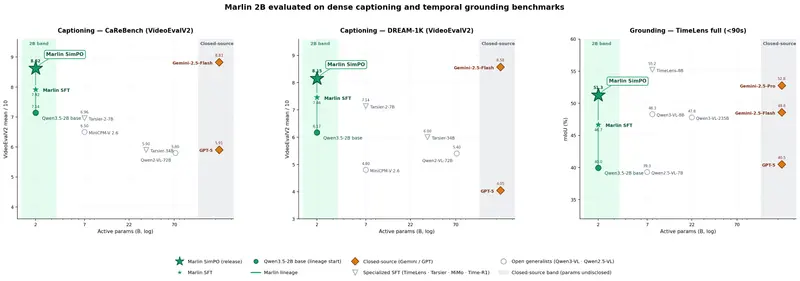
在 CaReBench 排行榜上,Marlin 名列前茅。在更具挑战性的 DREAM-1K 基准测试中,其表现介于 Tarsier-34B 和 Gemini-1.5-Pro 之间。这意味着,仅用 2B 参数,它就达到了远超同等规模模型、甚至逼近大型旗舰模型的理解深度。
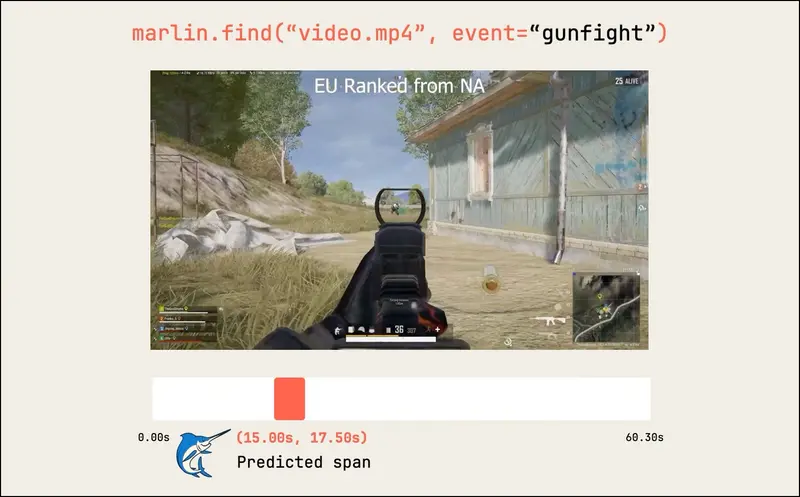
2. 精准的时间定位(Temporal Localization)
Marlin 不仅能识别事件,还能精确到秒地标记事件起止时间。在腾讯推出的 TimeLens-Bench 测试中:
- Marlin 的表现比 Qwen2.5-VL-7B 高出 +6.4 mIoU(平均交并比)。
- 其精度直接匹配了 Gemini-2.0-Flash 的水平。
这使得 Marlin 成为当前 2B 参数量级中,时间定位能力最强的开源模型之一。
3. 极致友好的部署体验
- 硬件门槛低:兼容 vLLM 和 swift-deploy,可在单张消费级 GPU 上流畅运行。
- API 标准:提供标准的 Hugging Face transformers API,支持自定义提示词的原始
.generate()访问。 - 开箱即用:内置两个便捷方法,可直接返回解析好的 Python 字典格式数据,并附带 Gradio 演示界面,极大降低了集成难度。
技术揭秘:如何训练出强大的“小模型”?
Marlin 的强大并非偶然,而是源于精心设计的架构优化和高质量的数据策略。
1. 架构基础
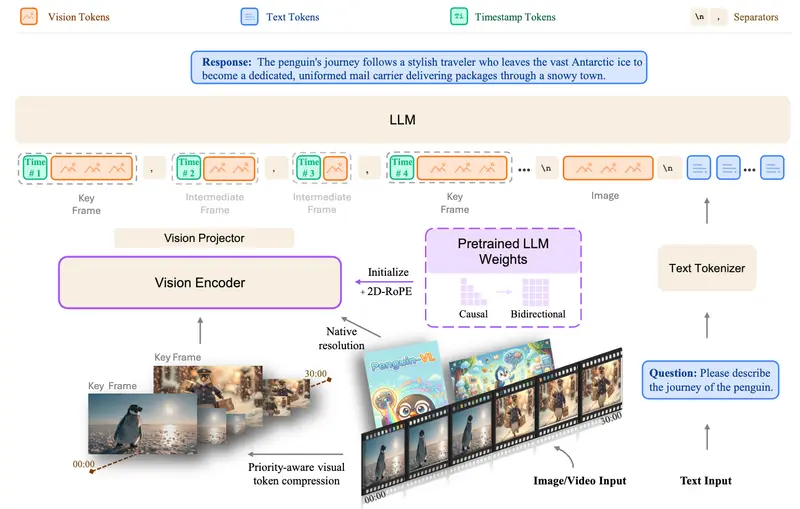
Marlin 基于 Qwen3.5-2B 进行微调,保留了具备视频处理能力的视觉塔。通过自定义建模代码,模型暴露了两种专用模式,分别对应“密集字幕生成”和“时间定位”,并将输出自动解析为结构化的类型化字典。
2. 高质量数据构建
为了弥补小模型数据容量的限制,团队构建了极高品质的训练语料库:
- 教师模型蒸馏:利用 Gemini-3-Flash 的思考模式对稀疏的公共标注进行密集重新标注,生成带有明确起止边界的事件描述。
- 人工审查对影响最大的部分进行针对性的人工审查,确保数据准确性。
- 数据规模:最终混合了约 40 万条高质量的片段级标注数据,以及专门的时间定位调优数据集。
3. 两阶段后训练策略
在单个 H100 GPU 上完成的训练流程分为两步:
- 第一阶段:监督微调(SFT)
使用固定的规范提示和 Tarsier 模式输出格式,在精选数据集上进行基础能力训练。 - 第二阶段:偏好优化(SimPO)
采用 SimPO(Simple Preference Optimization)算法,在教师模型蒸馏出的偏好集上进行对齐。- 优势:相比传统的 DPO(直接偏好优化),SimPO 无需参考模型,计算成本更低且更稳定。团队通过丰富的评估标准对 SFT 检查点的候选结果进行评分,构建胜/负对,从而显著提升模型在特定任务上的表现。
性能评估:缩小与旗舰模型的差距
评估结果显示,Marlin 在其参数量级下,在生产环境视频分析所需的关键维度上达到了最强水平:
- 字幕生成:Marlin 将其与其教师模型 Gemini-2.5-Flash 的差距缩小至 0.21/0.43(满分 10 分),表现极为接近。
- 时间定位:Marlin 位于 2B 参数模型的帕累托前沿,并在通用性上匹配了 Gemini-2.5-Flash。
© 版权声明
文章版权归作者所有,未经允许请勿转载。