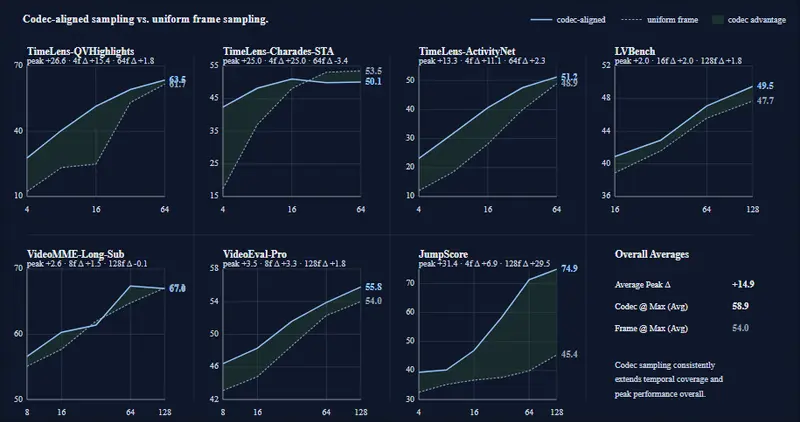
LLaVA-OneVision-2:首个“读懂”视频编码的 8B 多模态模型,抛弃均匀抽帧,长视频与时序定位能力代际领先LLaVA-OneVision-2 (LLaVA-OV-2) 是 LLaVA 家族的新一代里程碑式作品。作为一个完全开放的 80 亿参数多模态大模型,它基于 Qwen3-8B 语言骨干,首创性地引入了...多模态模型# LLaVA-OneVision-25个月前2160