百度正式开源了 Unlimited OCR 2,这是一款专为超长文档解析构建的 33.4 亿(3.34B)参数视觉语言模型。该模型能够在单次请求中高效解析数百页的书籍、申报文件和报告,其核心突破在于引入了 SR-SWA(稀疏参考滑动窗口注意力)机制,使得长文档解码的每步成本几乎保持恒定。模型权重以 MIT 协议开源,代码已在 GitHub 发布。
- GitHub:https://github.com/baidu/Unlimited-OCR
- 模型:https://huggingface.co/baidu/Unlimited-OCR-2
核心架构与 SR-SWA 机制解析
Unlimited OCR 2 延续了 DeepSeek-OCR 风格的架构布局,采用 SAM ViT-B 结合 CLIP-L 作为视觉编码器,将特征馈入一个 12 层的混合专家(MoE)解码器。每个 token 会路由到 64 个专家中的 6 个,外加 2 个共享专家。在多页模式下,每页约消耗 273 个图像 token。
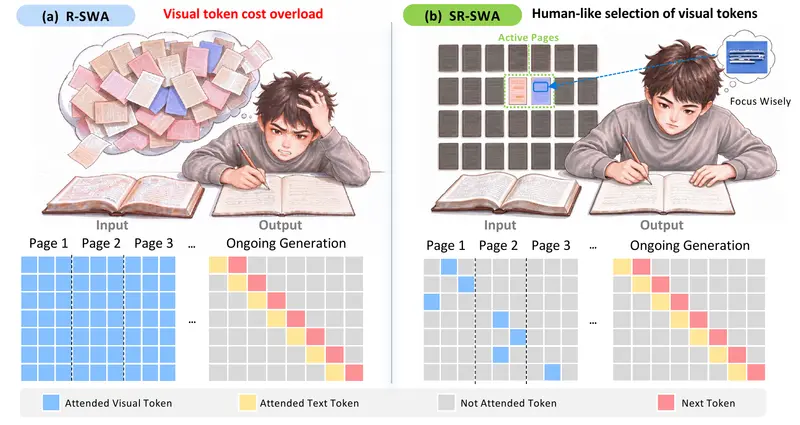
传统全注意力机制的成本随序列长度呈二次方增长,在处理百页文档(超 27,000 个输入 token)时会导致显存溢出或延迟剧增。为此,Unlimited OCR 2 引入了 SR-SWA (Sparse Reference Sliding Window Attention):
- 固定参考集压缩:将文本-视觉注意力压缩为一组固定的工作参考。例如,在 512 个 token 的预算下,模型结合 128 个 token 的局部窗口,并对 32 个 token 的块进行 top-16 选择(即 16 个块 × 32 token = 512 token)。
- 恒定成本解码:这种机制使得每步的延迟和内存消耗随着文档长度的增长几乎保持恒定,从而在有限的上下文窗口内实现了“无限视野”的解析能力。
卓越的性能表现与基准测试
百度在 MPDocBench(每文档数十页)和 MarathonDocBench(数百页)两个多页基准上对该模型进行了评估。尽管所有数据均为百度自报,但其展现出的长文档处理能力具有显著的代际优势:
- 长文档统治力:在 MarathonDocBench 上,Unlimited OCR 2 取得了 77.1 的总体得分,远超排名第二的 Kimi-K3(33.7)和 Gemini-3.8-Flash(28.6)。相比之下,其前代 Unlimited-OCR 在该基准上的得分为 0.0,体现了巨大的架构飞跃。
- 短文档稳健性:在 MPDocBench 上,该模型得分 84.6,略优于 Qwen3.8-Max(78.3)和 Qwen-3.8-Flash-Next(77.4)。
- 子项表现与局限:模型在文本识别(89.6)、公式(87.9)和阅读顺序(85.3)上表现优异。然而,标题层级(TEDS) 是其相对薄弱的环节,在长文档上得分仅为 48.2,表明在处理复杂嵌套的文档结构时仍有优化空间。
部署与运行指南
Unlimited OCR 2 的 BF16 权重总计约 6.7 GB,可在单块 CUDA GPU(如英伟达 A800-80GB)上流畅运行。官方提供了两种主要的推理途径:
- Hugging Face Transformers(快速测试):
infer:处理单页,使用动态平铺(gundam 模式)。infer_multi:在单次请求中解析文档的每一页,保留跨页上下文。加载时需设置trust_remote_code=True以运行仓库中的自定义 Python 代码。
- SGLang(生产级服务):
- 需使用百度提供的定制 wheel,而非上游 SGLang。
- 支持窗口化调度(如示例中每窗口调度 10 页),并复用前一窗口的 KV 尾部以降低峰值内存。
- 注意事项:百度警告,默认的偏置设置可能触发 462 MiB 的内存分配,需根据实际硬件调整配置以避免 OOM(内存溢出)。
© 版权声明
文章版权归作者所有,未经允许请勿转载。