Liquid AI 今日正式发布了 LFM2.5-VL-3B,这是一款专为边缘计算和实时交互设计的视觉语言模型(VLM)。它在保持极低延迟的同时,在屏幕理解、函数调用和指代定位等关键任务上实现了显著的性能飞跃,甚至在多项基准测试中超越了参数量两倍于它的竞争对手。
- 官方说明:https://www.liquid.ai/blog/lfm2-5-vl-3b
- 模型:https://huggingface.co/LiquidAI/LFM2.5-VL-3B
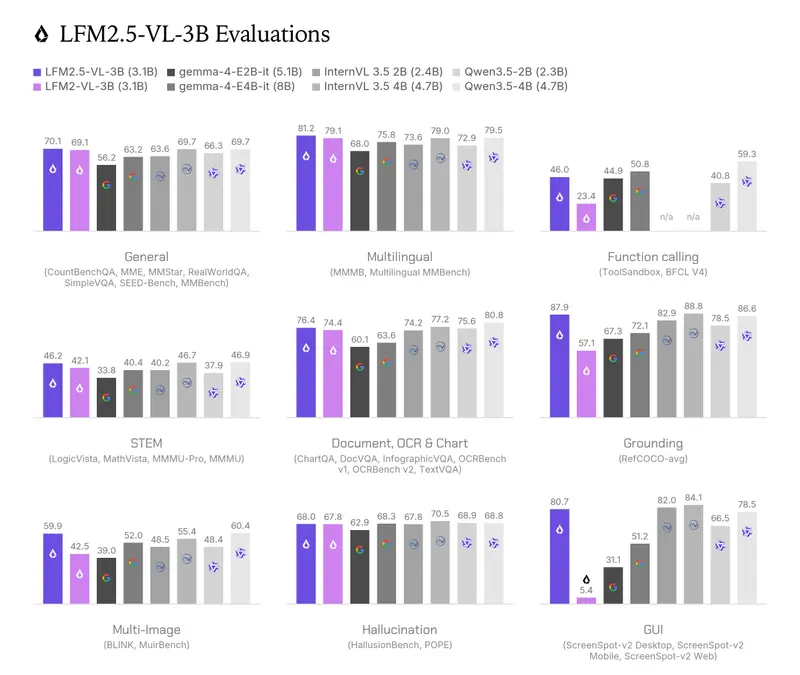
核心亮点:小身材,大智慧
LFM2.5-VL-3B 并非简单的参数堆砌,而是通过架构优化和数据质量提升,实现了“更小、更快、更强”的目标:
- 🖥️ 卓越的屏幕/UI 理解:
在 ScreenSpot-v2 基准测试中取得 80.7 的高分,远超 Gemma-4-E4B (51.2) 和 Qwen 3.5 4B (78.5),接近更大的 InternVL-3.5-4B (84.1)。这使其成为构建自动化 UI 代理、网页导航助手和桌面自动化工具的理想选择。 - 🛠️ 翻倍的函数调用能力:
ToolSandbox 得分从 26.4 飙升至 59.5,BFCL v4 得分提升至 32.5。这意味着模型能更准确地识别何时需要调用外部工具(如搜索、计算器或 API),并生成正确的调用参数,极大地增强了其在实际工作流中的实用性。 - 🎯 精准的指代定位:
RefCOCO precision@1 从 57.1 大幅提升至 87.9。模型现在能更精确地根据自然语言描述在图像中框出特定对象,这对于机器人视觉、辅助技术和交互式编辑至关重要。 - 🖼️ 强大的多图像推理:
在处理多张图片或视频帧时,BLINK 得分提升至 61.5,MUIRBench 得分提升至 58.3,展现了其在复杂视觉场景下的连贯理解能力。
极速推理:无处不在的低延迟
LFM2.5-VL-3B 的设计初衷是让 AI 在本地设备上流畅运行,其推理速度令人印象深刻:
| 平台/设备 | 性能表现 | 备注 |
|---|---|---|
| Apple M5 Max | 228 token/s | 内存占用仅约 3 GB |
| AMD Ryzen AI Max+ 395 | 116 token/s | 针对 AMD NPU/GPU 优化 |
| Galaxy S26 Ultra (手机) | 20 token/s | 实现真正的手机端私有 VLM |
| NVIDIA H100 (服务器) | ~11K token/s | 高并发下吞吐量领先同级别模型 2 倍 |
| 首 Token 延迟 (5帧视频) | ~34 ms | 远快于 Gemma 模型的 ~200 ms |
得益于紧凑的 SigLIP2 视觉编码器和高效的架构,LFM2.5-VL-3B 在首字响应时间(TTFT)上具有巨大优势,特别适合对实时性要求极高的交互式应用。
技术底座:高质量数据与强化学习
- 架构升级:基于 LFM2.5-2.6B 文本基座,集成 SigLIP2 400M NaFlex 编码器,词表大小翻倍至 128K 以更好地支持多语言。
- 数据增强:视觉预训练 Token 规模扩大 4 倍,混合了大量策展的合成数据(图像描述、OCR、指代定位)。
- 后训练优化:采用从更大教师模型蒸馏的知识、Antidoom 训练以及多奖励强化学习(RL),显著提升了模型的指令遵循和工具使用能力。
广泛的应用生态支持
LFM2.5-VL-3B 提供了全方位的部署支持,确保开发者能在任何硬件上轻松落地:
- llama.cpp / GGUF:高效边缘推理。
- MLX:Apple Silicon 原生优化。
- vLLM / SGLang:生产级 GPU 加速服务。
- ONNX:跨平台兼容性。
- WebGPU:可直接在浏览器中运行的演示,无需后端设置。
© 版权声明
文章版权归作者所有,未经允许请勿转载。