模思智能(Moss Intelligence)今日正式推出 MOSS-VL 0708 系列模型,包括基础检查点 MOSS-VL-Base-0708 和指令微调检查点 MOSS-VL-Instruct-0708。作为 OpenMOSS 开源视觉理解生态系统的最新成员,该模型凭借 110 亿参数、256K 超长上下文窗口以及独特的交叉注意力架构,为离线多模态应用提供了一个高性能、高容量的预训练基座。
- MOSS-VL-Base-0708:https://www.modelscope.cn/models/openmoss/MOSS-VL-Base-0708
- MOSS-VL-Instruct-0708:https://www.modelscope.cn/models/openmoss/MOSS-VL-Instruct-0708
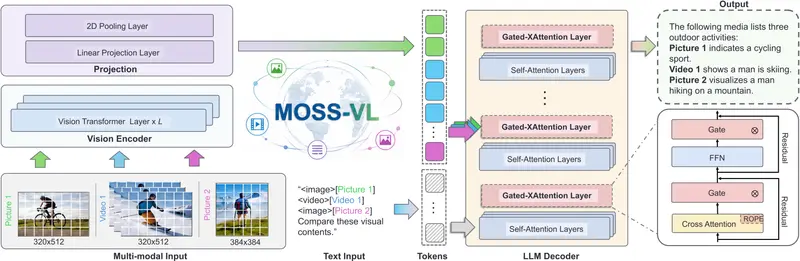
核心亮点:原生动态分辨率与长视频理解
MOSS-VL 0708 并非简单的参数堆叠,而是在架构和数据策略上进行了深度优化,旨在解决传统多模态模型在处理复杂视觉任务时的痛点:
- 🎬 卓越的长视频与时序推理能力:
支持默认最大 256 帧的视频输入,并在采样时注入绝对时间戳。这使得模型不仅能“看”到画面,还能理解事件的顺序、持续时间和节奏,在动作识别和细粒度事件定位任务中表现突出。 - 🖼️ 原生动态分辨率处理:
摒弃了强制缩放或裁剪的传统做法,以原始宽高比和分辨率处理图像和视频帧,最大程度保留视觉细节,特别适合文档解析、OCR 及高精度图表理解。 - 🔄 统一的交错输入流水线:
在同一个上下文中无缝混合处理图像、视频和文本序列,支持复杂的图文交织场景,如带插图的技术手册或多媒体新闻流。 - 🧠 256K 超长上下文窗口:
得益于第四阶段的“退火与长上下文扩展”训练,模型能够处理海量视觉与文本信息,适合长文档分析、长篇视频摘要等高强度任务。
技术架构:解耦视觉与语言的交叉注意力
MOSS-VL-Base-0708 采用基于**交叉注意力(Cross-Attention)**的视觉-语言架构,将视觉编码与语言推理解耦,通过交叉注意力层连接两者。这种设计带来了两大核心技术优势:
- 交叉注意力 RoPE (XRoPE):
将文本 Token 和视觉 Patch 映射到由时间 (t)、高度 (h)、宽度 (w) 定义的统一三维坐标空间中。这为模型提供了一致且精确的空间与时间位置表征,显著提升了空间定位和时间感知的准确性。 - 高容量离线基座:
作为一个纯粹通过多模态预训练构建的基础模型,它提供了强大的通用视觉-语言表征能力,专为后续的监督微调(SFT)、人类对齐(RLHF)及领域自适应预留了广阔的空间。
训练流程:四阶段渐进式进化
为了构建更强大的离线多模态基础,0708 版本采用了严谨的四阶段预训练方案:
| 阶段 | 目标 | 关键动作 |
|---|---|---|
| 第一阶段 | 视觉-语言对齐 | 建立基本的视觉特征与语言 Token 之间的映射关系。 |
| 第二阶段 | 大规模多模态预训练 | 利用海量数据提升模型的通用视觉理解能力。 |
| 第三阶段 | 高质量多模态预训练 | 引入精选的高质量数据,强化逻辑推理与细节捕捉。 |
| 第四阶段 | 退火与长上下文扩展 | 优化长序列处理能力,稳定模型在 256K 上下文下的表现。 |
模型规格与部署
- 参数量:11B (110 亿)
- 精度:BF16
- 上下文长度:256,144 Tokens
- 视觉配置:Patch 大小 16,时间维度 Patch 大小 1,默认 FPS 1.0
- 适用场景:离线多模态理解、文档/视频解析、视觉推理、作为领域适配的预训练基座。
© 版权声明
文章版权归作者所有,未经允许请勿转载。