模思智能(Moss Intelligence)今日正式发布 MOSS-VL-Realtime,这是 OpenMOSS 生态系统中首个专为连续视频流设计的实时检查点。与传统的“先加载完整视频再作答”的离线模型不同,MOSS-VL-Realtime 能够并行处理输入帧并生成文本,实现了真正的流式视觉交互。
- 模型:https://www.modelscope.cn/models/openmoss/MOSS-VL-Realtime
这一突破使得 AI 能够像人类一样,在观看直播、监控画面或实时视频通话时,随时响应提问,并根据不断涌入的新视觉信息动态修正认知。
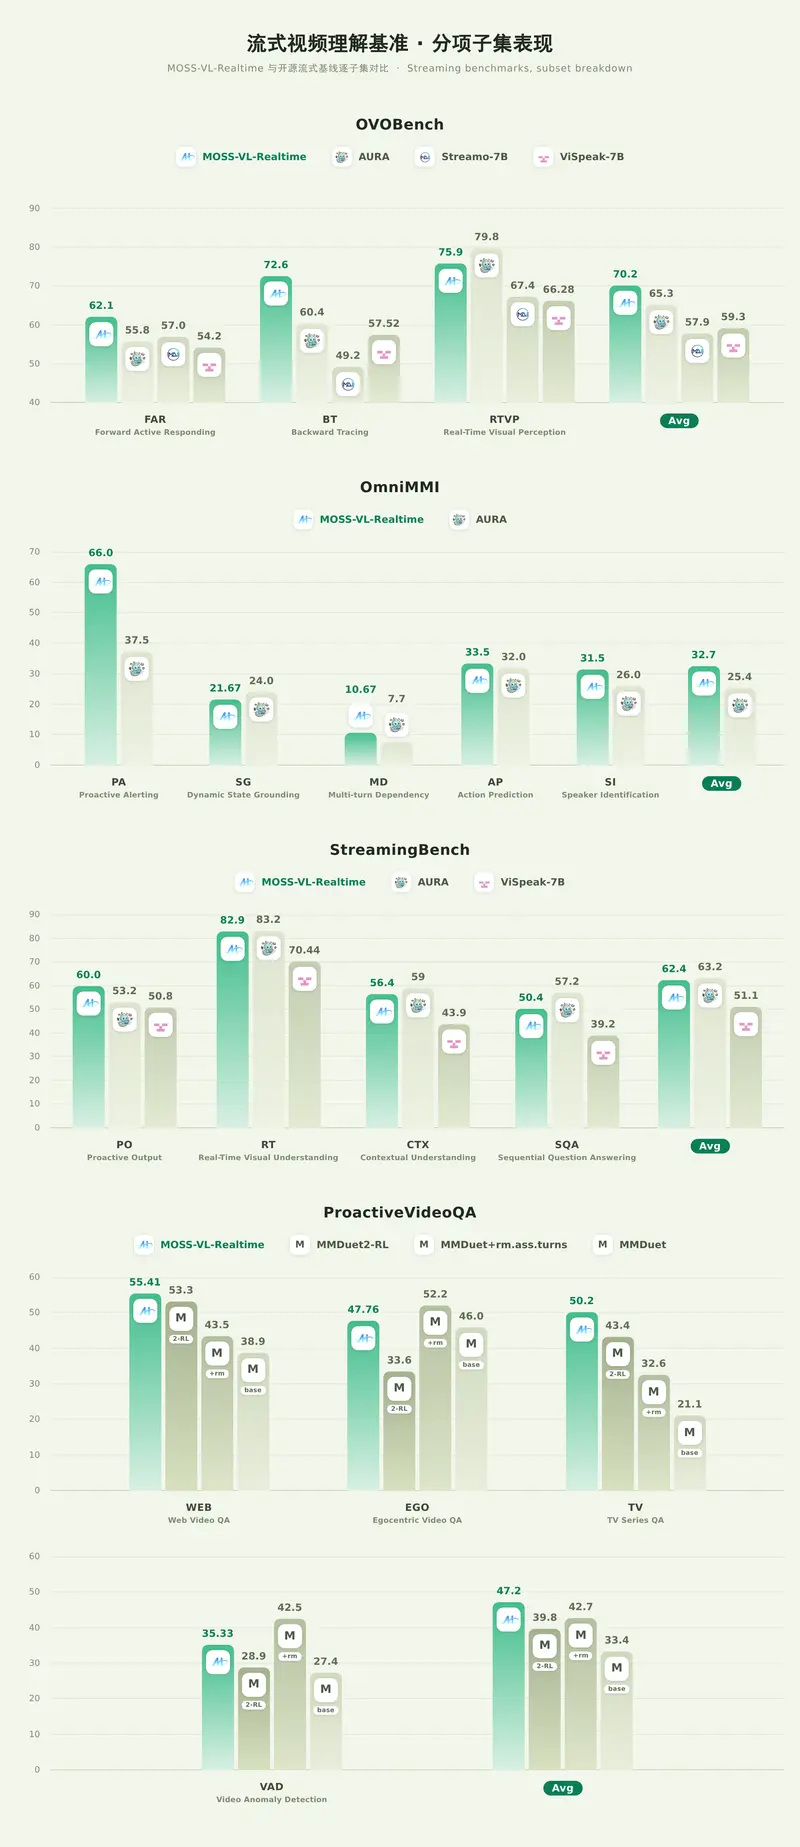
核心特性:从“被动回放”到“主动感知”
MOSS-VL-Realtime 的设计哲学是模拟人类的实时观察过程,具备以下四大关键能力:
- ⚡ 实时流式理解:
无需等待视频结束,模型持续处理传入的每一帧。用户可以在视频播放的任意时刻插入问题,模型将基于截至目前已观察到的所有帧进行即时回答。 - 🤐 主动静默(Active Silence):
这是实时交互的一大创新。当模型判断当前视觉信息不足以回答问题,或没有发生有意义的视觉更新时,它会输出<|silence|>标记并继续观察,而不是强行生成幻觉或无关内容。这极大地提升了交互的自然度和可信度。 - 🔄 动态修正:
随着新帧的到来和场景的演变,模型能够自我修正先前的回答。例如,如果最初识别为“一只猫”,随后镜头拉近发现是“一只老虎”,模型会自动更新其认知并给出更准确的描述,而非固守初始解释。 - ⏱️ 带时间戳的精准推理:
每个流式帧都关联一个绝对时间戳。结合 XRoPE(交叉注意力旋转位置编码),模型将视觉 Patch 映射到由时间 (t)、高度 (h) 和宽度 (w) 定义的三维空间中,从而精确推理事件的顺序、持续时间、节奏及细粒度的时间定位。
技术架构:解耦与统一
MOSS-VL-Realtime 继承了 MOSS-VL 系列的强大基因,并在架构上针对实时性进行了优化:
- 交叉注意力架构:将视觉编码与语言推理解耦。传入的视觉内容可以直接融入正在运行的生成上下文中,打破了离线模型严格的“编码-解码”壁垒。
- 统一的位置表示:通过 XRoPE,为图像、离线视频和实时流式视频提供了统一的空间与时间坐标,确保了模型在不同场景下的一致性表现。
- 256K 超长上下文:保留了庞大的上下文窗口,支持长时间的视频流记忆,确保模型不会在长对话中“遗忘”早期的关键视觉线索。
模型配置
| 项目 | 值 |
|---|---|
| 参数量 | 11B (110 亿) |
| 张量类型 | BF16 |
| 上下文长度 | 256,144 Tokens |
| 视觉 Patch 大小 | 16 |
| 时间维度 Patch 大小 | 1 |
| 默认视频帧率 | 1.0 FPS |
| 实时会话限制 | 每个模型实例仅支持一个活跃的实时会话 |
应用场景
MOSS-VL-Realtime 的发布为多个实时视觉交互场景打开了大门:
- 智能安防监控:实时分析监控画面,仅在检测到异常行为(如入侵、跌倒)时发出警报,平时保持静默。
- 直播内容辅助:为视障人士提供实时的直播画面解说,或在电商直播中即时回答关于商品细节的提问。
- 远程协作与指导:在远程维修或医疗指导中,专家可以通过 AI 实时获取现场画面的关键信息,并随时介入提问。
- 交互式游戏与元宇宙:作为 NPC 的视觉大脑,使其能根据玩家的实时动作和环境变化做出自然反应。
© 版权声明
文章版权归作者所有,未经允许请勿转载。