SoMark 团队开源了文档解析模型OXR(Optical Everything Recognition)。该模型参数量为 1.3B,将 PDF 和文档图片高效解析为 Agent-Friendly 的结构化数据(Markdown 或 JSON),并同步输出版面分析结果。
- GitHub:https://github.com/SoMarkAI/OXR
- Demo:https://free-oxr.somark.cn/
- Hugging Face:https://huggingface.co/SoMarkAI/OXR-1.0
- ModelScope:https://modelscope.cn/models/SoMark/OXR-1.0
- API:https://docs.somark.cn/api-reference/oxr
核心架构与技术优势
OXR 从零开始进行预训练,并在后训练阶段引入了面向文档解析的递归自我改进(RSI)训练范式。其技术设计主要围绕解析精度、处理速度与业务适配灵活性展开。
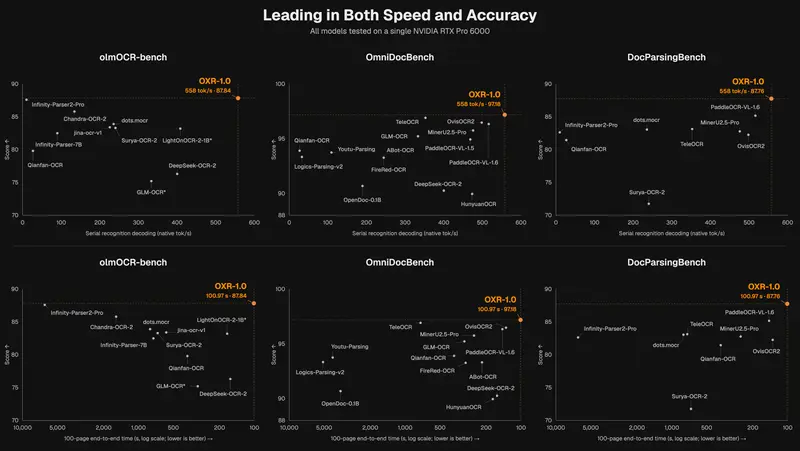
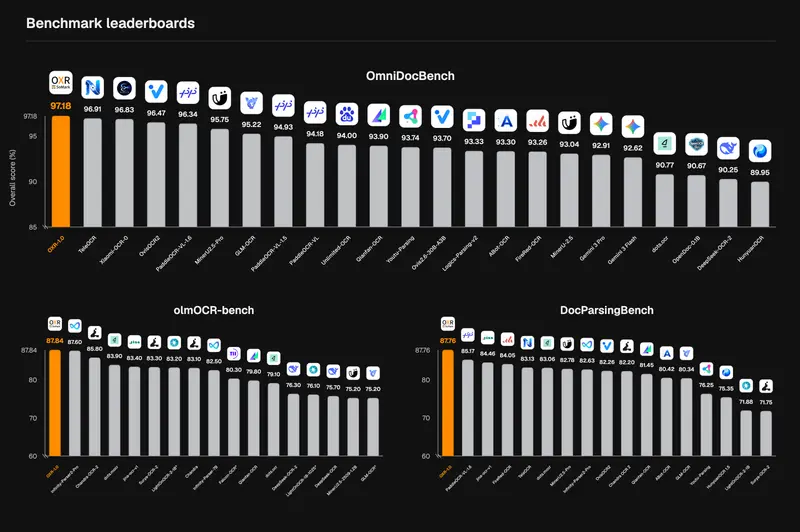
- 高精度与高解析速度:在 OmniDocBench、olmOCR-Bench 和 DocParsingBench 三大主流基准测试中,OXR 的综合评分位列第一,其中表格解析子项优势明显。在任务层面重构工作架构后,其在 RTX PRO 6000 硬件环境下的速度测试中,位居开源文档解析模型首位。
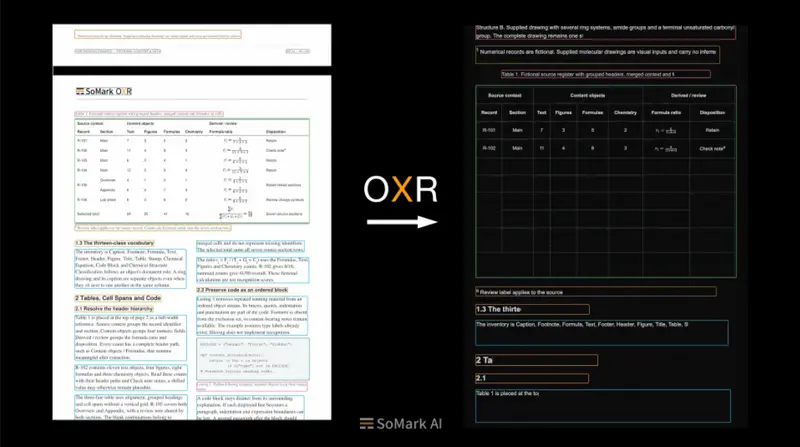
- 丰富的文档元素识别:模型可识别公式、表格、化学方程式、化学结构式和代码块等 13 类文档元素,并提供对应的版面坐标。面对 A3 试卷、报纸等复杂版面,以及竖排文字和手写内容,均能保持稳定的解析效果。
- 独立可插拔的版面分析模块:不同业务对文档元素类别、区域边界和内容分组的定义往往存在差异。OXR 首次将版面分析设计为独立模块,并将阅读顺序(Reading Order)判断并入识别阶段。用户可直接使用内置模型,也可按业务需求接入自有版面分析模型,以最小成本实现多场景适配。
RSI 闭环训练机制
针对文档解析这类具备“标准答案”的任务,OXR 引入了一套工程化的 RSI(递归自我改进)方案。
该机制能够自动识别模型输出的错样本与弱样本,并针对性地进行优化和提升。整个过程无需人工参与数据标注,有效降低了数据清洗成本,使核心模型的迭代速度得到显著提升。
部署环境与启动方式
OXR 提供了免费 API 供快速测试,同时也支持完整的本地化部署。
1. 免费 API 体验
官方提供无需注册或申请密钥的免费 API 服务(支持 somark.ai 及国内镜像 somark.cn)。用户可直接使用 SoMark 官方的 CLI 工具(如 somark-py 或 somark-js),替换 Base URL 后即可调用解析接口,输出 Markdown 或 JSON 格式数据。
2. 本地部署环境要求
- 操作系统:Linux
- GPU:英伟达(支持 BF16 精度)
- 驱动:兼容 CUDA 13.0 的 NVIDIA 驱动
- Python:3.12(用于模型下载与源码启动)
- 显存要求:单卡 24GB 起步(适用于低并发试用),推荐单卡 ≥48GB(适用于长文档或较高并发场景)
3. 服务启动方案
- Docker 启动(推荐):通过构建
allinoneDockerfile,可一次性启动所有依赖服务。映射端口后,即可通过本地 8000 端口访问可视化 Demo 或 API 文档。 - 源码启动:需分别独立启动三个服务。首先启动 OXR 模型服务(基于 vLLM 及提供的 out-of-tree 插件),其次启动 Layout Analysis 模型服务,最后配置
config.yaml并启动文档解析 API 服务。
可视化调试与接口集成
本地服务启动后,用户可通过浏览器访问 http://localhost:8000/demo 打开可视化界面。
在该界面中,上传 PDF 或图片后,可直观查看原文件、Markdown 预览、解析源码、版面检测框以及阅读顺序,并支持直接下载 Markdown 结果。
对于工程化集成,OXR 的 API 接口与 SoMark 官方文档解析 API 完全兼容。开发者可直接使用封装好的 Python 或 JavaScript SDK,通过指定本地 baseURL 和 dummy api_key,将 OXR 无缝接入现有的文档处理流水线中。
© 版权声明
文章版权归作者所有,未经允许请勿转载。