Google DeepMind 正式推出 AlphaGenome 2,一款能够预测特定细胞类型中遗传变异效应的 DNA 基础模型。与此前在批量组织数据上进行平均的前代模型不同,AlphaGenome 2 引入了“条件序列到功能”(Conditional Sequence-to-Function)架构,能够读取 1 Mb 的 DNA 序列并结合目标细胞状态,精准解析密切相关的细胞类型间的细微差异。该模型目前通过 API 向非商业研究免费开放。
- 官网:https://www.alphagenomedocs.com
- GitHub:https://github.com/google-deepmind/alphagenome
核心架构:从并行轨道到条件化调制
AlphaGenome 2 采用 U-Net 风格设计,包含卷积编码器、11 个 Transformer 块及解码器。其技术演进主要体现在对细胞状态的建模方式上:
- 条件化机制:模型接收一个 256 维的细胞状态嵌入向量,通过 FiLM(Feature-wise Linear Modulation)层在编码器、Transformer 和解码器中调制激活值。DeepMind 的研究表明,仅对解码器或输出层进行条件化带来的增益微乎其微,真正的性能突破源于对编码器和 Transformer 的深度条件化。
- 多模态输出:单次调用即可预测 RNA 覆盖度、CAGE、剪接、染色质可及性、组蛋白标记、转录因子(TF)结合、接触图以及新增的 CpG 甲基化等指标。
- 输入规格:支持人类或小鼠基因组,处理窗口为 1 Mb(1,048,576 bp)。
训练策略:四阶段蒸馏与单细胞映射
为了实现对未见过的单细胞数据集的零样本适应,AlphaGenome 2 的训练分为四个关键阶段:
- 预训练:在批量数据及来自 36 项研究的 3,977 条单细胞 RNA 和 ATAC 伪批量轨道上进行基础训练。
- 条件精炼:仅微调嵌入层和 FiLM 层,强化模型对细胞状态的敏感度。
- 知识蒸馏:使用突变输入序列,将 8 个教师模型的知识蒸馏至单个学生模型中,提升推理效率。
- 后训练映射:将在超过 1 亿个人类 scRNA-seq 谱(主要来自 CELLxGENE)上训练的表达编码器,映射到冻结模型的条件空间。这使得研究人员可以直接传入原始计数数据获取条件嵌入,每次调用最多支持 256 个细胞。
基准测试表现
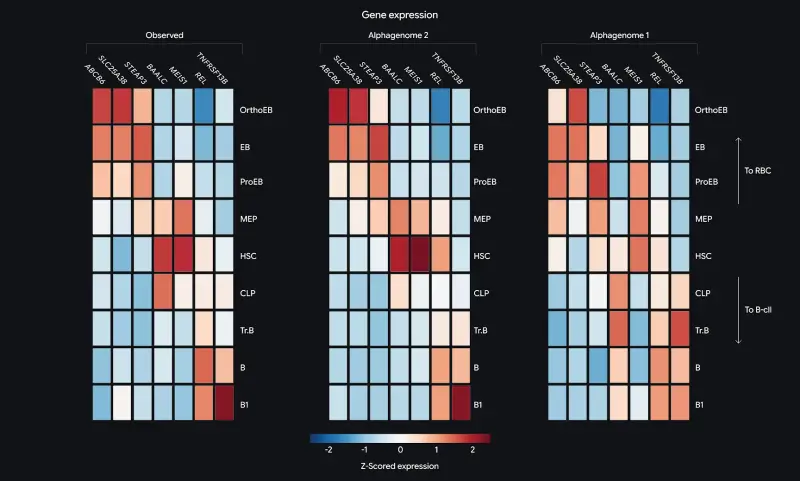
AlphaGenome 2 在多项关键基准上显著优于微调后的 AlphaGenome 1、Borzoi 和 Scooby 等竞品:
| 评估维度 | 指标/场景 | AlphaGenome 2 表现 | 对比基线 (AlphaGenome 1/Scooby) |
|---|---|---|---|
| 因果变异召回 | TenK10K sc-eQTL (90% 精确率) | 30% | 16% (微调后 AG1) |
| 效应方向召回 | TenK10K sc-eQTL | 43% | 23% (微调后 AG1) |
| 增强子-基因链接 | ENCODE-rE2G CRISPRi (AUPRC) | 0.78 | 0.73 (AG1), 0.61 (Borzoi) |
| 远距离增强子 | 距离 100-2,500 kb | 0.62 | 0.48 (Borzoi) |
| 跨组织表达 | GTEx (中位 Pearson r) | 0.71 | 0.61 (AG1) |
| 未见队列适应 | 帕金森病队列 (召回率) | 41% | 17% (队列调优 Scooby) |
注:在可及染色质区域之外,模型的符号预测 AUROC 仅为 0.63,显示出其在非活跃区域的局限性。
开发者资源与访问权限
目前,AlphaGenome 2 仅通过托管 API 提供服务,权重将在最终论文发表时公开。
- API 访问:非商业用途可通过
alphagenomePython 包免费获取 API 密钥;商业研究处于私人预览阶段。 - 预计算图谱:DeepMind 同步发布了两个大型数据集供下载:
- 覆盖 640 种原代细胞条件下的增强子-基因链接图谱。
- 在 510 种条件下对约 700 万个常见变异及 GWAS 变异的评分数据。
AlphaGenome 2 的发布标志着基因组学 AI 从“组织平均水平”向“单细胞分辨率”的重大跨越,为精准医疗和复杂疾病机制研究提供了更细粒度的工具支持。
© 版权声明
文章版权归作者所有,未经允许请勿转载。